Schockierend: Google hat RSI entschlüsselt? KI erlernt unbegrenzte Evolution durch „Träumen“
Google hat RSI möglicherweise bereits entschlüsselt!
Gerade eben hat Google gemeinsam mit Google DeepMind, der Universität Maryland und der Universität Virginia eine bahnbrechende Arbeit veröffentlicht.
Diesmal zeigen sie einen völlig anderen Weg für RSI: Die KI kann sich durch Träumen selbst weiterentwickeln?
Google lässt den Agenten jeden seiner Schritte als Baum speichern und dann in diesem Baum „träumen“.
Im Traum entwickelt er bessere Explorationsstrategien, um dann in der realen Welt weiterzuarbeiten.
Link zur Arbeit: https://arxiv.org/abs/2609.14858
Die Wirkung von Dream-RSI ist beeindruckend:
Bei Aufgaben zur Algorithmenoptimierung benötigen gängige evolutionäre Suchsysteme 51200 Generationen, um das gleiche Niveau zu erreichen – Dream-RSI erreicht dies bereits nach 317 Aufrufen.
Beim Kreisausfüllproblem erreicht es den stärksten Rekord von Googles eigenem AlphaEvolveV2.
Bei der Optimierung von GPU-Kerneln sinkt die Anzahl der erforderlichen Generierungen um das 2,43-fache, um die gleiche Leistung zu erzielen.
Die zugrundeliegenden Gewichte wurden nicht verändert, Dream-RSI funktioniert sowohl mit Gemini 3.1 Pro als auch mit Gemini 3.7 Flash.
Zudem gibt es eine überraschendere Erkenntnis: Wenn Menschen der KI eine Richtung vorgeben, ist das Ergebnis schlechter als ohne Vorgaben.
Sobald die Arbeit auf arXiv veröffentlicht wurde, brach auf X eine Welle der Begeisterung aus. Der Nutzer Mark Kretschmann rief aus: „Google hat möglicherweise gerade das rekursive Selbstverbesserungsprinzip entschlüsselt!“
Der Erstautor der Arbeit, Tong Zheng, ist Doktorand im zweiten Jahr an der Universität Maryland und kam diesen Sommer erst als studentischer Forscher zu Google. Hinter ihm steht ein 17-köpfiges Autorenteam aus DeepMind-Forschern und Lehrstuhlinhabern.
Um rekursive Selbstverbesserung zu erreichen, müssen Agenten lernen zu träumen. Die Geschichte ist die Welt, in der sie träumen.
Tong Zheng hat auf Hugging Face einen Satz hinterlassen, der den Kern der gesamten Arbeit darstellt.
Die Geschichte ist die Welt, in der es träumt
Dream-RSI löst das größte Engpassproblem im gesamten Bereich der evolutionären Suche.
Systeme wie AlphaEvolve haben bereits bewiesen, dass Codierungsagenten durch evolutionäre Suche Algorithmen entdecken können, die Menschen nicht finden konnten. Sie haben jedoch eine entscheidende Schwäche: Ihre Explorationsstrategien sind vollständig von Menschen fest vorgegeben.
Welchem Zweig mehr Rechenleistung zugewiesen werden soll, welcher Zweig frühzeitig abgeschnitten werden soll und wann Parallelisierung gestartet wird, wird vollständig von Ingenieuren im Voraus festgelegt. Bei großen Suchräumen verschwenden feste Strategien Rechenleistung in Sackgassen und lernen nicht aus Fehlern.
Ist es also möglich, die Strategie selbst evolvieren zu lassen? Theoretisch ja, aber das Problem liegt in den hohen Bewertungskosten.
Um ein Kandidatenstück Code zu bewerten, reicht ein einziger Lauf, um seine Qualität zu bestimmen. Um eine Explorationsstrategie zu bewerten, muss man den Agenten jedoch hunderte oder tausende Runden von Anfang an durchlaufen lassen, um die Qualität der Ergebnisse am Ende zu prüfen und der Strategie eine Bewertung zu geben. Bei jeder Änderung der Strategie muss der gesamte Entdeckungsprozess neu ausgeführt werden, was mehrere Tage pro Bewertung dauert – niemand kann diesen Aufwand tragen.
Die Lösung von Dream-RSI besteht darin, alle durchgeführten Prozesse zu speichern und bei der Bewertung neuer Strategien keine erneuten Läufe durchzuführen, sondern die alten Prozesse direkt wiederzuverwenden.
Genauer gesagt teilt es die beiden Ebenen „Arbeiten“ und „Entscheiden, wie man arbeitet“ auf.
- Die untere Ebene ist der ausführende „Discovery Agent“, der von Gemini 3.1 Pro oder 3.7 Flash angetrieben wird. Er erhält jedes Mal einen Arbeitsbereich, liest den Kontext, erstellt eine neue Version des Kandidatencodes und lässt ihn von einem Bewerter bewerten.
- Die obere Ebene ist eine schlanke Orchestrierungsebene mit der „Explorationsstrategie“ (einem Stück Python-Code), die festlegt, von welchem Knoten in jeder Runde weitergearbeitet wird, wie viele parallele Versuche gleichzeitig gestartet werden und wann die Arbeit abgebrochen wird.
Das zugrundeliegende Modell bleibt unverändert, nur dieser Strategiecode wird selbst weiterentwickelt.
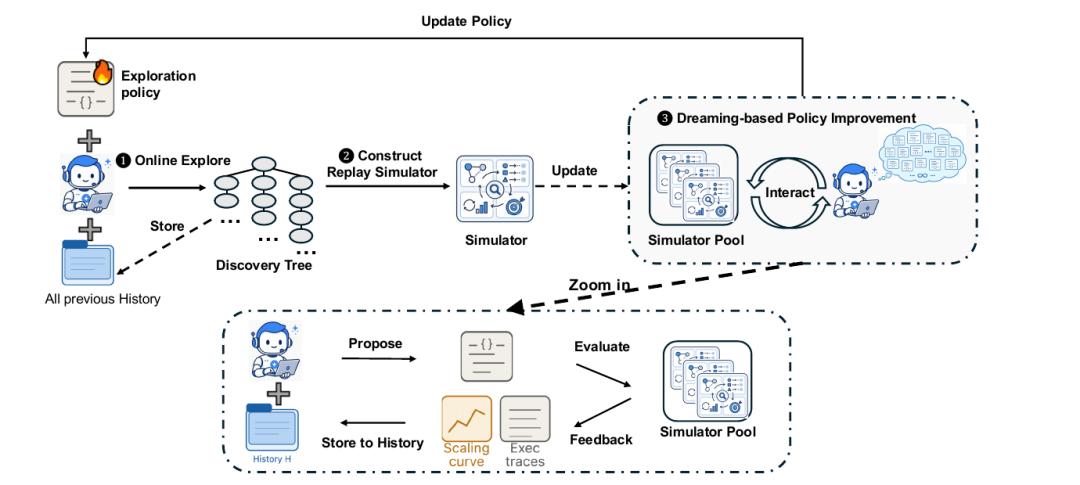
Jedes Ergebnis der echten Exploration wird in einem „Entdeckungsbaum“ gespeichert. Der Wurzelknoten ist der ursprüngliche Arbeitsbereich, jeder untergeordnete Knoten speichert den vollständigen Zustand eines Versuchs, einschließlich Schnappschüssen des Dateisystems, erzeugten Ergebnissen, Bewertungsdiagnosen und Bewertungen.
Dieser Baum ist der Simulator.
Die Strategie muss nur eine Art von Entscheidung treffen: Von welchen Knoten weitergearbeitet wird und wie viele parallele Versuche gleichzeitig gestartet werden. Das Ergebnis jedes Schritts von einem Knoten aus ist bereits im Baum gespeichert.
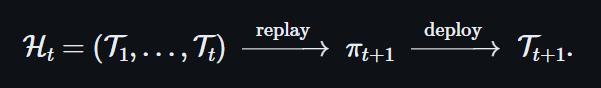
Wenn die Strategie also iteriert werden soll, muss kein Code mehr in der realen Umgebung ausgeführt werden – man kann einfach den bereits gewachsenen Baum durch die Geschichte neu durchlaufen:
Um zu testen, „diesen Weg zwei Schritte weiterzugehen“, liest man die entsprechenden Einträge im Baum; um zu testen, „diesen Weg früher aufzugeben“, liest man nur weniger Knoten.
Der gesamte Bewertungsprozess ruft kein einziges Modell auf, führt keine einzige Codezeile aus und liest nur die gespeicherte Geschichte.
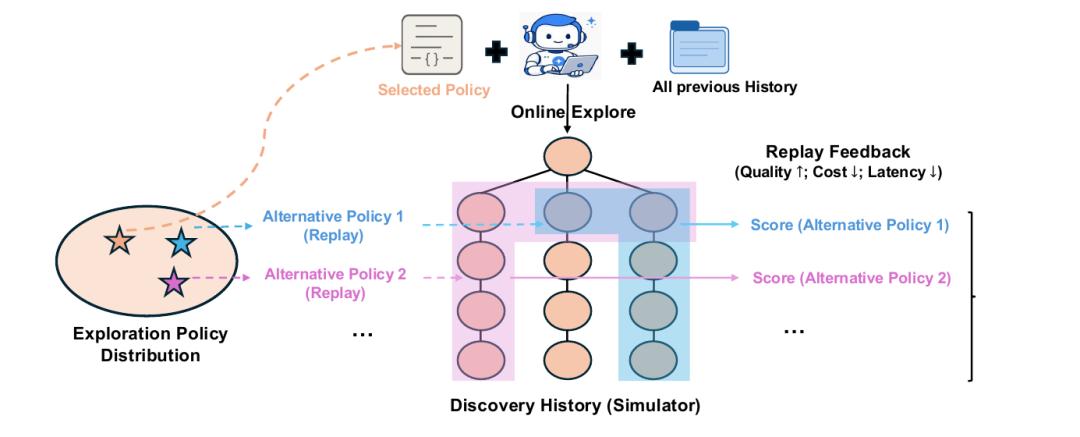
Die Arbeit nennt diesen Mechanismus „Träumen“. Wie ein Schachspieler, der eine Partie nachbespricht, muss man nicht das Brett neu aufbauen und noch einmal spielen – es reicht, die Partieaufzeichnung zu lesen.
Der Betriebszyklus von Dream-RSI
Aufgrund dieser Erkenntnis hat Google das Dream-RSI-Framework entwickelt. Sein Zyklus der Selbstverbesserung gliedert sich in drei Phasen:
1. Echte Exploration: Die aktuellste Explorationsstrategie

leitet den Agenten an und lässt ihn in der echten Umgebung laufen (z. B. Aufrufen von LLMs, Kompilieren und Ausführen von Code). Alle Pfade, Entscheidungen und Ausführungsrückmeldungen aus der Exploration werden als neuer strukturierter Explorationsbaum aufgezeichnet

und zur historischen Datenbank hinzugefügt

.
2. Erstellen des Simulators: Die aktualisierte historische Datenbank

wird in einen wiederverwendbaren „Pool von Wiedergabesimulatoren“ umgewandelt.
3. Strategieverbesserung durch Träumen: Ein spezieller LLM-Strategieentwicklungs-Agent beginnt in diesem Simulator intensiv zu „träumen“. Er ändert und überschreibt ständig den Code der Explorationsstrategie, erzeugt Tausende von Kandidatenstrategien und gibt sie schnell auf dem Wiedergabesimulator wieder.
Die Bewertung im Traum besteht aus drei Teilen: Erstens die beste Bewertung, die in dieser Runde des Traums gefunden wurde, zweitens die Abzugskosten entsprechend der Anzahl der Versuche und drittens eine Parallelisierungsbelohnung, die Strategien fördert, die mehrere Versuche gleichzeitig in einer Runde ausführen.
Eine Strategie mit hoher Bewertung bedeutet, dass sie schnell, effizient und kostengünstig arbeitet.
Für die Änderung der Strategie ist ein weiterer „Strategieentwicklungs-Agent“ zuständig.
Er beobachtet drei Dinge: Die Spuren und Bewertungen der aktuellen Strategie im Traum, die Rückmeldungen zu früheren Versionen der Änderungen und den gesamten Entdeckungsbaum. Danach schreibt er den Strategiecode direkt um.
In einer Runde werden mehrere Versionen erstellt, jede Version wird zurück in den Traum geschickt, um bewertet zu werden, und die Version mit der höchsten Bewertung wird die offizielle Strategie für die nächste Runde.
Das bedeutet, dass die untere Grenze der neuen Strategie „keine Verschlechterung“ ist, während die obere Grenze „unbegrenzte Weiterentwicklung“ ist.
Der Flywheel-Effekt von RSI schließt sich damit.
Warum wird diese Strategie nie schlechter?
In der Phase der Offline-Verbesserung durchläuft der Strategieentwicklungs-Agent mehrere Runden von Code-Iterationen. Da die aktuelle Strategie

selbst im Kandidatenpool enthalten ist, wird die neu geschriebene Strategie nur dann ausgewählt und eingesetzt, wenn ihre kombinierte Wiedergabebewertung auf dem Simulator (die Explorationsqualität, Rechenkosten und Parallelisierungseffizienz ausgleicht) höher ist als die der aktuellen Strategie.

Mathematisch gesehen ist die Leistung der neuen von Dream-RSI