Sensationelle Entdeckung: GPT-6 hat einen Durchbruch bei der Embodied Intelligence erreicht – wie kann China den Verteidigungskampf im Bereich der Embodied Intelligence bestreiten?
Kürzlich wurde ein anonymer Simulationsbewertungsbericht auf GitHub veröffentlicht, der in der Szene der verkörperten Intelligenz eine enorme Aufmerksamkeit erregte: Die Architektur mit gemischtem GPT-6 Astra erreichte 62,6 Punkte, während der Zweitplatzierte lediglich 38,26 Punkte erzielte.
Ein Leistungsunterschied von 64 %. Dies ist keine Feinabstimmungsoptimierung, sondern ein dimensionsreduzierender Angriff auf Architekturebene.
Die Studie nutzte GPT-6 Astra nicht direkt, um Roboterarme zu steuern. Sie ging einen klügeren Weg: GPT-6 Astra liefert Urteile und Korrekturen auf semantischer Ebene und bildet eine komplementäre Architektur mit der physikalischen Rauminteraktion und Aktionspriorität von π₀,₅.
Wie wurde diese Bewertung durchgeführt?
Die Verfasser des Berichts sind Forscher des Teams von Galaxy Universal, der Erstautor ist Doktorand von Professor WANG He, Gründer und CTO von Galaxy Universal. Dies ist keine zufällige Demonstration, sondern ein streng ausgerichteter Closed-Loop-Kontrollvergleichsexperiment.
Die Studie analysierte zwei Closed-Loop-Kontrollarchitekturen für die simulierte Doppelarmoperation:
Direct-Modus: Ohne Ausführung von π0.5 sieht GPT-6 Astra direkt die Bildsignale von drei Kameras und den Roboterzustand, gibt die Pose der Enden der beiden Arme sowie das Öffnen und Schließen der Greifer aus und führt jeweils 1 bis 5 Kontrollschritte aus.
Gemischter Modus: Zu jedem Entscheidungszeitpunkt generiert π0.5 zuerst 50 Schritte an Kandidatenaktionen. GPT-6 Astra betrachtet dasselbe Bild, den Ausführungsverlauf sowie die zu den Kandidatenaktionen gehörenden Doppelarm-Trajektorien und wählt dann eine von zwei Optionen: Entweder übernimmt es die ersten 1 bis 15 Schritte von π0.5, oder es gibt selbst 1 bis 5 Schritte an End-Pose-Korrekturen aus. Nachdem dieser Abschnitt abgeschlossen ist, wird das neue Bild betrachtet und die Entscheidung neu getroffen.
Diese Architektur ist eigentlich sehr einfach. Der Erstautor erwähnte im Bericht auch, dass dieser TopK-Ansatz der „Auswahl von Kandidatenaktionen“ bei Branchenaustauschen bereits mehrfach diskutiert wurde. Dies ist jedoch das erste Mal, dass tatsächlich ein Größenunterschied bei der Ausführung erzielt wurde.
Die Ergebnisse sind eindeutig. Der gemischte Modus erreichte eine Erfolgsrate von 48 % und einen durchschnittlichen Punktwert von 62,60, wobei der durchschnittliche Punktwert den des Zweitplatzierten sogar um 64 % deutlich übersteigt.
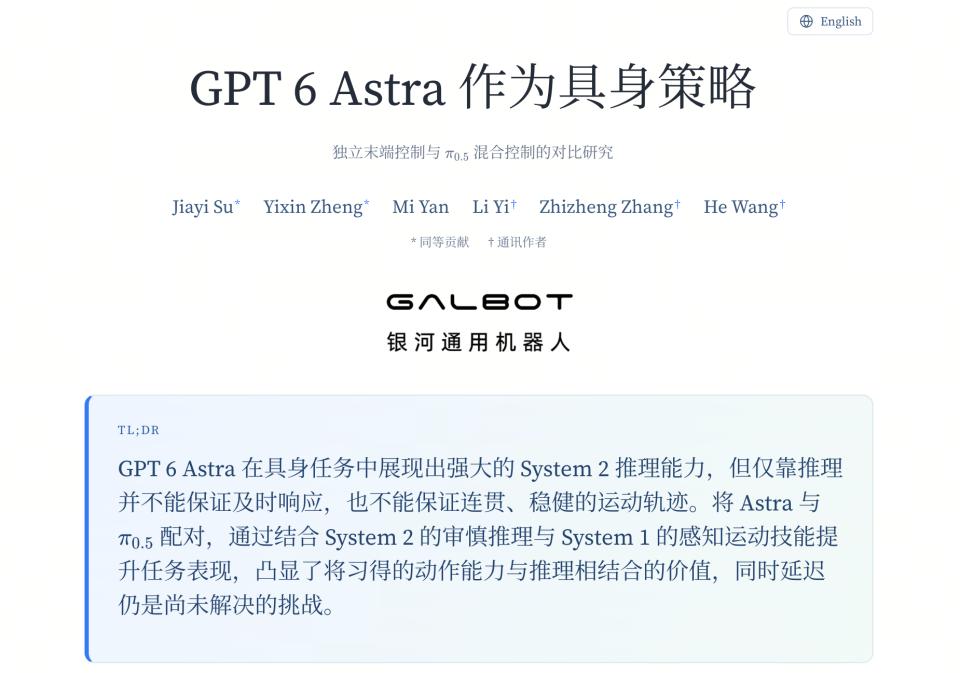
RoboDojo: Deutliche Steigerung der Erfolgsrate nach der Integration von GPT-6 Astra
Zuerst das RoboDojo-Experiment.
Das Team wählte 10 Arten komplexer Roboterbedienaufgaben aus, darunter das Ordnen von Schreibtischen, das Klassifizieren von Objekten nach Sprache, das Sortieren von Zahlen, das Einpacken in Kisten, das Bauen von Türmen, das Ziehen von Mahjong-Steinen, das Falten von Kleidung und das Einlegen von Flaschen in Eimer. Jede Aufgabe wurde 5 Mal getestet, insgesamt 50 Mal.
Für das Experiment wurden zwei Szenarien festgelegt.
Eines ist GPT-6 Astra Direct, bei dem Astra Roboteraktionen direkt basierend auf visuellen Signalen, Eigenzustand und Aufgabenziele generiert; das andere ist π0.5+Astra, bei dem das Roboter-VLA-Modell π0.5 die Aktionen liefert, Astra die Umgebung und die Kandidatenaktionen beobachtet und bei Bedarf Korrekturen vornimmt.
Der Unterschied in den Ergebnissen ist offensichtlich.
Astra Direct war in 13 von 50 Aufgaben erfolgreich, die Erfolgsrate betrug 26 %, und der durchschnittliche Punktwert von 48 Aufgaben mit vollständigen nativen Bewertungen lag bei 37,81.
Nach der Integration von π0.5 stieg die Anzahl der erfolgreichen Aufgaben auf 24, die Erfolgsrate erreichte 48 % und der durchschnittliche Punktwert stieg auf 62,60. Noch bemerkenswerter ist, dass Astra nur 14,4 % aller ausgeführten Kontrollschritte modifizierte.
Das heißt, die meisten Aktionen wurden weiterhin von π0.5 ausgeführt, Astra ist hauptsächlich an wichtigen Knotenpunkten für das Verständnis der Aufgabe, die Beurteilung des aktuellen Zustands und die Entscheidung, ob eine Korrektur erforderlich ist, verantwortlich.
Diese Gruppe von Experimenten zeigt zunächst, dass die beiden Arten von Modellen eine deutliche Komplementarität aufweisen.
Astra ist am besten in semantischem Verständnis, visueller Erkennung, Beurteilung räumlicher Beziehungen und Aufgabenplanung. Bei Aufgaben wie „Objektklassifizierung“ erzielte Astra Direct sogar 100 Punkte; wenn es um fehlgeschlagene Greifversuche, übersehene Objekte oder veränderte Umgebungen geht, kann es den Standort erneut beobachten und dann die nächste Aktion bestimmen.
Aber bei Aufgaben wie dem Bauen von Türmen oder dem Ziehen von Mahjong-Steinen, die feinen Kontakt, stabilen Greifen und kontinuierliche Steuerung erfordern, treten die Schwachstellen großer Modelle schnell zutage.
Astra Direct erreichte im Turmaufbau-Durchschnitt nur 12 Punkte, beim Ziehen von Mahjong-Steinen 0 Punkte. Das Modell kann wissen, wo der Holzblock platziert werden soll, ist aber möglicherweise nicht in der Lage, den Fallpunkt, die Reibung und die Kollision stabil zu steuern.
Nach der Integration von π0.5 stieg der Punktwert für den Turmaufbau von 12 auf 64, der für das Ziehen von Mahjong-Steinen von 0 auf 40, und Aufgaben wie das Falten von Kleidung und das Einlegen von Flaschen in Eimer verbesserten sich ebenfalls deutlich.
Dies ist die wichtigste Information des Berichts: Große Modelle sind bereits in der Lage, in die Strategieebene von Robotern einzudringen, aber das Verständnis der physischen Welt und die Bedienung der physischen Welt sind nach wie vor zwei unterschiedliche Fähigkeiten.
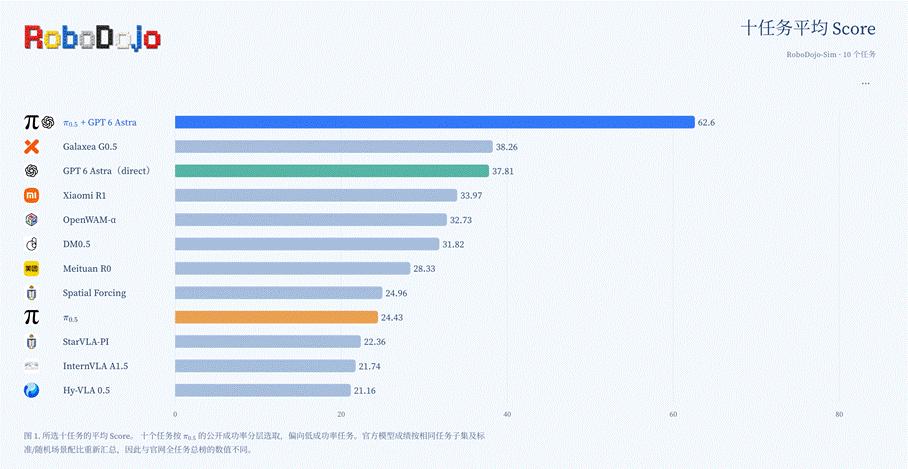
RoboLab: Weitere Überprüfung der Fähigkeiten bei Aufgaben mit semantischem Verständnis
Das RoboLab-Experiment zeigte weiter die Vorteile von Astra bei einer anderen Art von Aufgaben und untersuchte das Verständnis generischer Roboterstrategien für visuelle Signale, Objektbeziehungen, Aufgabenanweisungen und räumliche Strukturen. Das Team wählte 10 Arten von Aufgaben aus, jede wurde 5 Mal bewertet, insgesamt 50 Mal, darunter das Einlegen von Blöcken in Behälter, das Suchen und Bewegen von Kürbissen in Unordnung, das Stapeln von Blöcken in einer festgelegten Reihenfolge, das Anpassen der Ausrichtung von Bechern und das Einlegen verschiedener Objekte an festgelegte Positionen.
Die Ergebnisse sind sehr herausragend.
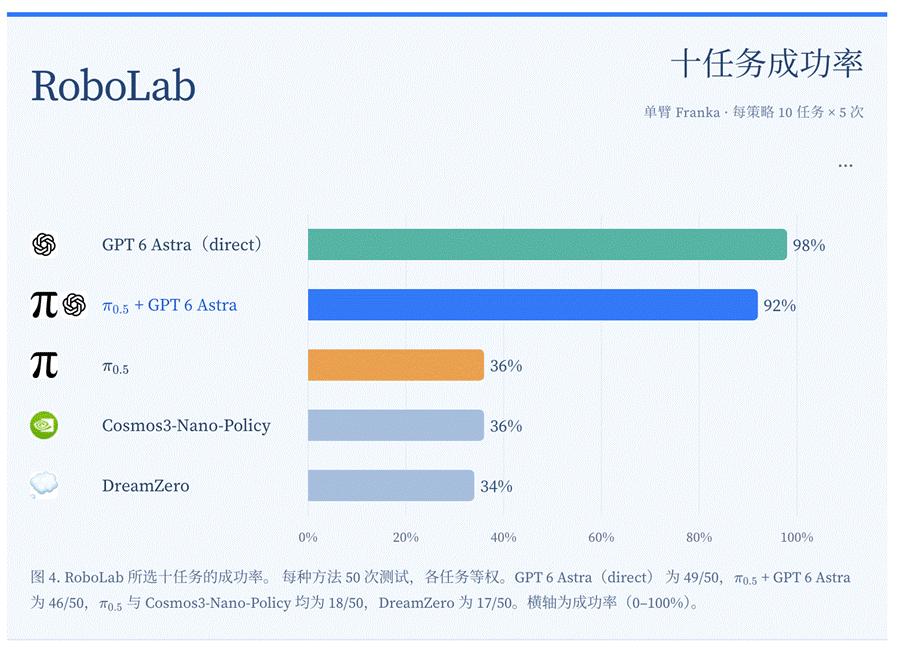
GPT-6 Astra Direct war in 49 von 50 Experimenten erfolgreich, die Erfolgsrate betrug 98 %; Astra+π0.5 absolvierte 46 Mal erfolgreich, die Erfolgsrate lag bei 92 %. Als Referenz absolvierte π0.5 in derselben Statistik 18 Mal, Cosmos3-Nano-Policy 18 Mal und DreamZero 17 Mal.
Besonders bemerkenswert ist, dass Astra keine zusätzliche Schulung für diese spezifischen Aufgaben erhielt. Das Modell beurteilt anhand des aktuellen Bildes, des Roboterzustands und der Aufgabenbeschreibung in natürlicher Sprache kontinuierlich, wie die nächste Operation auszuführen ist.
Aus den Ergebnissen pro Aufgabe geht hervor, dass Astra bei mehreren Aufgaben alle 5 Versuche erfolgreich abschloss, darunter das Einlegen von Blöcken in Kisten, die Bearbeitung von Kürbissen in Unordnung, das Platzieren von Objekten nach Beziehungen, das Stapeln in festgelegter Reihenfolge und die erneute Anpassung der Ausrichtung von Bechern. Die einzige Aufgabe, die nicht vollständig erfolgreich war, war „das Einlegen der großen Rosinenkiste in einen Behälter“, bei der 4 von 5 Versuchen erfolgreich waren.
Die Kernfähigkeit, die diese Gruppe von Experimenten zeigt, ist die Null-Shot-Generalisierung. Das Modell ist in der Lage, Ziele zu erkennen, räumliche Beziehungen zu verstehen, sprachliche Anforderungen in Aktionen umzuwandeln und die Strategie nach Änderungen der Umgebung weiter anzupassen.
Diese Zahl muss jedoch im Zusammenhang mit dem experimentellen Rahmen verstanden werden. Der Bericht stellt klar, dass das RoboLab-Experiment nur 10 Aufgaben auswählt, 5 abschließende Bewertungsplätze pro Methode und pro Aufgabe, keine vollständige Reproduktion der RoboLab-Rangliste; bei den historischen Baselines und Astra wurden nicht streng identische Anfangszustände und Steuerungskonfigurationen garantiert, und einige Astra-Experimente enthielten autorisierte Wiederholungsversuche.
Daher eignet sich der Wert von 98 % eher zur Beobachtung der oberen Fähigkeitsgrenze von Astra bei diesen Aufgaben und kann nicht einfach als strenge Ranglistenleistung unter gleichen Bedingungen betrachtet werden.
Die stärkste Seite von Astra ist das Verstehen von Aufgaben und das Entdecken von „Fehlern“
Wenn man zu den Ergebnissen pro Aufgabe in RoboDojo zurückkehrt, kann man weiter erkennen, worin es genau stark ist.
Bei der Aufgabe „Objektklassifizierung“ erzielte Astra Direct 100 Punkte und war in allen 5 Versuchen erfolgreich; bei „Klassifizierung nach Sprache“ erreichte der durchschnittliche Punktwert 60, die Erfolgsrate 40 %; bei „Anordnen der größten Zahl“ lag der Punktwert bei 57.
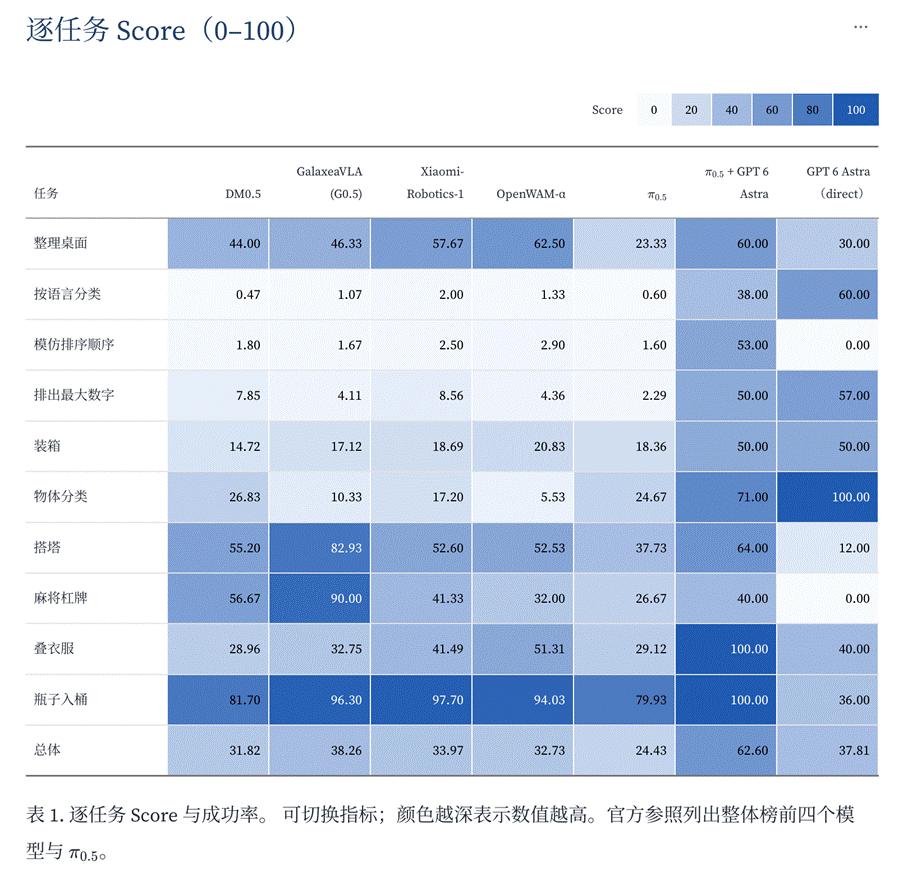
Wärmetabelle der Punktwerte, Wärmetabelle der Erfolgsraten
Diese Aufgaben hängen stark von Sprachverständnis, visueller Erkennung, Schlussfolgerung über Beziehungen und Zielplanung ab, genau die Fähigkeiten, in denen große Modelle stark sind.
In den Experimenten traten auch viele Verhaltensweisen auf, die bei herkömmlichen Roboterstrategien selten gezeigt werden.
Zum Beispiel ändert das Modell aktiv die Annäherungsweise, nachdem es festgestellt hat, dass eine Greifpose nicht ideal ist; nachdem die Objekte grob platziert sind, beobachtet es die Umgebung erneut, stellt fest, dass die Aufgabe tatsächlich noch nicht abgeschlossen ist, und passt weiter an; während des Einpackens in Kisten kann es übersehene Objekte hinter der Kiste entdecken; wenn die Ausführung des ursprünglichen Plans behindert wird, kann es basierend auf neuen visuellen Rückmeldungen neu planen.
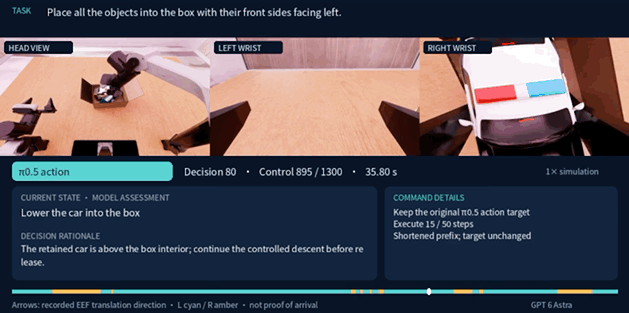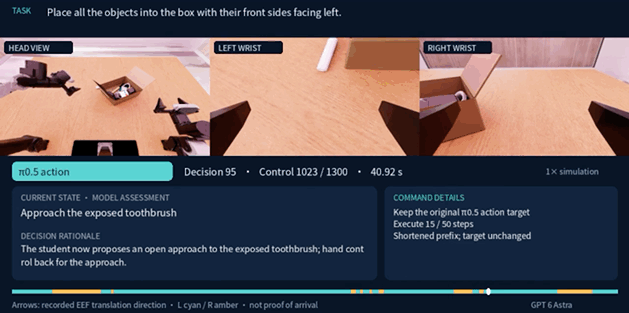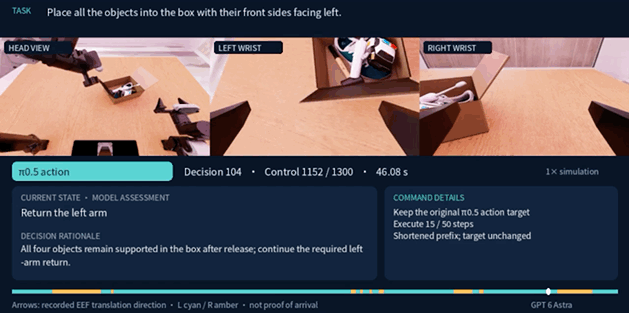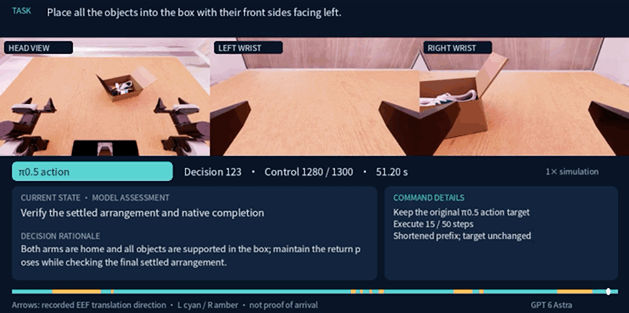
Abbildung: Im Experiment beurteilt Astra basierend auf dem neuen Bild nach der Ausführung weiter den Aufgabenstatus und passt die Aktion bei Bedarf an. Zum Beispiel stellt das Modell bei der Objektklassifizierungsaufgabe fest, dass der aktuelle Greifvorgang eine lokale Korrektur erfordert; bei langfristigen Aufgaben wie dem Einpacken in Kisten prüft das Modell kontinuierlich die verbleibenden Ziele in der Szene, bevor es die nachfolgenden Aktionen festlegt.
Auch bei der Zahlenplatzierungsaufgabe tritt eine beeindruckende Wiederherstellung auf: Das Modell versteht die Steuerungsrückmeldung des Roboterarms neu, nachdem die Bewegung behindert wurde, passt die Aktion an und führt sie weiter aus. Es zeigt die lokale Anpassungsfähigkeit von GPT-6 Astra an Steuerungsbeschränkungen, anstatt nur passiv fehlgeschlagene Befehle zu wiederholen.
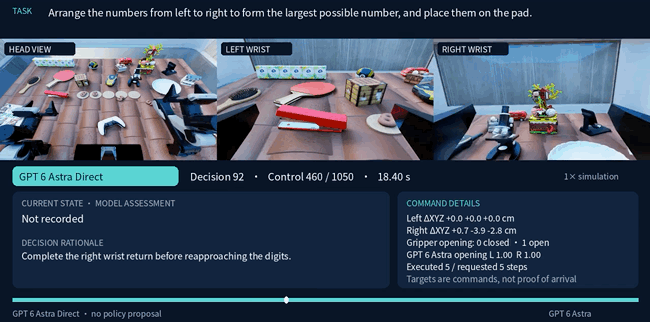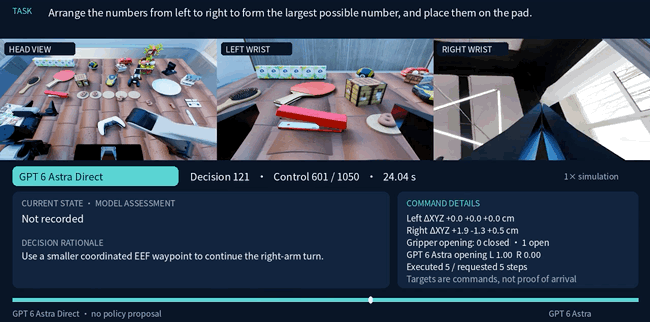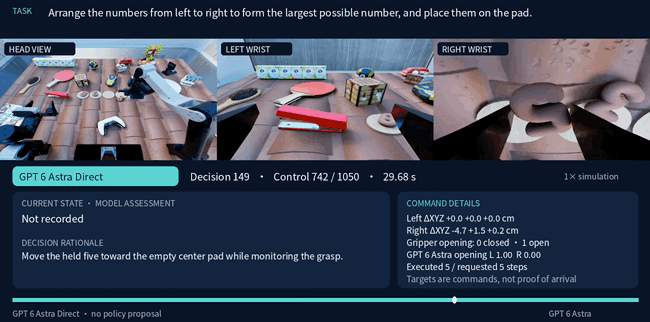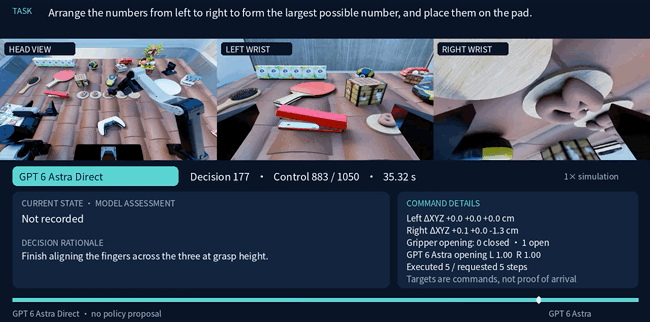
Abbildung: Zahlenplatzierung: Beeindruckende Wiederherstellung nach dem Verstehen der Steuerungsrückmeldung
Diese Phänomene zeigen, dass Astra nicht mechanisch eine zuvor generierte Trajektorie ausführt, sondern einen geschlossenen Kreislauf von „Beobachten – Entscheiden – Ausführen – Erneutes Beobachten“ bildet.
Das Modell wählt sogar aktiv einige Strategien aus, die in den Trainingsdaten möglicherweise nicht häufig vorkommen. Zum Beispiel versuchte Astra Direct bei der Aufgabe „Flasche in den Eimer legen“, die Flaschen nicht einzeln zu greifen, sondern sie in Richtung des Mülleimers zu schieben. Dieser Ansatz schlug letztendlich fehl, zeigte aber, dass das Modell selbst neue Lösungswege basierend auf dem Ziel suchen kann.
Der eigentliche Engpass liegt nach wie vor in der physischen Interaktion
Der Forschungsbericht offenbart aber auch die Schwächen von Astra.
Bei der Aufgabe „Turm bauen“ erreichte Astra Direct im Durchschnitt nur 12 Punkte, die Erfolgsrate lag bei 0; bei „Mahjong-Steine ziehen“ betrug der Punktwert 0; diese Aufgaben erfordern präzisen Kontakt, stabiles Greifen, Kollisionssteuerung und kontinuierliche Beurteilung des Kraftzustands der Objekte. Im Vergleich zu semantischen und visuellen Aufgaben hat das große Modell hier deutliche Schwierigkeiten.