Mit wenig Einsatz viel erreichen – die Ambitionen eines auf AI4S spezialisierten Unterwasserunternehmens
Text|HU Xiangyun
Redaktion|HAI Ruojing
Im Mai dieses Jahres beendete der 28-jährige ZHANG Zaixi seine Postdoc-Forschung an der Princeton-Universität und kehrte nach China zurück. Vor ihm öffneten sich gleichzeitig mehrere Türen: eine Fakultätsstelle an einer amerikanischen Universität, die Position als Chefwissenschaftler bei einem großen KI-Unternehmen und ein Jahresgehalt von mehreren zehn Millionen Yuan. Schließlich entschied er sich, als Assistenzprofessor an die Hongkong-Universität für Wissenschaft und Technik zu wechseln, und wagte den Schritt in die schmale Welt der Unternehmensgründung, wo er das KI-for-Science-Unternehmen Scinetics gründete.
Exklusiv von Waves erfahren: Scinetics hat kürzlich eine Finanzierungsrunde von fast 50 Millionen RMB abgeschlossen. Die Runde wurde von Inno Venture Capital angeführt, gefolgt von Yijing Capital, Xiaomiao Langcheng und Linge Venture Capital.
Dies ist wahrscheinlich einer der wenigen Scheidewege in seinem bisherigen Leben. Von der Klasse für begabte Jugendliche der Universität für Wissenschaft und Technik Chinas über das direkte Doktoratsstudium bis zur gemeinsamen Ausbildung an der Harvard Medical School und anschließend zur Postdoc-Arbeit im Team von WANG Mengdi an der Princeton-Universität: Der junge Principal Investigator im Bereich KI4S gehört zu den beliebtesten Gründerprofilen auf dem aktuellen Venture-Capital-Markt.
Aber bei der Entscheidung für die Unternehmensgründung zögerte er auch eine Zeit lang.
Der Eintritt in ein großes Unternehmen bedeutet ausreichendere Rechenleistung, Daten und Personalausstattung; als Principal Investigator an einer Universität zu arbeiten und gleichzeitig ein Unternehmen zu gründen, erfordert es, relativ unabhängig nach Mitarbeitern, Kapital und Ressourcen zu suchen, wobei es sowohl in technischer als auch in geschäftlicher Hinsicht Unsicherheiten gibt.
Was ZHANG Zaixi schließlich zu seiner Entscheidung brachte, war die „Arbeitsautonomie“: Er wollte seine eigene Forschungsrichtung bestimmen, anstatt von einer größeren Unternehmensorganisation eingeschränkt zu werden. Er genießt den Prozess, ein System von Grund auf neu aufzubauen, mehr.
Vor der Gründung des Unternehmens entwickelte das Team um ZHANG Zaixi einst den wissenschaftlichen Agenten Stella. Nach der Veröffentlichung von Stella im letzten Jahr bediente es Tausende von wissenschaftlichen Nutzern, von denen mehr als 70 % von Universitäten wie Stanford und Princeton sowie von Spitzenlabors stammten. Im Vergleich zu selbst trainierten Basismodellen können Agenten schneller eingeführt werden und lassen sich leichter in bestehende Forschungs- und Entwicklungsprozesse integrieren, um Kommerzialisierung zu erreichen.
Dieser einfache Weg weist derzeit jedoch noch Grenzen auf. Wenn große Sprachmodelle als Schlussfolgerungsmotor verwendet werden, übersetzen wissenschaftliche Agenten bei Daten wie Proteinstrukturen und Nukleinsäuresequenzen das Problem zunächst in „natürliche Sprache“ und übergeben dann die Textanweisungen an das Modell zur Ausführung. Feine dreidimensionale Strukturen und modale Beziehungen gehen bei mehreren Übersetzungsvorgängen „verloren“, und selbst Dutzende von Interaktionen des Agenten können die Fehler nicht umgehen.
Während seiner Doktorzeit entwickelte ZHANG Zaixi unter anderem das Molekular-Screening-Modell MGSSL und das Medikamentenmolekül-Generierungsmodell FLAG, die in mehreren Teilbereichen den SOTA-Standard erreichten. Aber er kam zu dem Schluss, dass einzelne Fähigkeiten nicht ausreichen und die gesamte KI4S-Branche künftig in Richtung Multimodalität gehen wird. Deshalb konzentriert sich Scinetics auf die Entwicklung eines multimodalen Basismodells für langfristige Schlussfolgerungen.
Er hat das Konzept des „Science Token“ vorgeschlagen, das wissenschaftliche Daten wie die Strukturen von kleinen Molekülen, Nukleinsäuren und Proteinen in einheitliche Darstellungseinheiten für das Modell umwandeln soll, ohne die Übersetzung durch menschliche Sprache zu durchlaufen. Dadurch kann das Modell in der nativen wissenschaftlichen Modalität schlussfolgern und wissenschaftliche Aufgaben erledigen.
Kurzfristig werden sie sich auf die Biowissenschaften konzentrieren, wo der kommerzielle Weg am klarsten ist, und künftig schrittweise auf wissenschaftliche Bereiche wie Materialwissenschaften und Ingenieurwesen ausweiten.
Wenn er über die Zukunft spricht, ist ZHANG Zaixi überzeugt, dass es im Bereich KI4S unweigerlich einen „GPT-Moment“ und einen „Coding-Moment“ geben wird, und dass dieser Markt den Markt für Codierung übertreffen könnte. Er glaubt auch, dass sein kleines Team über die Fähigkeit verfügt, ein „einheitliches“ wissenschaftliches Basismodell zu entwickeln und zu einem Anbieter von Basismodellen im KI4S-Bereich zu werden, der mit DeepSeek und Anthropic vergleichbar ist.
In der Anfangsphase einer technologischen Revolution haben sich die Wege noch nicht vereinheitlicht, sodass Gründer die Chance haben, mit wenig Einsatz viel zu erreichen. Kürzlich haben wir mit ZHANG Zaixi gesprochen: Welche Zukunft will er eigentlich setzen, wenn er jetzt in das KI4S-Geschäft einsteigt?
Das Gespräch (redigiert):
KI4S: Ein Billionen-Markt, der mit dem Codieren mithalten kann
Waves: 2019, als Sie 21 Jahre alt waren, haben Sie KI for Science als Forschungsrichtung für Ihr Doktorat gewählt. Rückblickend war das sehr weitsichtig. Wie haben Sie den Wandel dieses Bereichs von einem Nischenthema zu einem heißen Thema erlebt?
ZHANG Zaixi: Ich hatte wirklich Glück, dass der Wechsel in meiner Karriere genau mit dem Branchenboom zusammenfiel.
Als ich mein Doktorat absolvierte, war dies ein Bereich, der noch keinen allgemeinen Konsens fand. Die Branche verstand es als „Wissenschaft + KI“, wobei KI ein zusätzliches Algorithmuswerkzeug zur Verbesserung der Geschäftseffizienz war. Projekte mussten eng an spezifische Medikamentenpipelines gebunden sein, zum Beispiel auf Polypeptidmedikamente spezialisiert sein oder nur vertikale Modelle für Proteine entwickeln.
Heute entwickelt sich KI4S in Richtung Allgemeinheit, und der Markt ist allgemein der Ansicht, dass dieser Bereich seinen eigenen „Coding-Moment“ erleben wird. Das Schreiben von Code gibt den Menschen die Fähigkeit, Dinge in der digitalen Welt zu erschaffen; KI4S verändert die grundlegende Fähigkeit der Menschen zur wissenschaftlichen Erkundung und Entdeckung neuen Wissens, sodass sein Marktwert dem des Codierens gleichkommen oder ihn sogar übertreffen kann.
An der Iteration von Alpha Fold von Version 1 bis 4 ist klar zu erkennen, dass sich die Fähigkeiten der KI schnell verbessern. Die zu erforschenden wissenschaftlichen Probleme haben sich nicht grundlegend geändert, aber neue Algorithmen schaffen Bedingungen für die Lösung von Aufgaben, die früher schwer zu modellieren und vorherzusagen waren. Die Einbeziehung weiterer wissenschaftlicher Modalitäten stärkt die Fähigkeiten der Modelle weiter.
Waves: Wissenschaft ist ein sehr breites Feld. Welches sind die vorherrschenden technischen Wege für Unternehmensgründungen und Investitionen in diesem Bereich derzeit? Gibt es einen Trend zur Vereinheitlichung der technischen Pfade?
ZHANG Zaixi: Objektiv gesehen gibt es im aktuellen KI4S-Bereich noch viel Rauschen. Die Akteure im KI4S-Bereich gestalten ihre Arbeit hauptsächlich auf der Grundlage ihrer bisherigen Hintergründe, es gibt noch keinen Konsens über die technischen Wege, und es ist schwer zu beurteilen, welcher besser oder schlechter ist.
Erstens gibt es die wissenschaftlichen Agenten, die wissenschaftliche Aufgaben hauptsächlich durch den Aufruf externer Tools erledigen. Ihre Vorteile liegen in der schnellen Einführung, der schnellen Integration in bestehende Forschungs- und Entwicklungsprozesse und dem kurzen Zyklus der kommerziellen Validierung, weshalb viele Startups in diesem Bereich entstanden sind.
Auch große Unternehmen arbeiten daran, wie Claude Science von Anthropic und GPT-Rosalind von OpenAI. Aber ihr Hauptfokus liegt auf allgemeineren Bereichen wie der Codierung, der wissenschaftliche Bereich ist nur eine Platzierungsstrategie und eine oberflächliche Erkundung.
Zweitens gibt es die virtuellen Zellen. Beeinflusst von den Arbeiten und Papieren des Arc Institute hat die Popularität virtueller Zellen seit letztem Jahr stark zugenommen. Theoretisch simulieren sie in Computern die Veränderungen von Zellen nach der Behandlung mit Medikamenten oder Genbearbeitung, wodurch ungültige Kandidaten im Voraus in großen Mengen ausgesiebt und die Forschungs- und Entwicklungszeit sowie -kosten reduziert werden können. Die Branche hat hohe Erwartungen daran, und die Entwicklung schreitet relativ schnell voran.
Drittens gibt es den von uns gewählten Weg des KI4S-Basismodells. Dies ist ein „von unten nach oben“ gerichteter Ansatz, der sich auf die Wechselwirkungen von Molekülen auf unterster Ebene konzentriert und aus molekularen Mechanismen übergeordnete Phänomene wie Krankheiten und genregulierende Netzwerke ableitet.
Waves: Sie haben im letzten Jahr den wissenschaftlichen Agenten Stella veröffentlicht, der angeblich sehr gut ankam. Warum haben Sie sich nicht für diesen einfacheren Weg entschieden?
ZHANG Zaixi: Nach der Veröffentlichung von Stella im letzten Jahr bediente es Tausende von wissenschaftlichen Nutzern, von denen mehr als 70 % von renommierten Universitäten wie Stanford und Princeton sowie von Spitzenlabors stammten. Auch Professor ZHANG Feng vom MIT hat es genutzt.
Aber wir haben festgestellt, dass das Paradigma der wissenschaftlichen Agenten ein grundlegendes Problem hat:
Im Wesentlichen übersetzt es wissenschaftliche Probleme in natürliche Sprache, damit das Modell sie versteht, und übersetzt sie dann zurück in Strukturanweisungen, damit die Tools sie ausführen. Viele feine Informationen über dreidimensionale Strukturen und subtile Zusammenhänge zwischen verschiedenen Modalitäten gehen während des Übersetzungsprozesses verloren.
Das ist die Obergrenze dieses Paradigmas selbst. Man kann natürlich ständig weitere Tools und Prozesse zum Agenten-Framework hinzufügen, aber solange die grundlegende Schlussfolgerung auf Text basiert, bleibt dieser Engpass bestehen.
Waves: Können Sie ein Beispiel nennen, das ein Agent nicht lösen kann?
ZHANG Zaixi: Zum Beispiel die Optimierung der lokalen Struktur von Proteinen. Wenn man eine bestimmte Seitenkette um 5 Grad in einen bestimmten Winkel drehen möchte, um Wasserstoffbrückenbindungen oder andere molekulare Wechselwirkungen zu bilden, hängt dies stark von der feinen schlussfolgernden Gestaltung im 3D-Raum ab.
Wenn man dies mit einem Agenten erledigt, lässt man das große Sprachmodell Textanweisungen ausgeben und ruft dann Struktur-Diffusionsmodelle wie RF diffusion zur Ausführung auf. Aber das Strukturmodell selbst kann die Textinformationen nicht gut verstehen. Die Ergebnisse der Tools werden wiederum in Zeichenfolgen und Screenshots umgewandelt und an das große Sprachmodell zurückgesandt. Der Agent versteht es nur vage, es scheint richtig zu sein, aber auch nicht ganz, und er kann nur weiter iterieren.
Bei diesem Schritt haben wir viele Agenten ausprobiert, Dutzende von Malen wiederholt interagiert, eine Menge Token verschwendet, und am Ende erhielten wir eine Menge unbrauchbarer Ergebnisse. Die Ursache liegt darin, dass keine native Fähigkeit zur Schlussfolgerung in wissenschaftlichen Modalitäten vorhanden ist.
Der große Traum eines jungen Talents: Das multimodale wissenschaftliche Basismodell
Waves: Sie sind also der Ansicht, dass man unbedingt KI4S-Basismodelle entwickeln muss? Kann ein Basismodell das Problem der „Übersetzung zwischen verschiedenen Modalitäten“ lösen?
ZHANG Zaixi: Da die Übersetzung zu Verlusten führt, übersetzen wir einfach nicht mehr. Wir lassen das Modell direkt im nativen wissenschaftlichen Modalitätsraum langfristige Schlussfolgerungen für multimodale wissenschaftliche Daten durchführen (Chain of Science Tokens). Dieses Basismodell ist auch das Kernprodukt unseres Unternehmens.
Für verschiedene wissenschaftliche Modalitäten wie Omik-Daten, Proteinstrukturen, molekulare chemische Formeln und Nukleinsäuresequenzen haben wir ein diskretes Tokenisierungsverfahren entwickelt, das alle Arten von wissenschaftlichen Informationen in einheitliche Science-Token umwandelt und sie in das Modell einspeist, ohne auf die menschliche natürliche Sprache als abstrakte Zwischenschicht angewiesen zu sein. Das kommt dem Wesen der Wissenschaft näher.
Das Training des Modells gliedert sich in drei Phasen: Vortraining, mittleres Training und Nachtraining. Beim Vortraining wird eine multimodale Darstellung der Biowissenschaften aufgebaut, beim mittleren Training lernt das Modell die übergreifenden Regeln von Sequenzen zu Strukturen, Funktionen und zellulären Phänotypen, und beim Nachtraining wird die Fähigkeit zu langfristigen Schlussfolgerungen gezielt gestärkt.
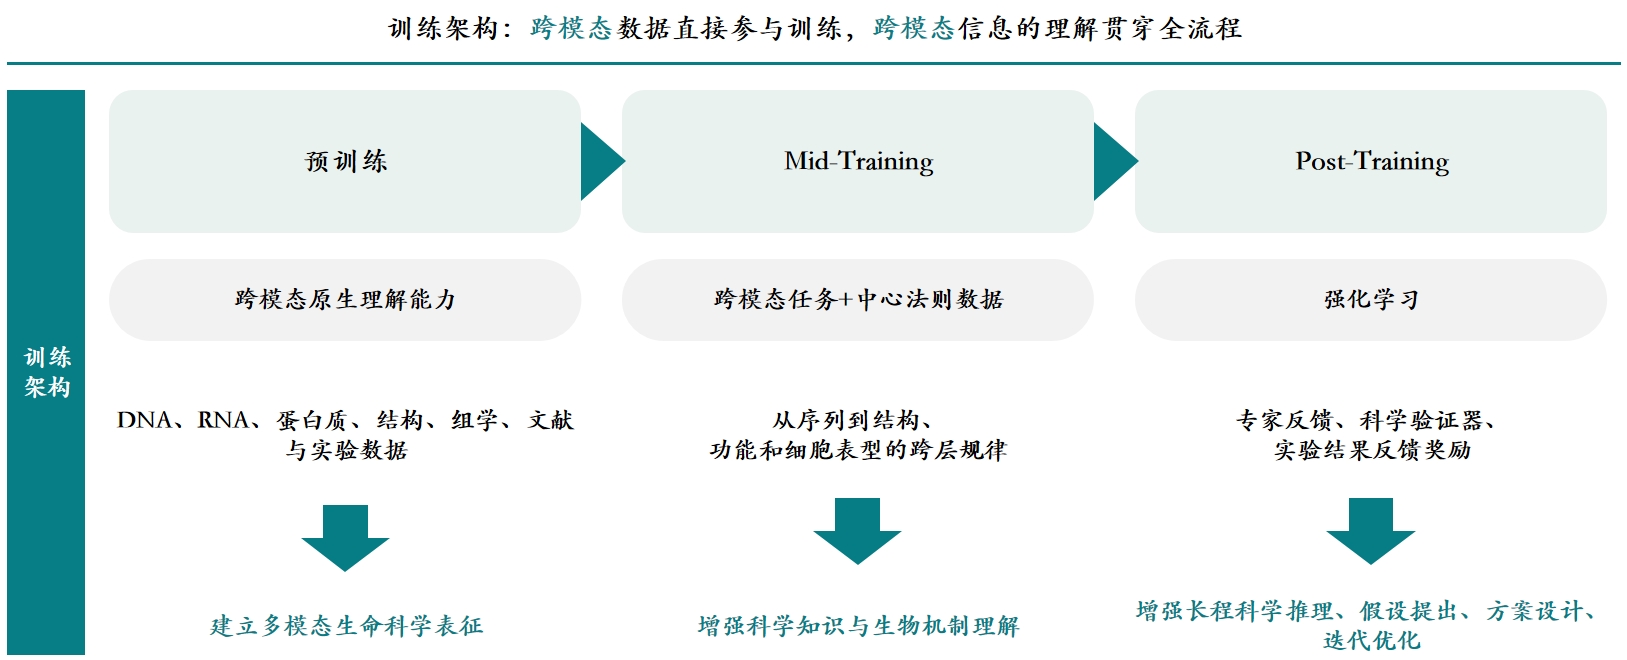
Das Trainingsframework für KI4S-Basismodelle (Quelle: Scinetics)
Waves: Was unterscheidet diese Art von langfristigen Schlussfolgerungen von den früheren vertikalen kleinen Modellen, die einzelne Aufgaben lösten?
ZHANG Zaixi: Zum Beispiel bei der Enzymdesign liefert das Modell nicht sofort ein Ergebnis, sondern schließt schrittweise wie ein menschlicher Wissenschaftler: Zuerst baut es das aktive Zentrum des Enzyms auf, das den Kernbereich der katalytischen Funktion bestimmt; dann baut es das Protein-Gerüst auf, das das aktive Zentrum stützt; schließlich ergänzt es die Seitenketten und feinjustiert die Details.
Diese Fähigkeit zu langkettigen Schlussfolgerungen besitzen herkömmliche vertikale Modelle und Agenten, die nur Tools aufrufen, nicht.
Waves: Alle Arten von wissenschaftlichen Informationen in „einheitliche“ Science-Token umzuwandeln klingt sehr überzeugend. Aber die Datenstrukturen von kleinen Molekülen, Nukleinsäuren und Proteinen unterscheiden sich stark. Warum ist Ihr Team dazu in der Lage?
ZHANG Zaixi: Mit Science Token wollen wir zunächst das Problem lösen, dass das Modell verschiedene wissenschaftliche Modalitäten verstehen kann.
In der Vergangenheit haben wir für kleine Moleküle, Nukleinsäuren, Proteine, Komplexe und modalitätsübergreifende Texte jeweils entsprechende Basismodelle entwickelt. Wir haben den gesamten Prozess von der Datenerfassung über den Modellaufbau bis zum Training vollständig durchlaufen. Deshalb weiß das Team, wie jede Art von wissenschaftlichen Daten kodiert werden muss und wie verschiedene Modalitäten zueinander ausgerichtet werden können.
Gleichzeitig haben wir bei der Entwicklung von Agenten wie Stella und BioClaw eine große Menge an Daten für langkettige Schlussfolgerungen gesammelt und Methoden erforscht, um die Schlussfolgerungsfähigkeiten durch Nachtraining zu verbessern.
Darüber hinaus ist der geschlossene Kreislauf zwischen Berechnung und Experiment wichtig. Neben Berechnungs- und Algorithmusmodulen ist Stella auch mit automatisierten Nasslaborexperimenten verbunden. Wir haben in Aufgaben wie Zielentdeckung, Antikörperoptimierung und kleinem Nukleinsäuredesign bereits Fälle des geschlossenen Kreislaufs zwischen Berechnung und Experiment erfolgreich durchgeführt. Deshalb wissen wir auch, wie KI mit echten wissenschaftlichen Aufgaben verbunden werden kann und wie sie an automatisierte Experimentgeräte angeschlossen wird.
Die Weiterentwicklung des Modells erfordert die aktive Beschaffung einer großen Menge hochwertiger Daten. Der geschlossene Kreislauf zwischen Berechnung und Experiment ermöglicht es uns, kontinuierlich Trainingsdaten zu erhalten und das Modell ständig zu verbessern.
Waves: Wie leistungsfähig ist dieses Bas