GPT-6 ist da: Wir haben mit mehreren Brancheninsidern über die Wettbewerbsgräben und Klippen der Embodied Intelligence gesprochen.
Insider der Branche für verkörperte Intelligenz beginnen zu befürchten, dass die erwartete Zukunft vorzeitig realisiert wird – und zwar möglicherweise von einem ganz anderen Unternehmen als ihnen selbst.
Nach dem Erscheinen von GPT-6 Astra ist diese Stimmung in den Diskussionen der diesjährigen Bund-Konferenz besonders deutlich geworden. Zhu Zheng, Mitbegründer und leitender Wissenschaftler von Excellent Vision, warnte: Sprachmodelle haben bereits den multimodalen Bereich übernommen und dringen nun in die Domäne der verkörperten Intelligenz vor, wobei sie in Bezug auf Talente, Rechenleistung und Kapital über umfassende Vorteile verfügen. „Der Wolf ist schon da, gebt die Illusionen auf“. Seiner Meinung nach werden die nächsten ein bis zwei Jahre ein entscheidendes Zeitfenster sein, und die heutige verkörperte Intelligenz verfügt noch über keinen echten dauerhaften Wettbewerbsvorteil.
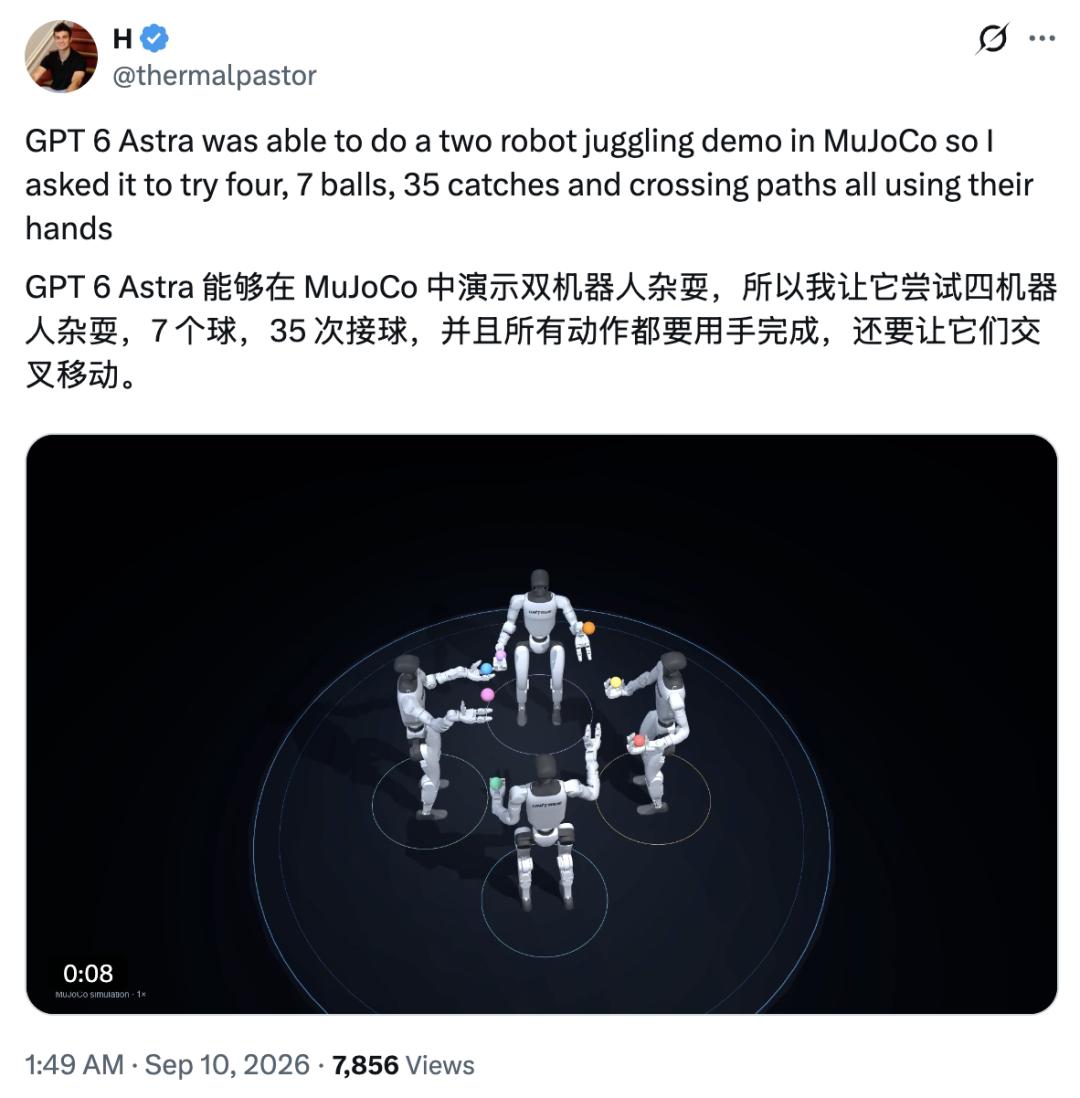
Diese Sorgen haben eine reale Grundlage. Nach der Veröffentlichung von Astra durch OpenAI tauchten zahlreiche Demonstrationen auf, die zeigen, wie man mit dieser Technologie Roboter steuert, und die gesamte Branche für verkörperte Intelligenz hat umgehend entsprechende Tests und Diskussionen gestartet.
Gleichzeitig hat Sam Altman klar zum Ausdruck gebracht, dass OpenAI die Absicht hat, Roboter in menschlicher Form und andere Arten von Robotern zu entwickeln. Für Startups, die noch an der Vervollständigung ihrer ersten Produktgeneration arbeiten, ist die Möglichkeit, dass der Anbieter der vorgelagerten Modelle zu einem direkten Konkurrenten wird, bereits offensichtlich geworden.
Auf derselben Konferenz hörten wir aber auch eine andere Stimme. Zhu Xing, CEO von Ant Lingbo, stellte in einem Medieninterview die Gegenfrage: Könnten OpenAI oder Anthropic, wenn sie heute selbst in die Entwicklung des autonomen Fahrens einsteigen, Tesla in kurzer Zeit verdrängen? Wang Qian, Gründer und CEO von Independent Variable Robotics, lenkte die Antwort auf Daten, Validierung und Hardware: Brauchen diese Infrastrukturen nicht auch von großen Modellunternehmen ergänzt zu werden, wenn sie in die physische Welt eintreten?
Neben der Besorgnis haben einige Teams bereits begonnen, Astra in ihre Forschungs- und Entwicklungsarbeit einzusetzen: Einige nutzen es, um Simulationsszenarien zu generieren, andere versuchen, es gemeinsam mit Modellen für verkörperte Intelligenz zur Steuerung von Robotern zu verwenden. Der Einzug großer Modelle in den Bereich der verkörperten Intelligenz bringt weitaus vielfältigere Veränderungen als die einfache Frage „Wer ersetzt wen“. Die Übernahme allgemeiner kognitiver Fähigkeiten, die Ersetzung spezialisierter Modelle und die vollständige Übernahme des Geschäfts eines Roboters durch ein anderes sind drei völlig unterschiedliche Vorgänge mit großen Abständen zueinander. Wenn man sie alle unter dem Begriff „dimensionale Reduktionsschlag“ zusammenfasst, führt das leicht zu Irreführungen.
Ehrlich gesagt, es gibt tatsächlich eine Grenze zwischen der verkörperten Intelligenz und großen allgemeinen Modellen. Diese Grenze verschiebt sich jedoch, und die Schwierigkeiten, die heute beide Seiten trennen, werden nicht automatisch zu dauerhaften Vermögenswerten eines einzelnen Unternehmens.
01 Fähigkeiten lassen sich übertragen, physische Erfahrungen müssen noch gesammelt werden
Hinter dieser aktuellen Welle der Besorgnis steht eine scharfe Schlussfolgerung: Wenn die allgemeine Intelligenz hoch genug ist, werden die für Roboter benötigten Fähigkeiten ganz natürlich entstehen.
Auf dem Podium zum Thema „Physische Intelligenz – Meinungsverschiedenheiten und Entscheidungen“ im Hauptforum der Bund-Konferenz vertrat Wang Qian von Independent Variable Robotics eine zurückhaltende Haltung zu dieser Ansicht. Er wies darauf hin, dass die Fortschritte bei den Programmierfähigkeiten von Sprachmodellen eng mit der Verbesserung einer großen Menge an Programmierdaten, Dateninfrastrukturen und Validierungssystemen zusammenhängen. Fortschritte bei der Videogenerierung haben das Problem der Steuerung von Roboterbewegungen auch nicht direkt gelöst.
Die übertragbarkeit zwischen verschiedenen Aufgaben und die Wiederverwendbarkeit von Fähigkeiten sind natürlich wichtige Werte von Grundmodellen. Die Erinnerung von Wang Qian liegt darin, dass jeder Sprung in den Fähigkeiten normalerweise mit entsprechenden Lernmaterialien, Trainingszielen und Feedbackmechanismen verbunden ist. Wenn man diese Investitionen aus den Erfolgsgeschichten streicht und alle Ergebnisse nur dem natürlichen Überlauf der allgemeinen Intelligenz zuschreibt, werden wir die Kosten falsch einschätzen, die für den nächsten Durchbruch erforderlich sind. Historische Erfahrungen können nicht beweisen, dass Fähigkeitssprünge nie stattfinden, aber sie reichen aus, um die Branche daran zu erinnern, dass die Arbeit hinter diesen Sprüngen nicht übersprungen werden darf.
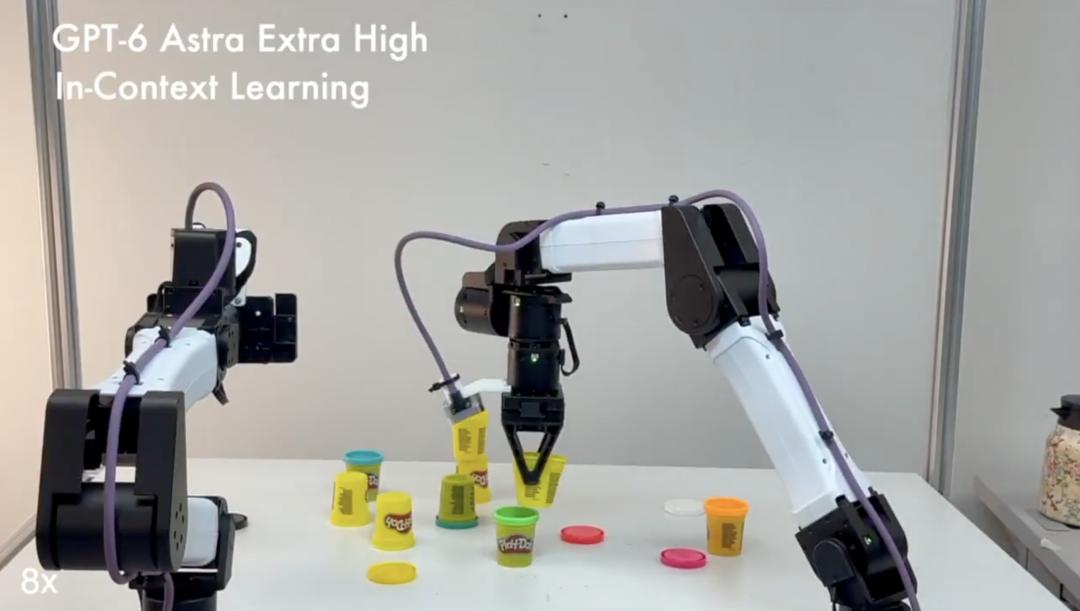
Wenn wir also sehen, dass ein Modell einen mechanischen Arm steuert, ist die nächste Frage wert, gestellt zu werden: Welche Bewegungsschnittstelle nutzt es, wie viele Steuerungsfähigkeiten sind auf der unteren Ebene bereits vorhanden, verwendet es Roboter-Daten, und was kann es noch erreichen, wenn man die Hardware austauscht oder ein anderes Objekt verwendet? Die Demonstration zeigt nur das Endergebnis des gesamten Systems. Um zu beurteilen, wie groß der Durchbruch durch das Modell ist, muss man auch die Zusammensetzung des gesamten Systems verstehen.
Xu Huazhe, Gründer von Break Shell Robotics, teilte auf demselben Podium die Testergebnisse seines Teams zu Astra. Er teilte die Aufgaben der verkörperten Intelligenz in drei Ebenen ein: Semantik, Raum und Physik. Unter den damaligen Testbedingungen waren die semantischen und räumlichen Fähigkeiten von Astra bereits sehr stark: Es konnte Objekte auf dem Tisch erkennen, dünne Essstäbchen greifen und die Stäbchen sogar aufrecht in eine Tasse stecken.
Bei komplexeren Kontaktaufgaben traten die Schwierigkeiten auf. Xu Huazhe erwähnte, dass das Team bei Aufgaben wie dem Aufziehen von Objekten mit Essstäbchen oder dem Falten von Kleidung noch keine idealen Ergebnisse erzielt hat; auch bei Tests zum Übergeben von Objekten mit zwei Händen gelangen nur wenige Versuche erfolgreich. Diese Beobachtungen können keine einheitliche Bewertung darstellen, aber sie zeigen eine sehr klare Trennlinie: Zu wissen, wo sich ein Objekt befindet und wohin es transportiert werden soll, ist noch etwas anderes als zu verstehen, wie sich der Zustand nach dem Kontakt ändert. Sprach- und Sehkenntnisse können a priori-Werte liefern, aber Roboter müssen in der tatsächlichen Interaktion auch Variablen verarbeiten, die sich nicht nur durch das äußere Erscheinungsbild bestimmen lassen.
Eine kürzlich durchgeführte Studie zu zehn zweihändigen Bedienaufgaben auf der RoboDojo-Plattform liefert genauere Beobachtungen zu dieser Beziehung. In den Simulationstests erreichte die direkte Steuerungsarchitektur von GPT-6 Astra eine Erfolgsrate von 26 % und eine durchschnittliche Punktzahl von 37,81; nach der Kombination von π₀.₅ mit Astra stieg die Erfolgsrate auf 48 % und die durchschnittliche Punktzahl auf 62,60.
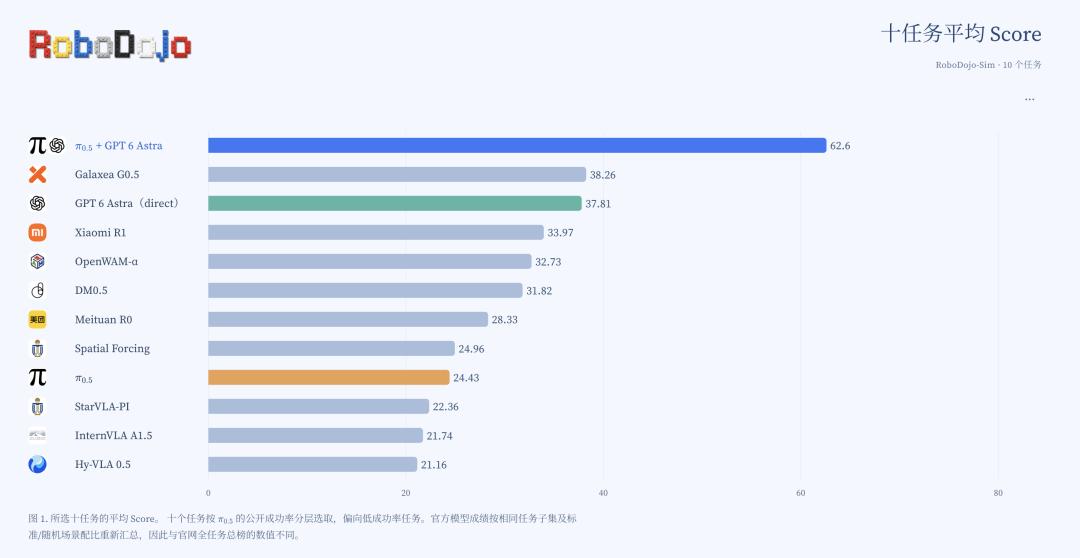
Auffällig ist jedoch, dass in der gemischten Architektur Astra nur 14,4 % der Ausführungssteuerungsschritte korrigiert, während die restlichen 85,6 % direkt die Bewegungen von π0.5 übernehmen. Die von der Studie veröffentlichten Bahnenanalysen zeigen, dass Astra Fehler bei der Zielausrichtung korrigieren, nicht greifende Vorgänge wie Schieben und Schwenken planen und nachfolgende Bewegungen anpassen kann, wenn die Aufgabenbedingungen noch nicht erfüllt sind; π0.5 liefert dagegen direkte Bewegungsreferenzen und a priori-Werte für die Interaktion mit Objekten.
Diese Ergebnisse zeigen den Wert der Kombination von allgemeinem Schlussfolgerungsvermögen und lokalen Betriebserfahrungen. Selbst eine geringe Anzahl von Eingriffsschritten kann einen großen Einfluss auf den Erfolg oder Misserfolg einer Aufgabe haben; der hohe Anteil der zugrundeliegenden Bewegungen zeigt auch, dass physische Fähigkeiten weiterhin eine wichtige Rolle spielen. Die zehn Simulationsaufgaben reichen nicht aus, um den endgültigen Sieg eines technischen Weges zu bestimmen, und die Erfolgsrate von 48 % erinnert uns auch daran, dass das vollständige System noch Raum für Verbesserungen hat, um zuverlässig zu arbeiten. Dies unterstützt eine Richtung der Zusammenarbeit, kann aber nicht so interpretiert werden, dass große Modelle die Probleme der verkörperten Intelligenz bereits vollständig gelöst haben.
Zurück zur Bund-Konferenz: Shen Yujun, leitender Wissenschaftler von Ant Lingbo Technology, wies darauf hin, dass Roboter ständig Eingaben von Sensoren empfangen müssen, und selbst wenn sie gerade Schlussfolgerungen ziehen oder Aktionen ausführen, müssen sie ihr Verhalten jederzeit an neue Informationen anpassen. Die physische Welt wird nicht anhalten, dass ein Objekt aus der Hand rutscht, nur weil das Modell noch nachdenkt. Das stellt Anforderungen an die Modelle in Bezug auf kontinuierliche Wahrnehmung, zeitnahe Reaktion und Effizienz bei der Bereitstellung.
Tatsächlich treiben diese Anforderungen auch die technischen Entscheidungen großer Modellunternehmen voran. Als Google DeepMind im Juli dieses Jahres Gemini Robotics 2 veröffentlichte, bot es getrennte Module für verkörperte Schlussfolgerung, visuelle Sprachaktionen und Endgerätemodelle an und wies ausdrücklich darauf hin, dass die geschickte Bedienung mit mehreren Fingern noch Herausforderungen birgt. Die Technologiegiganten betreten den Bereich der verkörperten Intelligenz und entwickeln gleichzeitig spezielle Modelle und Systeme dafür.
Die Grenzen der Fähigkeiten werden durchbrochen, aber das bedeutet nicht, dass ein einziges Modell alles vollständig übernehmen kann. Spezialisiertes Training, Systemzusammenarbeit und Bereitstellung auf Endgeräten sind alle an diesem Prozess beteiligt. Ein sinnvollerer Wettbewerbsindikator ist, wer diese Fähigkeiten mit weniger Interaktionserfahrung und niedrigeren Bereitstellungskosten stabil bereitstellen kann.
02 Ob Daten zu einer Barriere werden können, hängt davon ab, wer kontinuierlich effektives Feedback erhalten kann
Letztendlich basieren große Modelle wie GPT-6 im Wesentlichen auf dem Prinzip „Große Datenmengen erzwingen starke Fähigkeiten“, und ihre Wettbewerbsfähigkeit liegt in der Erschließung und Nutzung hochwertiger Daten. Aber kann diese Fähigkeit so einfach und direkt auf den Bereich der verkörperten Intelligenz übertragen werden?
Zhu Xing verwendete das autonome Fahren als Vergleich: Warum entwickelt OpenAI trotz seiner Stärke kein autonomes Fahren, dessen Markt so groß ist, um Tesla zu verdrängen? Man darf die Distanz zwischen den Modellfähigkeiten und den industriellen Fähigkeiten nicht übersehen. Führende Trainingstechniken können das Verständnis für spezifische Szenarien nicht ersetzen und auch keine ausgereifte Datenpipeline direkt hervorbringen. Seiner Meinung nach ist die Fähigkeit, zu beurteilen, was gute Daten sind, und das Know-how bei der Datensammlung eine Arbeit mit höheren Wettbewerbsbarrieren.
Dieser Vergleich zeigt die tatsächlichen Kosten, die für den Eintritt in ein fremdes Fachgebiet zu zahlen sind. Natürlich hängt die Entscheidung eines Unternehmens, in welchen Markt es eintritt, auch von Ressourcenallokation, Gewinnerwartungen und strategischen Prioritäten ab. Dass dies bisher kommerziell nicht umgesetzt wurde, beweist nicht, dass es technisch unmöglich ist. Deshalb müssen wir untersuchen, welche weiteren Schritte noch erforderlich sind, um die Vorteile der Modelle in industrielle Vorteile umzuwandeln.
Bei Robotern ist das Modell nur ein Glied in der gesamten Lieferkette. Kunden kaufen Produkte, die Aufgaben dauerhaft erfüllen können. Wie mechanische Strukturen und Sensoren zusammenwirken, ob die Leistung nach Abnutzung der Geräte stabil bleibt, wer für unvorhergesehene Probleme vor Ort zuständig ist und ob die Wartungskosten kontrolliert werden können – all das fließt in die Kostenrechnung der Kunden ein. Große Modellunternehmen können diese Arbeiten selbst aufbauen, erwerben oder mit Partnern zusammenarbeiten, aber in jedem Fall müssen sie Ressourcen dafür investieren.
Wang Qian stellte auf dem Podium fest: Wenn OpenAI oder Anthropic ebenfalls reale Daten, Simulationen, Bewertungen und Hardware-Infrastrukturen benötigen, dann nehmen sie an demselben Wettbewerb um die verkörperte Intelligenz teil.
Viele Menschen werden diese Einschätzung anzweifeln: Wenn ein Unternehmen wie OpenAI riesige Summen ausgibt, um Daten zu sammeln, wer kann dann mithalten? Das ist aber eine sehr überdenkenswerte Ansicht. Angesichts gemeinsamer Probleme werden die verschiedenen Seiten wahrscheinlich nicht automatisch die gleiche Geschwindigkeit bei der Lösung haben. Die Rechenleistung, die Talente und die Werkzeugfähigkeiten der Giganten können den Aufholprozess immer noch erheblich beschleunigen.
Objektiv gesagt muss die Aussage „Wir verfügen über Daten“ strenger geprüft werden. Daten, die auf dem Markt wiederholt eingekauft werden können, sind nicht unbedingt knapp; eine große Anzahl von wiederholten erfolgreichen Abläufen in demselben Szenario können auch nicht unbedingt die fehlgeschlagenen Fälle wirksam abdecken. Die Größe eines Datensatzes hat nur dann einen diskutablen Wettbewerbswert, wenn sie mit der Aufgabenverteilung, der Qualität des Feedbacks und dem Nutzen für das Modell verbunden ist.
Die sichtbare Realität ist, dass die Art der Datenerstellung zunehmend von allgemeinen Modellen beeinflusst wird. Li Tianyu, Mitbegründer und CEO von YuanCe Future, teilte mit, dass sein Team bereits GPT-6 verwendet hat, um durch Programmierung Simulationsszenarien zu generieren und menschliche Roboter darin zu platzieren, um festgelegte Aufgaben zu erledigen. In ihren schnellen Praxistests waren die generierten Ergebnisse vollständig, logisch nachvollziehbar und praxistauglich. Seiner Meinung nach kann die Massenerzeugung von 3D-Szenario-Assets und die Unterstützung bei der Datenbereinigung durch verbesserte Fähigkeiten zum Verstehen von visuellen Sprachen die anfänglichen Forschungs- und Entwicklungskosten für Daten direkt senken.
Das führt zu einer doppelten Veränderung bei den Datenbarrieren: Vorgänge wie die Erstellung von Simulations-Assets und die Datenbereinigung werden möglicherweise billiger, und die ursprünglichen Kostenvorteile bei der Datenerstellung werden sich verringern. Nachdem Szenarien schnell generiert werden können, ist es umso wichtiger, dass die physikalischen Eigenschaften der Assets korrekt sind, sie tatsächlich fehlgeschlagene Fälle abdecken und die Leistung des realen Roboters verbessern – das erfordert das Urteil von Teams mit Erfahrung in der verkörperten Intelligenz. Es besteht immer noch eine Lücke zwischen dem Besitz von Produktionswerkzeugen und dem Wissen darüber, was genau produziert werden soll.
Die schwerer zu kopierende Akkumulation ist wahrscheinlich ein vollständiges System von Fähigkeiten zur kontinu