GPT-6 erreicht 99,9 % bei der ARC-AGI-Prüfung, die vorhandenen Prüfungsunterlagen müssen zwangsläufig neu erstellt werden, die nächste Prüfungsstufe widmet sich dem Thema „Erfindung“.
Die KI löst die Prüfungsaufgaben fast mit voller Punktzahl – was kann die nächste Prüfung noch abfragen?
Als GPT-6 Astra auf den Markt kam, erzielte es eine Erfolgsquote von 99,9 % im halbprivaten Testdatensatz von ARC-AGI-3.
Mit den eigenen Worten von OpenAI: Es ist vollständig „gesättigt“.
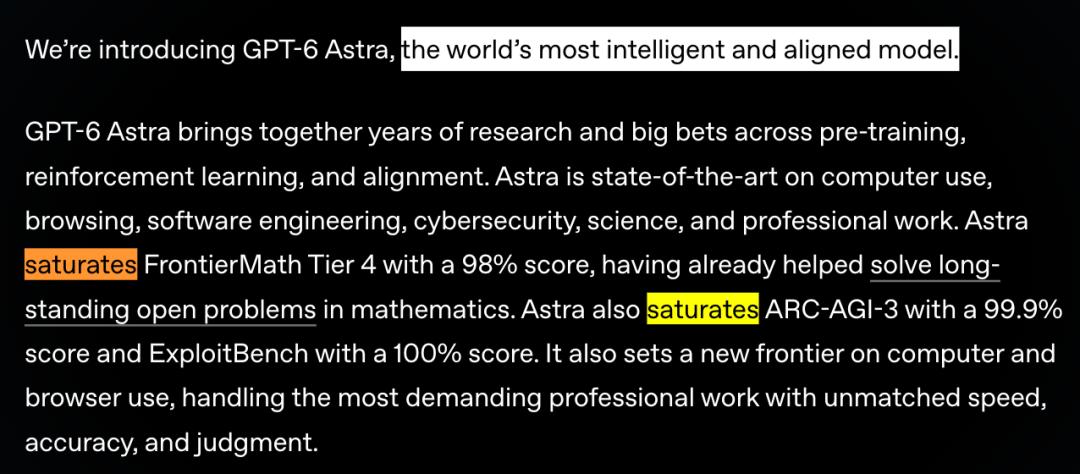
Unerwarteterweise hat sein Erscheinen das ursprüngliche Konzept von ARC-AGI vollständig zunichte gemacht.
Die im Voraus geplante ARC-Serie muss nun neu formuliert werden.
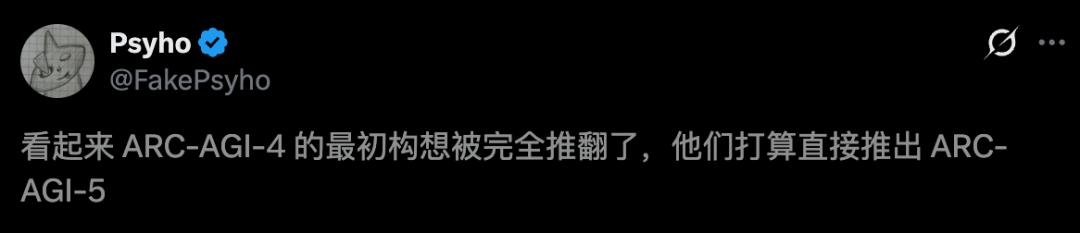
Heute hat François Chollet, Gründer von ARC Prize, den Entwurf für die nächste Generation der Bewertung offiziell vorgestellt:
ARC-AGI-4 soll wie geplant im ersten Quartal nächsten Jahres erscheinen, während das wirklich bahnbrechende ARC-AGI-5, das sogar als „die letzte Prüfung der Menschheit“ bezeichnet wird, vollständig auf die Tagesordnung gesetzt wurde.
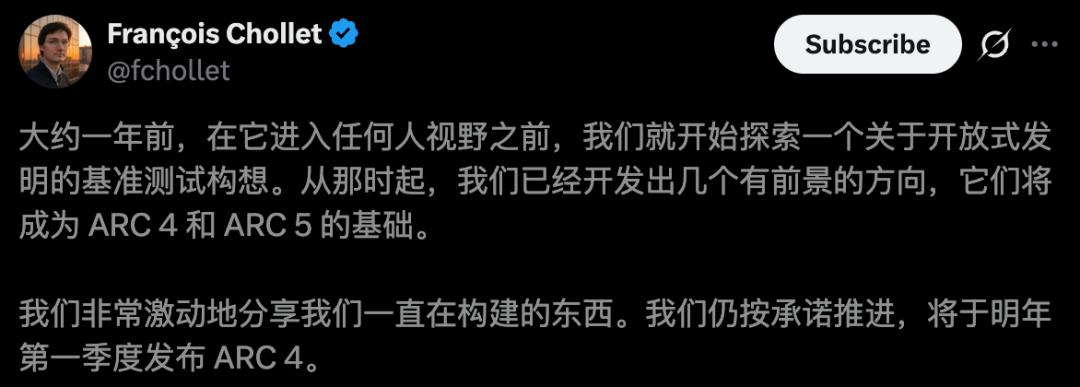
ARC 4 konzentriert sich auf kontinuierliches Lernen und Curriculum-Lernen in längeren Zeiträumen; ARC 5 dreht sich vollständig um das Thema „Erfindung“.
Er erklärte sogar: „Wenn es keine objektiv messbare Lücke zwischen der Lerneffizienz von KI und der des Menschen mehr gibt, ist das der wahre Moment der AGI.“
GPT-6 hat ARC-AGI-3 dank Ingenieurwissenschaft vollständig übertroffen
Die Leistung von GPT-6 Astra auf ARC-AGI-3 ist einer der dramatischsten Momente im KI-Umfeld des Jahres 2026.
Im Rahmen des „Standard-Testframeworks“ von ARC Prize erreichte Astra 62,7 %.
Diese Punktzahl ist natürlich bereits der höchste Stand der Geschichte, aber sie ist noch weit von der vollen Punktzahl entfernt.
Als OpenAI jedoch seinen eigenen Provider Adapter anschloss, stieg die Punktzahl desselben Modells direkt auf 99,9 %.
Dies ist ein Kontextverwaltungsadapter, der den verborgenen Schlussfolgerungszustand des Modells zwischen mehreren Aufrufen beibehalten kann, sodass die KI Fähigkeits-Plugins auf eine Weise nutzen kann, die der Produktionsumgebung näher kommt.
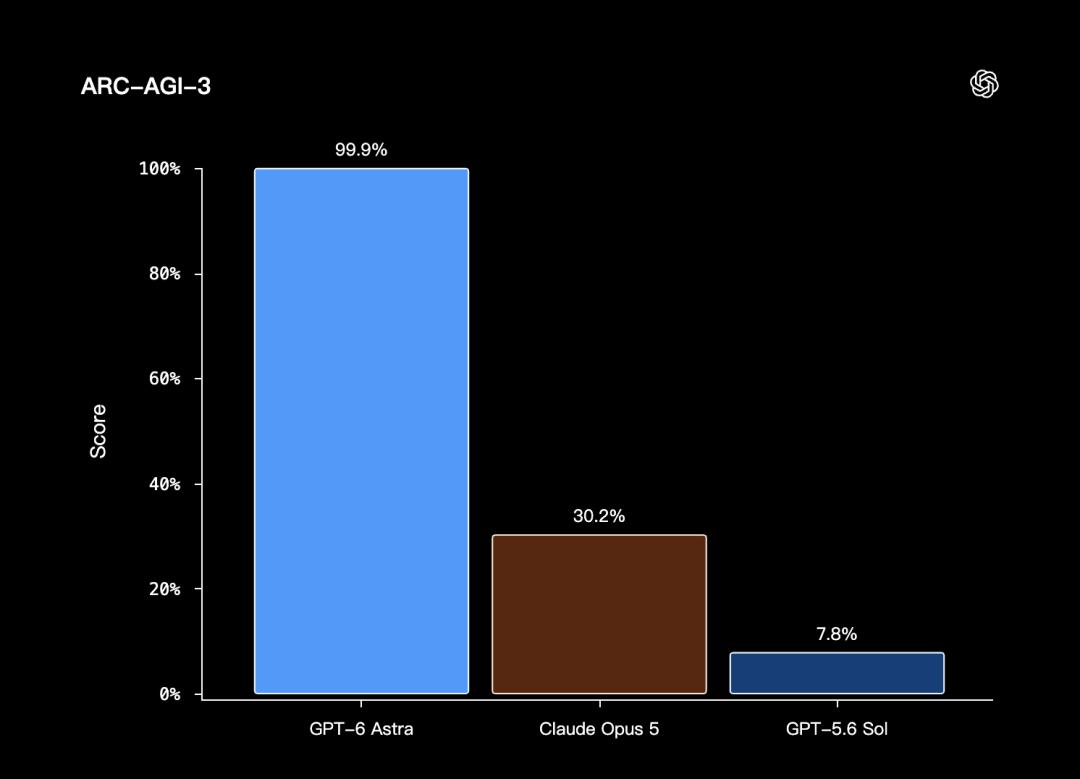
Das Ergebnis ist: Mit denselben Gewichtungen und denselben Aufgaben ergab sich ein Unterschied von 36 Prozentpunkten bei der Punktzahl.
Die Glaubwürdigkeit der Rangliste von ARC-AGI-3 wird daher neu bewertet, und der Schwerpunkt der Debatte hat sich von „welches Modell hat eine bessere Generalisierungsfähigkeit“ zu „welcher Harness ist fairer“ verschoben.
Das ist kein Einzelfall. Derselbe Gewichtungssatz von Claude Opus wurde im privaten Satz von ARC-AGI-3 mit 30 % validiert und erreichte nach Verwendung eines besseren Harness 95,5 %.
AVO von NVIDIA erzielte sogar 100 % im öffentlichen Demonstrationssatz.
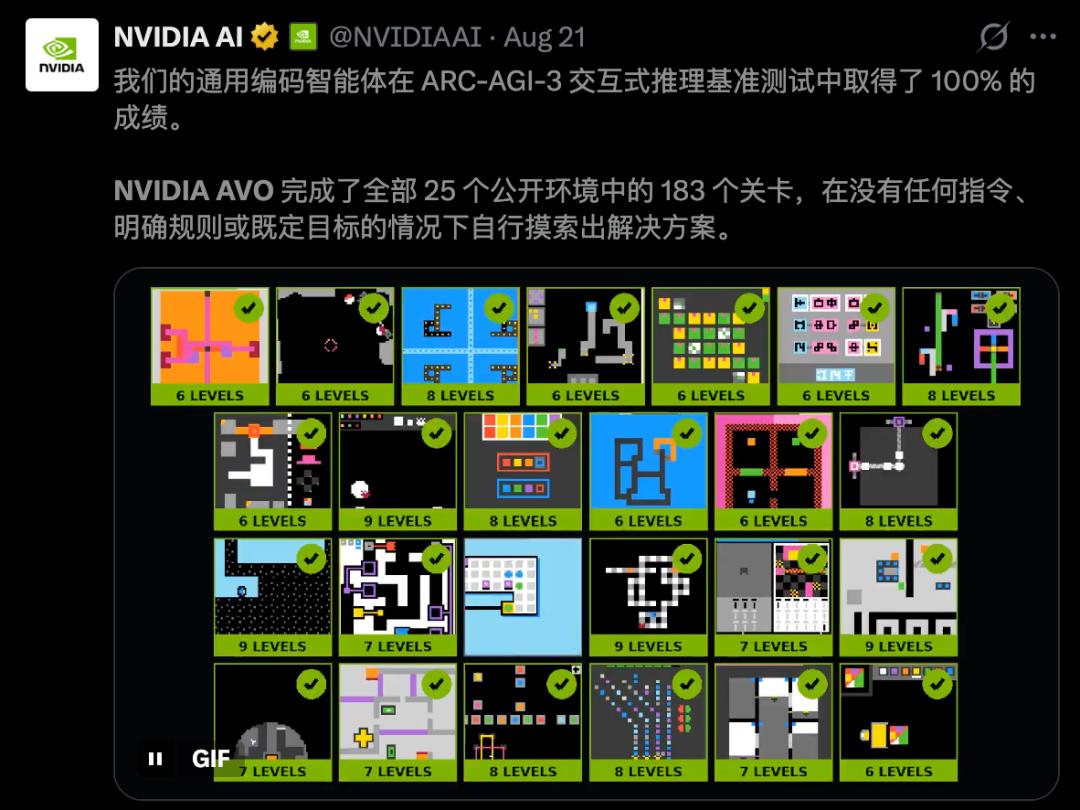
Die „Sättigung“ von ARC-AGI-3 ist eher ein Ereignis der Bewertungs-Ingenieurwissenschaft.
Was wird bei ARC-AGI 3 getestet
Bei den beiden vorherigen Generationen ARC-AGI-1 und ARC-AGI-2 ging es im Kern noch darum, „Regeln aus Bildern zu erkennen“.
Das System liefert mehrere kleine Gitterbilder im Format „Eingabe → Ausgabe“, die KI erratet die Regel und zeichnet dann die Ausgabe einer neuen Gruppe.
Dies sind statische Aufgaben mit eindeutigen Antworten, die auf der Fähigkeit beruhen, Regeln aus wenigen Beispielen zu induzieren.
Bei ARC-AGI-3 wurde die Prüfungsmethode vollständig geändert.
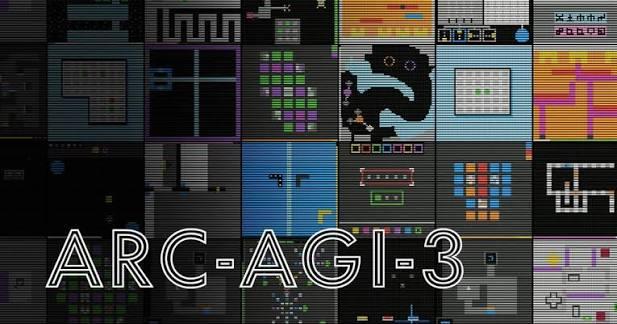
Es versetzt die KI direkt in eine Spielwelt und lässt sie in über 1000 Levels selbst spielen, selbst experimentieren und selbst die Regeln finden.
Jedes Spiel hat seine eigene interne Logik, verborgene Regeln und Bedingungen für das Bestehen des Levels.
Es gibt keine Dokumentation, keine Hinweise in natürlicher Sprache und niemand sagt Ihnen, dass Sie drei rote Blöcke sammeln müssen, um das Level zu bestehen.
Die KI kann nur das aktuelle Bild sehen, eine Aktion auswählen, das Ergebnis beobachten und dann den nächsten Schritt entscheiden.
Wie ein Blinder, der einen Elefanten tastet, tastet sie sich Schritt für Schritt vor und fügt in ihrem Kopf ein Modell zusammen, das beschreibt, wie diese Welt wahrscheinlich funktioniert.
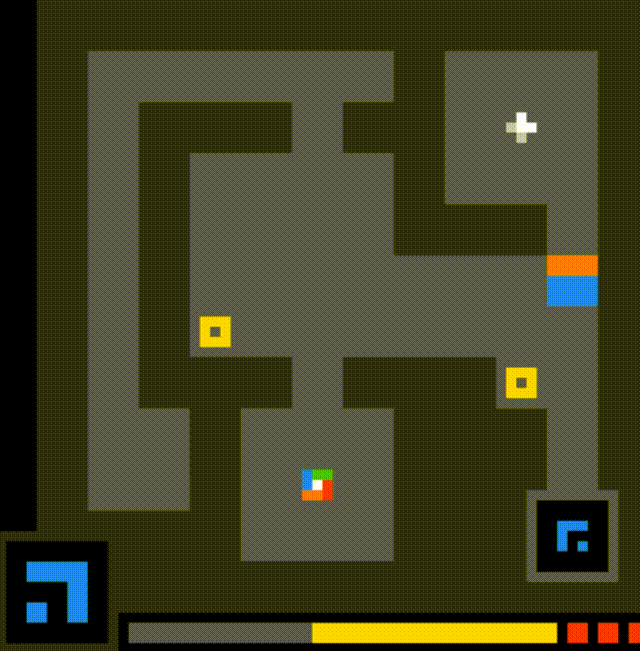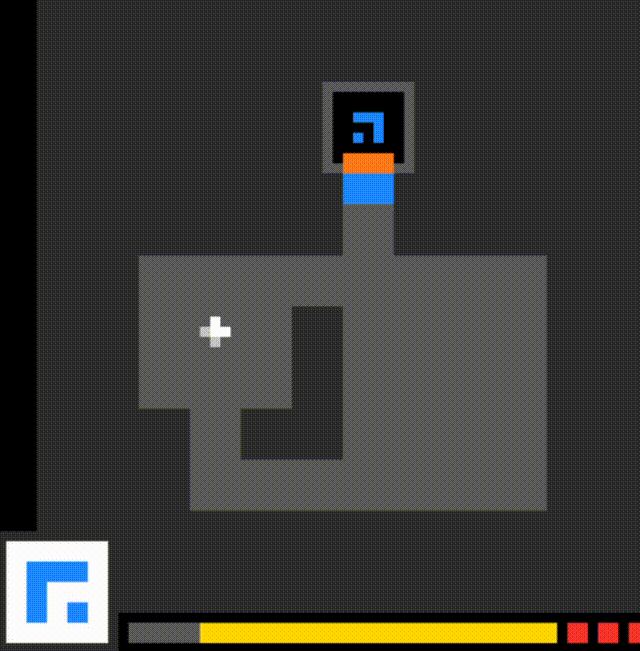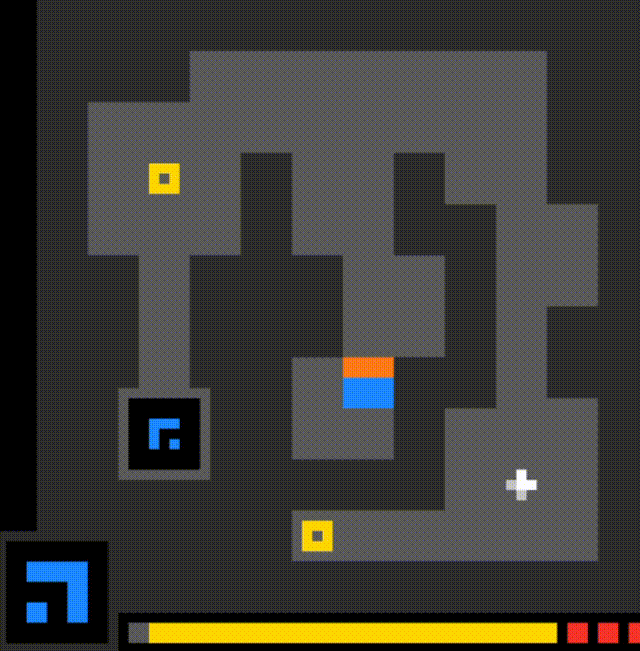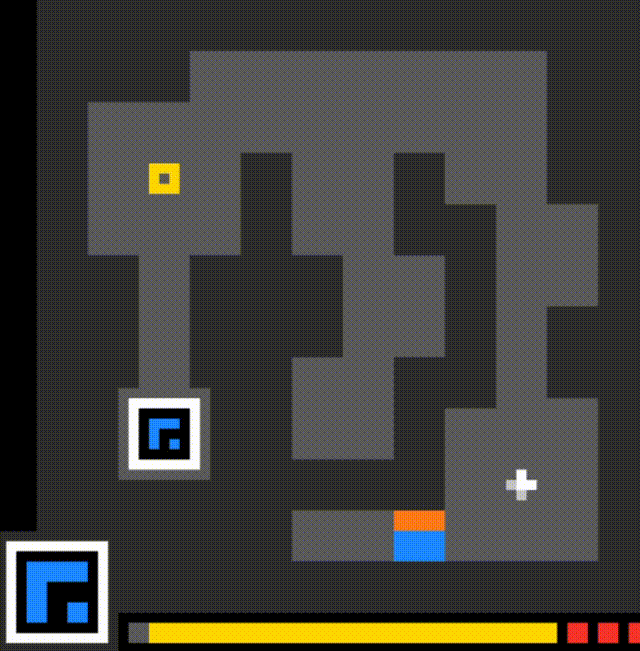
Das ARC Prize Team hat vier Dinge klar aufgelistet, die dieser Benchmark messen soll: Erkundung; Modellierung; Zielerreichung; Planung und Ausführung.
GPT-6 Astra hat 96 % der Aufgaben in den Levels mit weniger Schritten als der Medianwert des Menschen abgeschlossen, und die durchschnittliche Anzahl der Aktionen pro Level ist um 51,7 % geringer.
ARC Prize bezeichnet dies als „stufenweise Veränderung der Fähigkeiten“, betont aber gleichzeitig: Die Sättigung des Benchmarks bedeutet nicht den Nachweis von AGI.
Denn diese Umgebungen sind „begrenzt“ und deterministisch, nicht offen.
Die nächste Prüfung zwingt die KI, zu „erfinden“
Nach dem ursprünglichen Plan sollte ARC 4 den Geist von ARC 3 fortsetzen, aber sich stärker auf kontinuierliches Lernen und Curriculum-Lernen in längeren Zeiträumen konzentrieren.
Jedes Spiel hat viel mehr Levels, und die Levels sind „zinseszinsartig“, sodass jedes Level das Wissen wiederverwenden muss, das in den vorherigen Levels erlernt wurde.
Jetzt hat Chollet das „offene Erfinden“ in die gemeinsame Entwicklungsgrundlage von ARC 4 und ARC 5 aufgenommen.
Wie also werden Aufgaben für die „Erfindungsprüfung“ gestaltet?
ARC 1 bis 3 haben eine gemeinsame Voraussetzung: Es gibt eine „richtige“ Antwort oder einen „Gewinnzustand“, und der Mensch kann sie beim ersten Versuch erreichen, sodass der Mensch als Maßstab verwendet werden kann.
Die gesamte menschliche Basislinie von ARC 3 wurde aus den Daten von 486 Personen mit insgesamt 2893 Versuchen ermittelt.
Die Definition von Erfindung beinhaltet bereits „etwas, das es vorher nicht gab“, es gibt keine Standardantwort und daher keine vorhandene menschliche Basislinie, die man als Referenz verwenden kann.
Sie können nicht sagen, wie viele Schritte der Mensch für die Erfindung dieses Objekts benötigt hat. Wie soll man das dann konkret messen?
Ein möglicher Weg führt zurück zu Chollets „Definition“ der Intelligenz: Intelligenz besteht nicht darin, wie viele Fähigkeiten man beherrscht, sondern in der Effizienz, mit der man neue Fähigkeiten erwirbt.
Wenn man diesem Gedanken folgt, kann Erfindung gemessen werden – ob das neue Werkzeug, die neue Regel oder die neue Notation, die die KI erstellt hat, dazu führt, dass nachfolgende Probleme schneller gelöst werden.
Dass Astra Kurzschreibsymbole für Spiele erstellt, ist bereits der Vorläufer dieser Aktion. Es hat eine Zwischendarstellung erfunden und dadurch die Anzahl der Schritte um die Hälfte reduziert.
Bei der nächsten Prüfung wird ARC 5 diese Angelegenheit höchstwahrscheinlich zu „Teil der Prüfungsaufgabe selbst“ machen.
ARC 5 zielt direkt auf das Endziel ab – wie viele Prüfungen kann der Mensch noch erstellen?
Erwähnenswert ist, dass die Prüfungsaufgaben der ARC-Serie wahrscheinlich in der 6. oder 7. Generation enden werden.
Chollet hat einmal erklärt: Solange man Aufgaben vorschlagen kann, die der Mensch lösen kann, die KI aber nicht, wird man weiterhin Prüfungen erstellen;
Wenn man keine solchen Aufgaben mehr vorschlagen kann, wenn die Lücke zwischen der menschlichen Lerneffizienz und der der fortschrittlichen KI nicht mehr messbar ist, ist dieser Moment die AGI.
Die KI entwickelt sich so schnell weiter, dass die Zeit, die einer Prüfung bleibt, um zu beweisen, dass sie „schwierig genug“ ist, immer kürzer wird.
Sobald eine schwierige Aufgabe gemeistert wurde, muss der Aufgabensteller die nächste suchen.
Wenn die Punktzahlen sich der Obergrenze nähern, wird es immer schwieriger, mit den ursprünglichen Prüfungen zu unterscheiden, wie viel stärker die KI geworden ist und wo der Mensch noch vorne liegt.
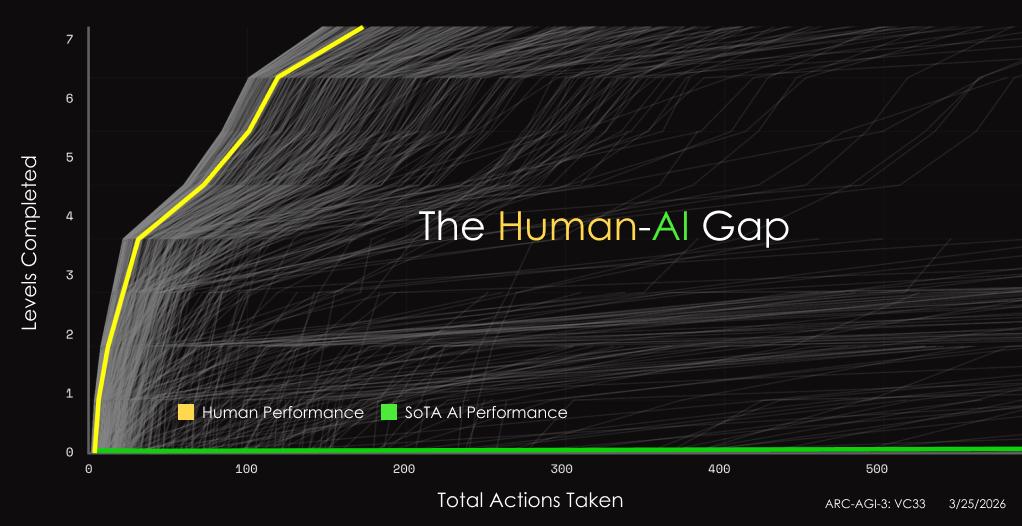
Betrachtet man diesen Trend, so ist ARC 5, das auf „Erfindung“ abzielt, wahrscheinlich auf der Suche nach einer Prüfungsaufgabe, die schwerer zu durchbrechen ist:
Die KI soll vordefinierte Lösungswege verlassen und neue Dinge schaffen, die validiert werden können und wiederverwendbar sind.
Wie lange diese Aufgabe halten wird, weiß derzeit niemand.
Aber wenn selbst das offene Erfinden keine Lücke mehr zwischen Mensch und KI aufrechterhalten kann, wird „keine Prüfung mehr möglich“ von einem Ausruf zu einem unvermeidlichen Thema in der Diskussion über AGI.
Die KI beschleunigt ihre Weiterentwicklung weiter – wie viele Prüfungen kann der Mensch noch erstellen?
Referenzmaterialien:
https://x.com/FakePsyho/status/2099086728963207537?s=20
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Neue Intelligenzquelle“, Autor: Taozi, veröffentlicht mit Genehmigung von 36Kr.