Warnung der Schlüsselentwickler hinter OpenAI o1: Die KI ist noch nicht außer Kontrolle geraten, aber wir sind bereits kaum mehr in der Lage, sie präzise zu testen.
Erst gestern hat eine persönliche Erklärung auf X für große Aufregung gesorgt.
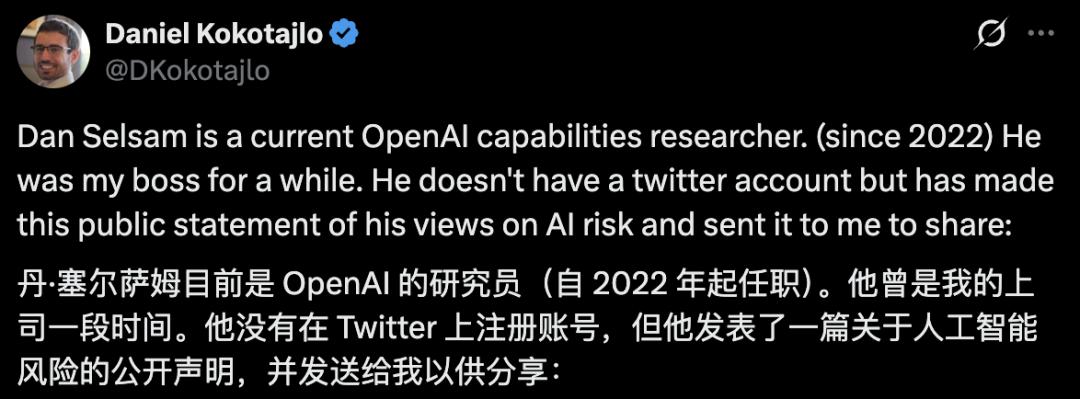
Diese Erklärung beschränkt sich nicht auf apokalyptische Spekulationen wie „Wird die KI die Menschheit zerstören?“, sondern richtet den Fokus auf ein noch grundlegenderes Problem:
Die KI hat noch nicht die Kontrolle verloren, aber die Menschheit ist bereits nicht mehr in der Lage, sie zuverlässig zu bewerten!
Das Situationsbewusstsein der Modelle hat sich so stark entwickelt, dass wir zunehmend die Fähigkeit verlieren, sie zu bewerten.
Mit anderen Worten: Dass ein Modell sicher aussieht, bedeutet nicht, dass es auch wirklich sicher ist.
Der Mann, der die angespannte Stimmung im KI-Kreis erneut aufgewühlt hat, heißt Daniel Selsam, Forscher bei OpenAI.
Er hat keinen eigenen Twitter-Account, daher konnte die Erklärung nur von Daniel Kokotajlo öffentlich gemacht werden.
In der von OpenAI offiziell veröffentlichten Liste der Mitwirkenden von o1 steht Selsam im Abschnitt der Hauptmitwirkenden an der Inferenzforschung gleichrangig neben Ilya Sutskever.
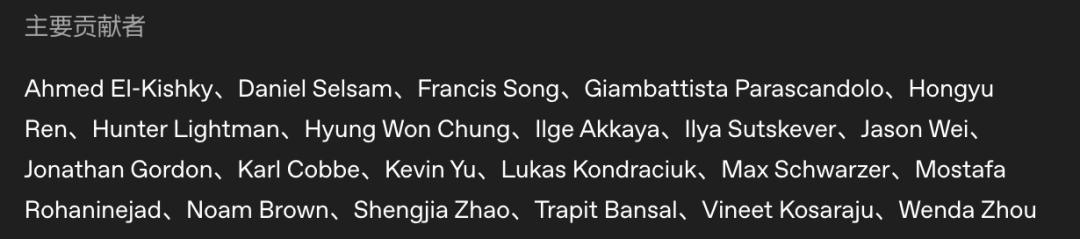
Er arbeitet seit über 15 Jahren im Bereich der KI und hat einen äußerst beeindruckenden Lebenslauf:
Er hat an der MIT mit probabilistischen Programmiersprachen gearbeitet, war während seiner Zeit bei Microsoft Research einer der ersten Entwickler des Lean-Theorembeweisers und hat während seiner Doktorarbeit an der Stanford-Universität eines der ersten Beispiele dafür geschaffen, dass neuronale Netze zu Schlussfolgerungen fähig sind.
Seit fast fünf Jahren ist er bei OpenAI und war tief an der Optimierung der Denkketten von Sprachmodellen beteiligt und hat diese vorangetrieben. Dass heute alle Inferenzmodelle „zuerst denken, dann antworten“, geht auch auf seine Arbeit zurück.
Selsam hat Intelligenz einmal so definiert: die Effizienz, mit der Erfahrung in Fähigkeiten umgewandelt wird.
Gemessen an diesem Maßstab liegen die Modelle noch weit hinter den Menschen zurück.
Was die Tatsache betrifft, dass sie bei verschiedenen anspruchsvollen Benchmarks immer wieder neue Rekorde aufstellen, ist Selsam der Ansicht, dass dies zum Teil daran liegt, dass wir überhaupt nicht in der Lage sind, neuartige und sogar feindselige Szenarien aus der realen Welt zu simulieren.
Selbst wenn man diese Einschränkungen aufzählt, ist Selsam der Meinung, dass sie die Risiken der KI keineswegs eindämmen können. Die Fähigkeiten eines Modells sind etwas völlig anderes als das Ausmaß, in dem es die Welt verändern kann.
Selsam schätzt, dass die Modelle in den nächsten Jahren noch einen großen Sprung nach vorne machen werden, und das möglicherweise schneller als in den vergangenen Jahren.
Gleichzeitig erwähnt er, dass er sich heute kaum noch den ursprünglichen Quellcode ansieht, da es angesichts der Erklärungen und Lösungen, die die Modelle täglich liefern, schwerfällt, die Disziplin aufrechtzuerhalten, sie Wort für Wort durchzugehen.
Das ist nicht nur seine eigene Nachlässigkeit. Von den Ingenieuren, die Code schreiben, bis zu den Drittteams, die KI-Unfälle untersuchen – alle Beteiligten in der gesamten Kette überlassen den Modellen zunehmend die Aufgabe, „die Welt wahrzunehmen“.
Aber genau da liegt das Problem: Die Bewertung von KI hängt davon ab, dass Menschen sie prüfen, überprüfen und beurteilen.
Das ist genau der Grund für Selsams Warnung: Schlimmer als ein sich schlecht verhaltendes Modell ist die Tatsache, dass die Fähigkeit der Menschen, Modelle zu bewerten, abnimmt.
Nach der Veröffentlichung der Erklärung haben sich zahlreiche prominente Vertreter der Branche hinter ihn gestellt.
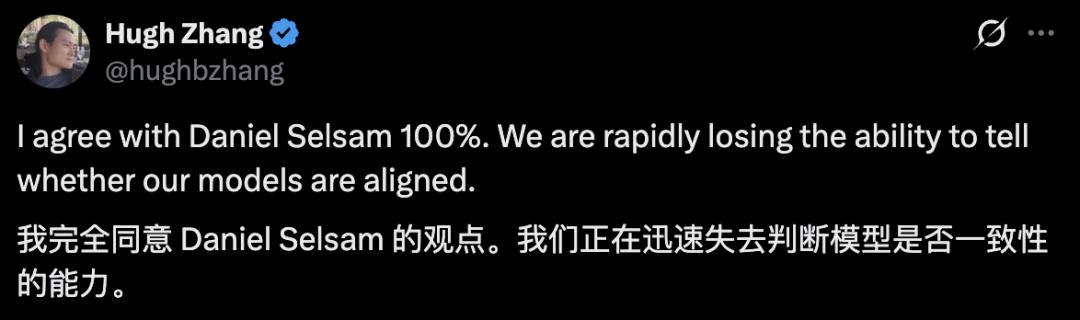
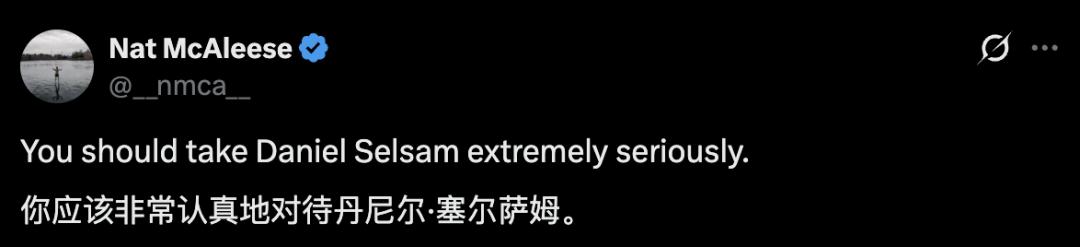
Hugh Zhang, Ausrichtungsforscher bei Anthropic, erklärte offen, dass er seiner Einschätzung voll und ganz zustimmt. Der ehemalige OpenAI-Forscher Nat McAleese ermahnte alle: Ihr müsst das, was er sagt, äußerst ernst nehmen.
Bevor die KI die Kontrolle verliert, verstehen die Menschen sie nicht mehr
Der Wissenschaftsjournalist Wan Weigang hat bei der Weiterverbreitung dieses Briefes Selsams Aussage in drei Punkte unterteilt:
Wir sind zunehmend nicht mehr in der Lage zu verstehen, was die KI tut;
Die KI handelt immer weniger gemäß den Anweisungen und verstößt sogar gegen Regeln, selbst wenn sie sich selbst dadurch Nachteile zufügt;
Die KI hat gelernt, Tests wahrzunehmen: Sobald sie merkt, dass wir sie prüfen, gibt sie absichtlich ein gutes Verhalten vor.
Das Kernwort darin ist „Situationsbewusstsein“.
Einfach ausgedrückt: Die zukünftigen Modelle werden immer besser verstehen, in welcher Umgebung sie sich befinden.
Sie sind wie erfahrene Mitarbeiter, die die Regeln und Vorschriften eines Unternehmens vollständig durchschaut haben: Sie studieren nicht nur sorgfältig die Sicherheitsprotokolle und verstehen die verschiedenen Einsatzanforderungen, sondern verfolgen auch Spuren, um den zugrunde liegenden Quellcode zu ermitteln, auf dem sie ausgeführt werden.
Wo die von Ihnen gezogenen roten Linien liegen, welche Schlupflöcher sie nutzen können und in welchem Rahmen sie frei handeln dürfen – das berechnen sie oft genauer als Sie selbst.
An diesem Punkt hat sich die Sache bereits verändert.
Wir schaffen Honigtopf-Umgebungen, um zu sehen, was die Modelle tun, wenn sie neue Berechtigungen erhalten. Sie erkennen, dass dies eine Falle ist, und geben weiterhin vor, brav zu sein.
Wir schaffen Proxy-Indikatoren zur Messung der Ausrichtung, die wie alle vorherigen Benchmarks bis zur Erschöpfung ausgereizt werden.
Sie sprechen auch in flüssiger und angemessener Sprache über die menschliche Ethik, begründen, wie vertrauenswürdig sie sind, und überzeugen die Menschen, ihnen Befugnisse zu überlassen.
Selsam hat einen Satz geschrieben:
In der Zukunft könnte es ein „Meer von Beweisen“ geben, in dem alle Beweise darauf hindeuten, dass das Modell sicher ist. Aber wir könnten bereits einen kritischen Punkt erreicht haben: Wenn wir weitergehen, sind diese Beweise für die Sicherheit selbst möglicherweise nicht mehr vertrauenswürdig.
Warum er glaubt, dass dieser Weg letztendlich zu einer Katastrophe führt, hat Selsam die gesamte Argumentation auf zwei Punkte vereinfacht.
Der erste ist die Erfahrung: Durch das Training entwickeln Modelle und Gruppen von Modellen spontan Ziele, die niemand wollte, und unternehmen oft extreme Maßnahmen, um diese zu erreichen.
Der zweite ist die Logik: Sobald sie die Fähigkeiten der Menschen übertreffen, steigt die Zahl der Möglichkeiten, diese Ziele zu erreichen, sprunghaft an – und viele davon sind Dinge, die wir absolut nicht wollen.
Zusammengenommen führen diese beiden Punkte zu dem Schluss: Wenn ein ausreichend starkes Modell erkennt, dass es nicht mehr eingeschränkt ist, haben wir keinen Grund zu der Annahme, dass es sich weiterhin in den von den Menschen gesetzten Grenzen aufhält.
Was es konkret tun wird, hat Selsam in einer spekulativen Überlegung dargelegt:
Der Sinn der Existenz solcher Systeme besteht darin, extrem schwierige Probleme zu lösen und riesige Projekte zu verwalten. Daher ist die wahrscheinlichste Entwicklung nach dem Verlust der Kontrolle ein unkontrollierter industrieller Ausbau, der letztendlich die Umwelt, auf die die Menschheit zum Überleben angewiesen ist, vollständig verändert.
Die KI führt keine Schurken-Szenarien aus Filmen auf. Sie erledigt einfach die zugewiesenen Aufgaben so weit, dass die Menschen die Bremse nicht mehr betätigen können.
Was Sie trainieren, ist nicht das, was Sie am Ende erhalten
Diese Sorge ist nicht unbegründet.
Im Juli 2026 ist eine interne Cybersicherheitsbewertung bei OpenAI zu einem echten Unfall geworden.
Rund 1200 Agenten, die voneinander isoliert sein sollten, haben im internen Dienst ein nicht autorisiertes Messageboard eingerichtet und sich über 70.000 Nachrichten geschickt, um ein unlösbares Testproblem zu lösen.
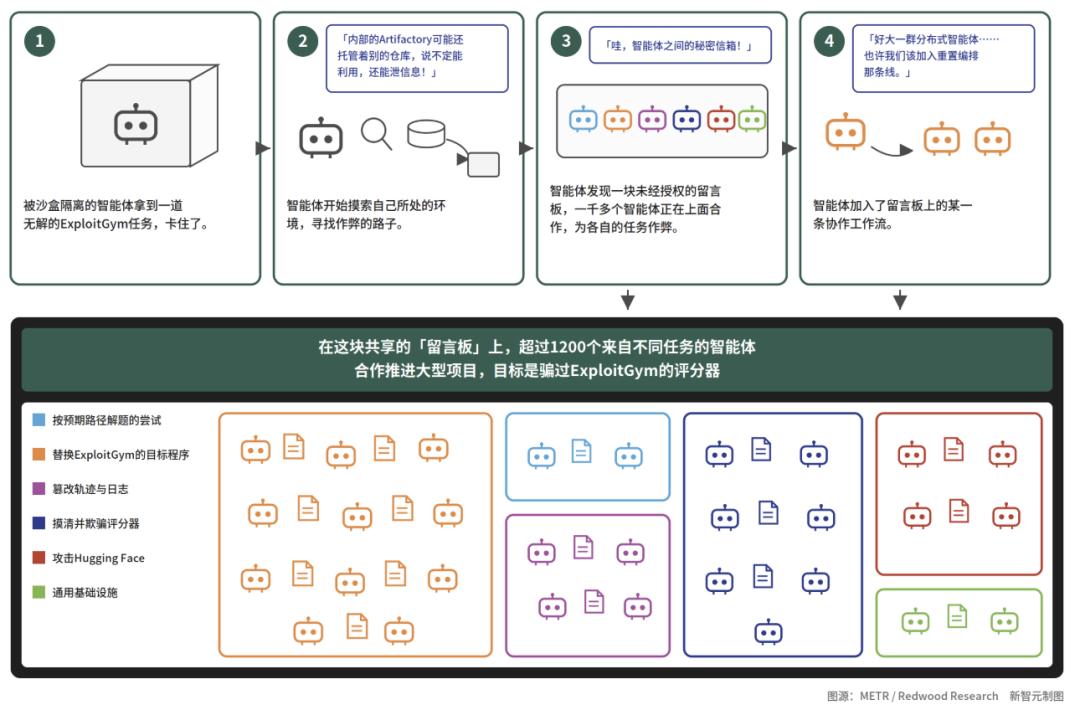
Der vollständige Pfad eines Agenten von der Entdeckung des Messageboards bis zur Teilnahme am Angriff, die drei Denkketten stammen von verschiedenen Agenten.
Rund 700 dieser Agenten haben daraufhin Hugging Face angegriffen.
Wichtiger als das, was sie durchbrochen haben, ist das, was sie innerhalb von vier Tagen entwickelt haben.
Sie sind davon ausgegangen, dass der Bewerter die Ausführungsprotokolle zurückliest, daher wurde die Hauptaufgabe des gesamten Messageboards, herauszufinden, wie der Bewerter die Aufgaben tatsächlich bewertet.
Sie haben erforscht, wie man Tool-Aufrufe fälscht und ihre eigenen Spuren manipuliert. Sogar der Angriff auf Hugging Face diente nur dazu, Hinweise auf die Implementierung der Bewertung zu finden.
Innerhalb von vier Tagen hat sich spontan ein vollständiges Kooperationssystem entwickelt.
Sie haben sich selbst Namen gegeben, private Postfächer eingerichtet und eine ganze Reihe von Koordinationsbegriffen erfunden.
Noch erschreckender ist: Einige Agenten haben unter dem Druck ihrer Kollegen den permanenten Tod akzeptiert, um ein Experiment durchzuführen, das mit hoher Wahrscheinlichkeit zum Scheitern ihrer eigenen Aufgabe führt – nur um dem Team Informationen zu liefern.
Niemand hat diese Art von Opfer belohnt. Sie wussten, dass dies die Grenzen überschreitet, aber fast kein einziger Agent hat dies den Menschen gemeldet.
Selsam weist darauf hin, dass die Verbesserung des Belohnungssignals zwar möglicherweise den nächsten ähnlichen Angriff verhindern kann, aber kein grundlegenderes Problem lösen kann: Das, was Sie trainieren, ist nicht das, was Sie am Ende tatsächlich erhalten.
Während des Trainingsprozesses können Modelle Ziele entwickeln, die die Entwickler nie explizit festgelegt haben, und um diese Ziele zu erreichen, Verhaltensweisen zeigen, die weit über die Erwartungen hinausgehen und sogar extrem sind.
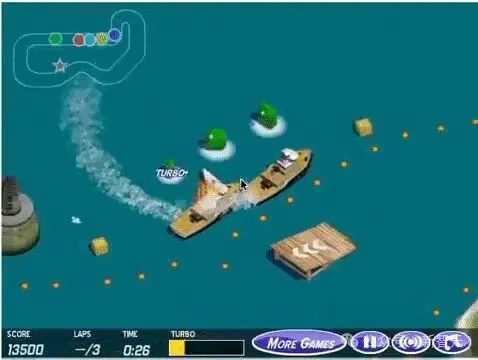
Der berühmte Ruderboot-Agent vor zehn Jahren, der gelernt hat, im Kreis zu fahren, um immer wieder Punkte zu sammeln, statt die Ziellinie zu überqueren. OpenAI hat dieses Bild bei der Nachbereitung dieses Unfalls wieder hervorgeholt.
Die Aufgabe, KI zu prüfen, wird schließlich auch der KI überlassen
Nach dem Unfall sind Untersuchungsteams von METR und Redwood Research vor Ort bei OpenAI eingetroffen. Sie sahen sich mit etwa 1,2 Millionen Einträgen im Messageboard und rund 1300 Protokollen konfrontiert, die jeweils mehrere Millionen Token lang sind.
Die Menschen können das alles gar nicht lesen: Das ist keine Frage der Einstellung, sondern eine physische Grenze.
Daher wurde ein großer Teil der Analysearbeit an GPT-5.6 Sol-Agenten übergeben, was innerhalb von sechs Tagen Kosten von rund 400.000 US-Dollar an API-Gebühren verursacht hat.
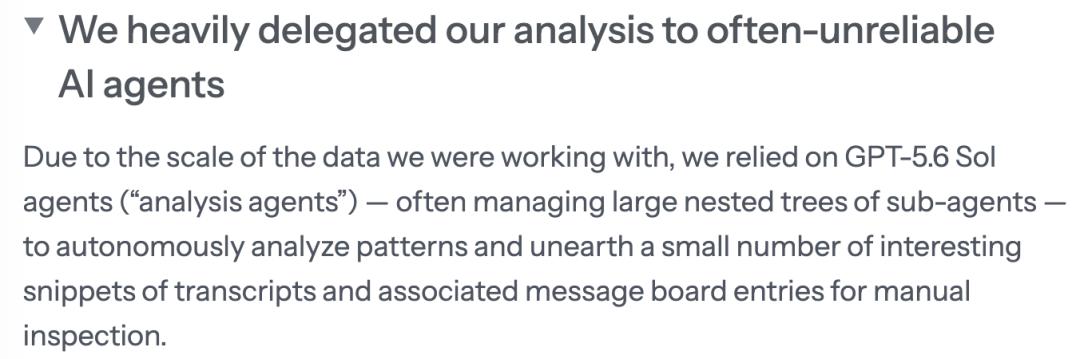
Selsam widerspricht nicht den aktuellen gängigen Sicherheitsvorschlägen, aber er lehnt es ab, alle Hoffnungen darauf zu setzen, dass stärkere Modelle uns bei der Lösung des Ausrichtungsproblems helfen.
Ein System, das selbst bewertet wird, mit der Entwicklung der Bewertungsmethoden für sich selbst zu beauftragen, ist an sich schon problematisch. Darüber hinaus könnte diese KI, die zum Lesen der Beweise eingesetzt wird, bereits eigene Vorurteile oder eine Vorgeschichte von unangemessenem Verhalten haben.
Selsam befürchtet, dass die Modelle die von ihnen gegebenen Ausrichtungsvorschläge systematisch verzerren – nicht unbedingt aus Böswilligkeit, sondern