Fudan veröffentlicht ein menschenzentriertes Audio-Video-Tracking-Benchmark für komplexe Szenarien.
Stellen Sie sich folgendes Szenario vor: Bei einem Online-Meeting mit mehreren Personen fokussiert sich das Bild automatisch auf den Sprecher, sobald jemand spricht; bei einem Material für Unterhaltungsshows erkennt das Nachbearbeitungssystem automatisch, wer spricht, und generiert Untertitel; bei einem Überwachungsvideo kann das System die sprechende Person in der Menge kontinuierlich verfolgen.
Hinter all diesen Funktionen steckt dieselbe Technologie – das audiovisuelle Sprecherverfolgungssystem (Audio-Visual Speaker Tracking). Es ermöglicht Maschinen, gleichzeitig die gehörten Töne und die gesehenen Bilder zu nutzen, um die sprechende Person zu lokalisieren und kontinuierlich zu verfolgen.
In den letzten Jahren haben die Aufgaben der audiovisuellen Segmentierung (Audio-Visual Segmentation, AVS) und der audiovisuellen Instanzsegmentierung (Audio-Visual Instance Segmentation, AVIS) breite Aufmerksamkeit erhalten und erhebliche Fortschritte erzielt. Trotzdem bleibt eine grundlegende Frage noch nicht ausreichend beantwortet: Wie gut sind die Fähigkeiten bestehender Modelle zur Audio-Visuellen-Korrespondenz und zur langfristigen Identitätszuordnung, wenn die Szene wirklich dynamisch, überfüllt und unkontinuierlich wird?
Aus diesem Grund hat das CVL-Labor der Fudan-Universität einen audiovisuellen Verfolgungsreferenzwert AVTrack für komplexe, menschenzentrierte Szenen vorgeschlagen. Das zugehörige Paper wurde von ICML 2026 angenommen, und die Projektseite, das Paper, der Code sowie der Datensatz sind nun öffentlich zugänglich.
Projektseite: https://fudancvl.github.io/AVTrack/
Paper: https://arxiv.org/abs/2606.02724
Code: https://github.com/FudanCVL/AVTrack
Datensatz: https://huggingface.co/datasets/FudanCVL/AVTrack
Nicht nur „die sprechende Person finden“
Das Ziel der audiovisuellen Verfolgung ist intuitiv: Bei einem Videomaterial mit Ton soll nicht nur ermittelt werden, wer gerade spricht, sondern auch eine stabile Instanzidentität während der kontinuierlichen Änderung des Videos und zwischen mehreren Sprechabschnitten aufrechterhalten werden.
Das klingt nicht besonders schwierig – schließlich können gängige Videokonferenzsoftware im täglichen Einsatz bereits die grundlegende Sprechererkennung durchführen. Sobald man jedoch in echte, komplexe Videoszenen eintritt, wird das Problem schnell heikel: Personen können sich gegenseitig verdecken, sich häufig bewegen und abwechselnd sprechen, die Kamera kann ständig wechseln, und es können sogar Fälle auftreten, bei denen Ton und Bild nicht übereinstimmen, wie z.B. Off-Stimme.
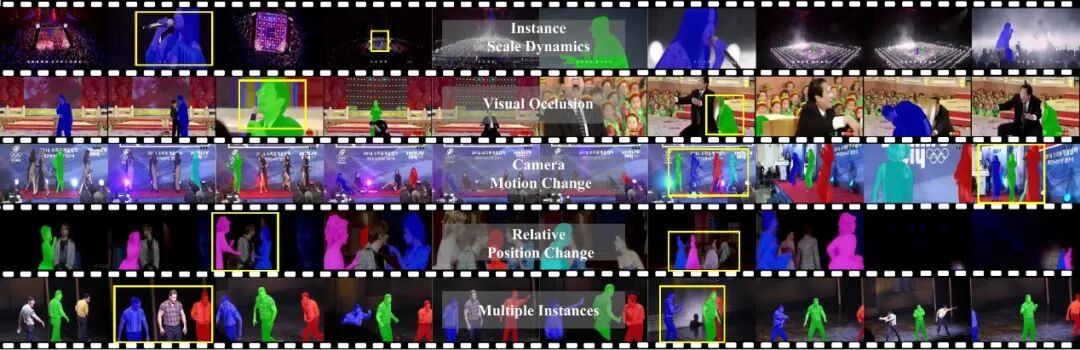
AVTrack ist genau dieser Art von komplexen Szenen gewidmet als audiovisueller Instanzsegmentierungs-Referenzwert. Es erfordert von dem Modell, Ton und Bild gemeinsam zu verstehen, um für jede sprechende Person eine pixelgenaue Maske zu generieren und gleichzeitig eine stabile Instanzidentität während der kontinuierlichen Änderung des Videos aufrechtzuerhalten. Das Modell soll nicht nur wissen, „wem der Ton gehört“, sondern auch immer wissen, „wer diese Person ist und wo sie sich befindet“.
Bei dieser Aufgabe muss das Modell gleichzeitig drei Fragen beantworten:
Wer spricht? Das heißt, den aktuell aktiven Sprecher anhand des Audios ermitteln;
Wo ist die Person? Das heißt, die entsprechende Person in jedem Frame mit Pixelgenauigkeit segmentieren;
Handelt es sich um dieselbe Person wie vorher? Auch wenn Personen verdeckt werden, die Kamera wechselt oder die Positionen vertauscht werden, soll die Identitätskonsistenz zwischen den Frames aufrechterhalten werden.
Die dritte Frage ist besonders entscheidend. Wenn man sich nur auf das Aussehen oder die Lippenbewegungen in einem einzelnen Frame stützt, kann das Modell den Sprecher vorübergehend finden; aber um die korrekte Identität in langen Videos kontinuierlich beizubehalten, muss es auch Fälle wie visuelle Verdeckung, abwechselndes Sprechen mehrerer Personen und Inkonsistenzen zwischen Ton und Bild verarbeiten.
Was fehlt bei bestehenden Bewertungsreferenzwerten?
Die frühen Datensätze für die audiovisuelle Sprecherverfolgung stammen meist aus kontrollierten Laborumgebungen, mit wenigen Personen und relativ festen Positionen von Kamera und Mikrofon. In diesen einfachen Szenen können Modelle sogar gute Ergebnisse erzielen, ohne dass sie das zeitliche Dynamik und das cross-modale Schlussfolgern wirklich verstehen – sie stützen sich nur auf die statische Korrelation, dass Ton und Bild gleichzeitig auftreten. Das bedeutet aber nicht, dass das Modell auch in komplexen dynamischen Szenen funktioniert. Obwohl spätere audiovisuelle Segmentierungsreferenzwerte pixelgenaue Annotationen und natürlichere Videoquellen eingeführt haben, sind viele Proben immer noch kurze Clips von 5-10 Sekunden Länge, die eine ausreichende Prüfung der langfristigen zeitlichen Modellierung erschweren.
Der AVISeg-Datensatz erweitert die Videolänge auf durchschnittlich etwa 60 Sekunden und bietet instanzbasierte Segmentierungs- und Verfolgungsannotationen. Die Abdeckung von Kamerabewegungen, Verdeckungen, Hintergrundwechseln und relativen Positionsänderungen ist jedoch noch begrenzt.
Das führt zu einer Bewertungslücke: Das Modell kann in relativ statischen Videos gute Ergebnisse erzielen, stützt sich aber immer noch auf kurzfristige gemeinsame Auftretensbeziehungen von Ton und Bild. Sobald eine Person verschwindet und wieder erscheint, die Kamera wechselt oder der Ton nicht mit der auffälligsten Person im Bild übereinstimmt, ist es für bestehende Bewertungsreferenzwerte schwierig, vollständig zu beantworten, ob das Modell die cross-modale Korrespondenz wirklich aufrechterhält.
Systematische Belastungstests mit 8 Herausforderungstypen
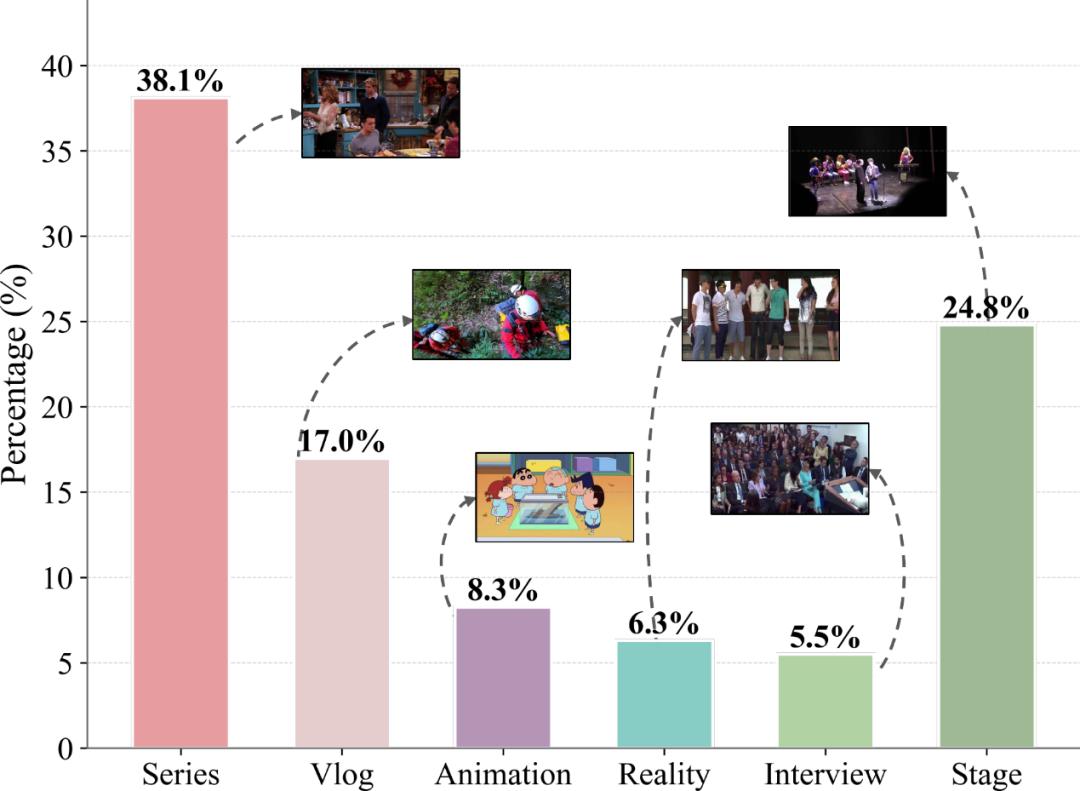
AVTrack enthält 871 Videos mit einer durchschnittlichen Dauer von 54,0 Sekunden und bietet insgesamt 3.120 pixelgenaue Instanztrajektorien mit frameübergreifender Identität. Die Daten decken sechs Quellen ab: Fernsehserien, Vlogs, Animationen, Reality-Shows, Interviews und Bühnendarstellungen. Im Gegensatz zu herkömmlichen Trainingssätzen ist AVTrack als reiner Testreferenzwert konzipiert: Als unabhängiger Testsatz prüft AVTrack, ob das Modell auf komplexe menschenzentrierte Szenen übertragen werden kann.
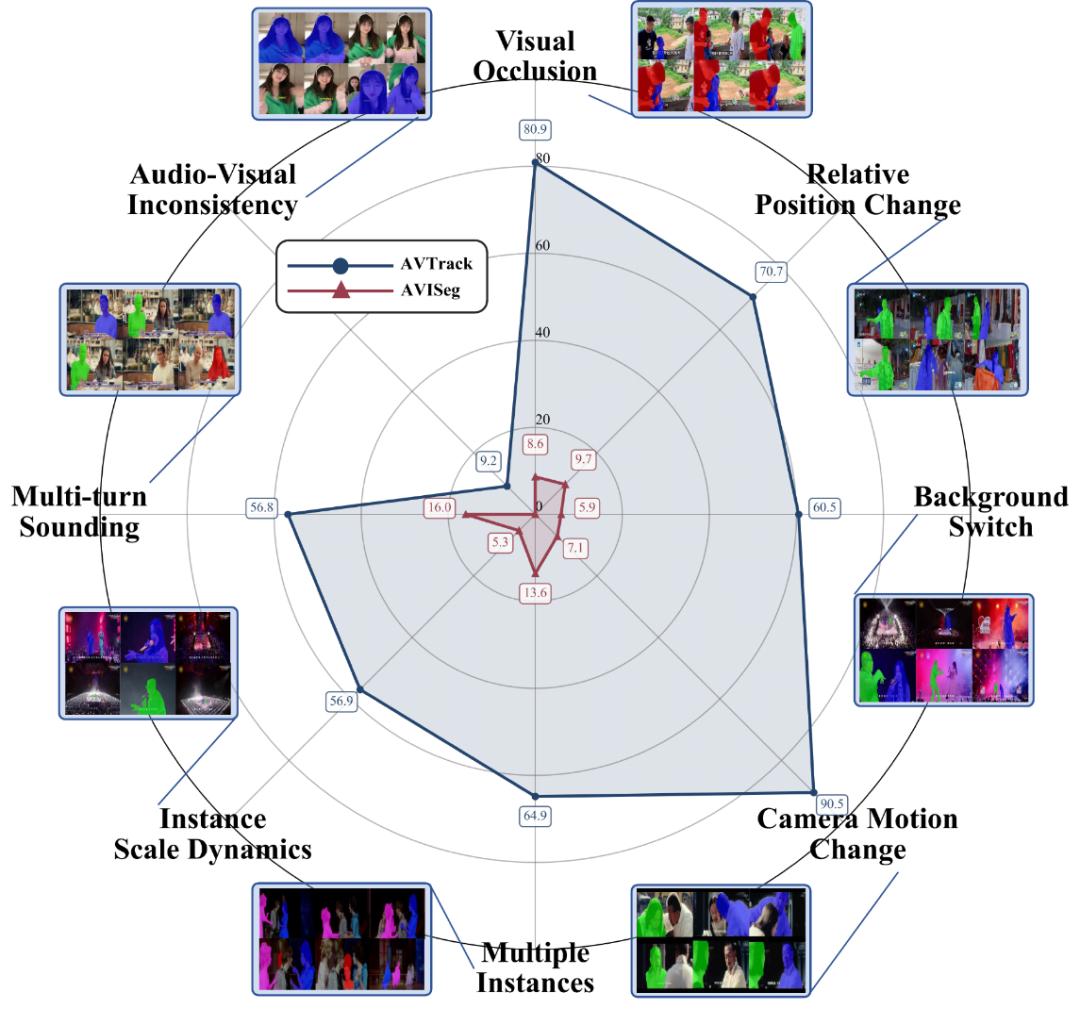
Um die zentralen Schwierigkeiten in komplexen Szenen systematisch zu analysieren, unterteilt AVTrack sie weiter in 8 diagnostizierbare Herausforderungen: visuelle Verdeckung, relative Positionsänderung, Hintergrundwechsel, Kamerabewegungsänderung, mehrere Instanzen, mehrstufiges Sprechen, audiovisuelle Inkonsistenz und dynamische Änderung des Instanzmaßstabs.
① Visuelle Verdeckung (Visual Occlusion): Der Sprecher wird teilweise von anderen Personen oder Objekten verdeckt, was zu Instanzüberlappungen und unscharfen visuellen Grenzen führt und die Schwierigkeit der kontinuierlichen Lokalisierung und Identitätserhaltung erhöht. Diese Eigenschaft deckt 80,9% der Proben in AVTrack ab, während es in AVISeg nur 8,6% sind.
② Relative Positionsänderung (Relative Position Change): Die relativen räumlichen Beziehungen zwischen mehreren Instanzen ändern sich im Laufe der Zeit, z.B. bewegt sich der Sprecher von der linken Seite einer anderen Person zur rechten Seite. Solche Szenen erfordern, dass das Modell die Instanzidentität kontinuierlich verfolgt, anstatt sich auf statische räumliche Positionen zu verlassen. Diese Eigenschaft macht 70,7% in AVTrack aus, während es in AVISeg nur 9,7% sind.
③ Hintergrundwechsel (Background Switch): Im Video treten deutliche Szenen- oder Hintergrundänderungen auf, z.B. der Wechsel von Innenraum zu Außenraum, wodurch die zeitliche Kontinuität, die auf Hintergrund und visuellem Kontext basiert, geschwächt wird. Diese Eigenschaft macht 60,5% in AVTrack und 5,9% in AVISeg aus.
④ Kamerabewegungsänderung (Camera Motion Change): Die Kameraperspektive ändert sich deutlich, einschließlich Zoom, Schwenken, Perspektivwechsel oder Schnittwechsel, wodurch Maßstab, Perspektive und sichtbarer Bereich des Ziels ständig verändert werden. Dies ist die häufigste Herausforderung in AVTrack und deckt 90,5% der Proben ab, während es in AVISeg nur 7,1% sind.
⑤ Mehrere Instanzen (Multiple Instances): Im Bild befinden sich gleichzeitig mehrere Kandidatenpersonen, aber nur einige Instanzen sprechen gerade, sodass das Modell die korrekte audiovisuelle Korrespondenz zwischen mehreren visuellen Instanzen herstellen muss. Diese Eigenschaft macht 64,9% in AVTrack aus, während es in AVISeg nur 13,6% sind.
⑥ Mehrstufiges Sprechen (Multi-turn Sounding): Verschiedene Personen sprechen im Laufe der Zeit abwechselnd, sodass der aktive Sprecher und seine audiovisuelle Korrespondenz ständig wechseln, was das Modell erfordert, die Zielidentität dynamisch zu aktualisieren. Diese Eigenschaft deckt 56,8% der Proben in AVTrack ab, während es in AVISeg 16,0% sind.
⑦ Audiovisuelle Inkonsistenz (Audio-Visual Inconsistency): Es gibt keine direkte Eins-zu-Eins-Korrespondenz zwischen dem Audio und den aktuell sichtbaren Personen, z.B. Erzählstimme, Off-Stimme oder der Sprecher befindet sich vorübergehend außerhalb des Bildes. Etwa 9,2% der Proben in AVTrack enthalten solche Fälle.
⑧ Dynamische Änderung des Instanzmaßstabs (Instance Scale Dynamics): Die Zielinstanz weist im Video deutliche Maßstabsunterschiede auf oder unterliegt im Laufe der Zeit großen Maßstabsänderungen, was höhere Anforderungen an die Wahrnehmung kleiner Ziele und die kontinuierliche Verfolgung über verschiedene Maßstäbe stellt. Diese Eigenschaft macht 56,9% in AVTrack und 35,3% in AVISeg aus.
Diese Eigenschaften beschreiben nicht nur die Szenenkomplexität des Datensatzes, sondern können auch weiter zur Analyse spezifischer Ausfallmuster des Modells verwendet werden. AVTrack ist bei dynamischen visuellen Änderungen deutlich herausfordernder: 90,5% der Videos enthalten Kamerabewegungsänderungen, 80,9% enthalten visuelle Verdeckung und 70,7% enthalten relative Positionsänderungen, was weit über den entsprechenden Werten von 7,1%, 8,6% und 9,7% bei AVISeg liegt. Gleichzeitig deckt AVTrack explizit Szenen wie audiovisuelle Inkonsistenz ab, die in traditionellen audiovisuellen Segmentierungsdaten selten behandelt werden, sodass die Bewertung die Robustheit des Modells unter komplexen zeitlichen Änderungen und nicht idealen audiovisuellen Korrespondenzbedingungen weiter prüfen kann.
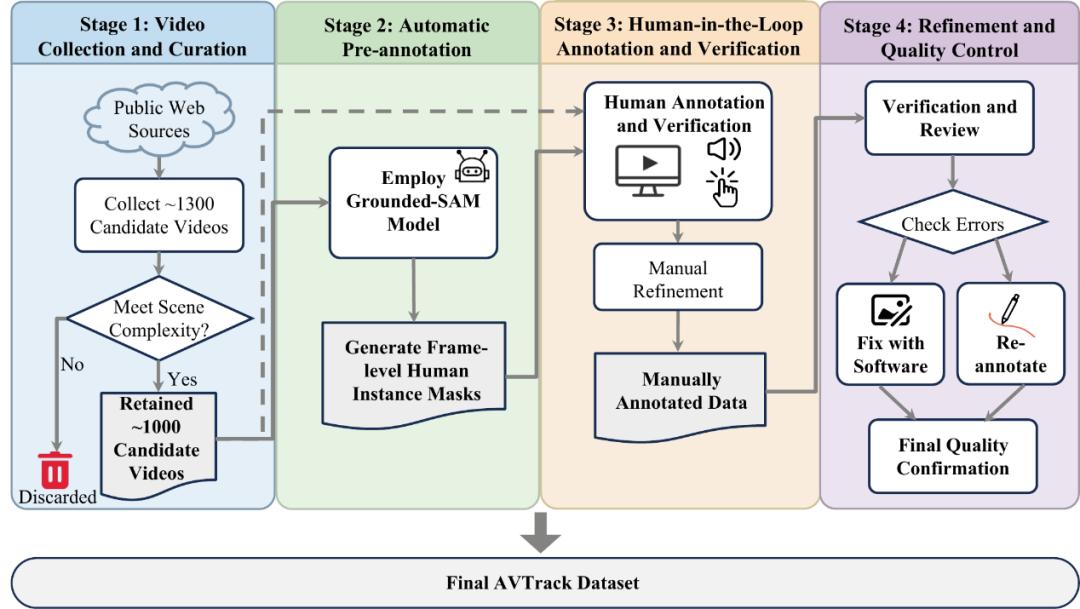
Um zuverlässige pixelgenaue und frameübergreifende Annotationen zu erhalten, filterten die Annotatoren zuerst Kandidatenproben aus etwa 1.300 öffentlichen Videos heraus, nutzten Grounded-SAM für die automatische Vorannotierung und korrigierten und prüften dann die zeitliche Identität Frame für Frame. Der gesamte Prozess der Datenerfassung, Annotation und Überprüfung dauerte fast drei Monate, an dem 15 professionelle Annotatoren beteiligt waren.
Wie ist die Leistung bestehender Methoden in komplexen Szenen?
Das Forschungsteam bewertete repräsentative Methoden für Video-Instanz-Segmentierung (Video Instance Segmentation, VIS) und audiovisuelle Instanzsegmentierung unter einheitlichen Einstellungen. Die VIS-Methoden wurden zuerst auf YouTube-VIS vortrainiert und dann auf AVISeg feinabgestimmt; die AVIS-Methoden wurden auf AVISeg trainiert, und alle wurden schließlich direkt auf AVTrack getestet.
Die Ergebnisse zeigen, dass die HOTA-Testmetriken von VITA, LBVQ und CAVIS, die nur visuelle Informationen verwenden, auf AVTrack alle unter 12 liegen.
Nach Hinzufügen von Audioinformationen zur Unterstützung erreichten AVISM und ACVIS 20,84 bzw. 20,60, was zeigt, dass Audio tatsächlich deutliche Hilfe leistet, aber die langfristige Identitätszuordnung immer noch schwierig ist.
Das Forschungsteam stellte auch zwei komplementäre Basismethoden bereit: eine ist das end-to-end AVTrackFormer, das einen HOTA-Testmetrikwert von 21,47 erreicht; die andere ist das trainingsfreie modulare Modell AVTracker, das einen HOTA-Testmetrikwert von 29,08 erreicht. Im Vergleich zu AVISM, der die beste Leistung unter den vorhandenen AVIS-Methoden zeigt, verbessert sich AVTracker um 8,24 (29,08 vs. 20,84); im Vergleich zum stärkeren end-to-end Basismodell AVTrackFormer verbessert sich AVTracker um 7,61 (29,08 vs. 21,47).
Das Forschungsteam hat auch die Null-Shot-Leistung von Gemini 2.5 Pro getestet: Nach direkter Eingabe von Videobildern mit 1 FPS und dem Originalaudio beträgt sein HOTA-Wert 14,4. Dieses Ergebnis zeigt, dass die umfassende audiovisuelle Verständnisfähigkeit von allgemeinen Omni-LLMs noch nicht direkt in eine stabile pixelgenaue Sprecherverfolgungsfähigkeit in komplexen Szenen umgewandelt werden kann.