Neue Meta-Studie: Nach der Destillation des Modells von ByteDance wurde die bisherige Leistungsgrenze durchbrochen.
Token hat Byte ersetzt, aber das bedeutet nicht, dass alle großen Modelle auf Token basieren müssen.
Byte-Modelle, insbesondere nach der Destillation, erhalten nun neue Aufmerksamkeit.
Kürzlich stellten die Arbeit „Über die Token-Obergrenze hinaus: Destillation kleinerer und leistungsstärkerer Byte-Modelle“ von Meta FAIR und der University of Washington eine interessante Idee vor —
Können wir während der Destillation die Lerneinheit von Token auf Byte umstellen, damit das Schülermodell direkt von der Wahrscheinlichkeitsverteilung auf Byte-Ebene lernt?
Es funktioniert tatsächlich.
Das Team fügte jedem Token ein Endzeichen hinzu, um die vollständige Umwandlung der Token-Wahrscheinlichkeitsverteilung des Lehrers in die Byte-Ebene zu realisieren. In Destillationsexperimenten mit Llama 3-8B als Lehrermodell prognostizierte das Team anhand der Skalierungsgesetze:
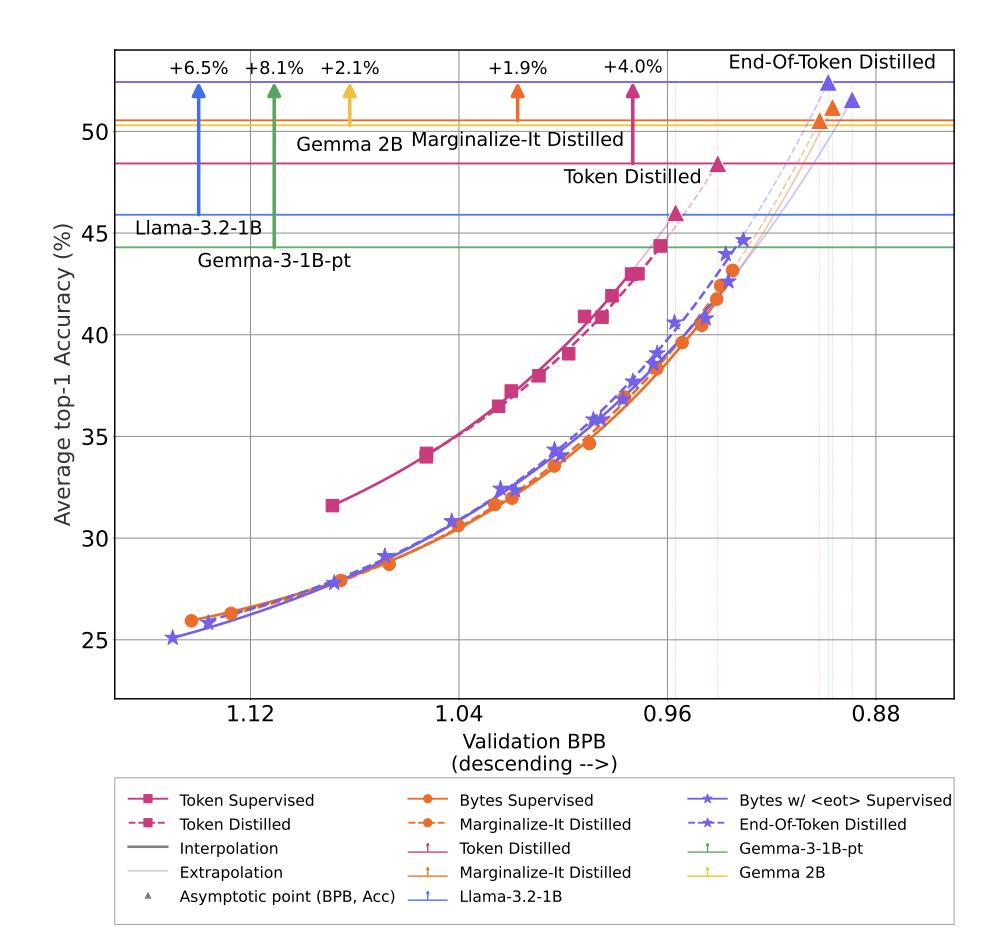
Mit zunehmendem Trainingsaufwand wird die byte-basierte Destillation die token-basierte Destillation übertreffen, wobei die Obergrenze der durchschnittlichen Genauigkeit bei nachgelagerten Aufgaben um 4 Prozentpunkte höher liegt.
Bei der herkömmlichen Destillation lernt das Schülermodell die Wahrscheinlichkeitsverteilung des Lehrers über das riesige Token-Vokabular. Im Vergleich dazu gibt es nur 256 grundlegende Byte-Werte, der Vorhersageraum für jede einzelne Position ist kleiner, und die grundlegenden Werte ändern sich nicht mit dem Tokenizer.
Mit anderen Worten: Die grundlegende Lerneinheit ist sogar kleiner, aber die Obergrenze der Fähigkeiten, die das Modell letztendlich erlernen kann, ist höher.
Wie ist das möglich?
Byte-basierte Destillation
Heutzutage ist Destillation keine unbekannte Technologie mehr. Wir alle wissen, dass größere Modelle leistungsstärker sind, aber bei der Bereitstellung in praktischen Anwendungen stellen Videospeicher, Rechenleistung und Antwortgeschwindigkeit Kosten dar.
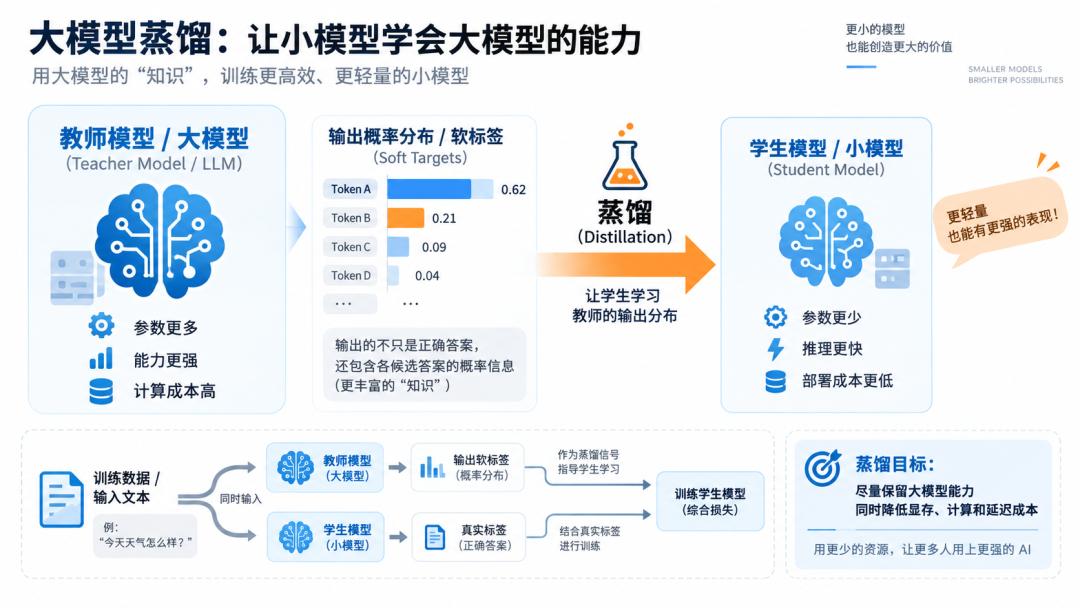
Daher ist ein gängiger Ansatz, das große Modell als Lehrer einzusetzen, der seine Fähigkeiten an ein kleineres Schülermodell weitergibt.
Im Gegensatz zum herkömmlichen überwachten Training, bei dem dem Modell nur mitgeteilt wird, was das nächste richtige Token ist, lernt das Schülermodell bei der Destillation auch die Wahrscheinlichkeitsbewertungen des Lehrers für alle Kandidaten-Token.
Aber hier liegt auch das Problem: Der Kandidatenraum für Token ist extrem groß. Am Beispiel von Llama 3-8B enthält sein Vokabular 128256 Token, was bedeutet, dass jede Vorhersageposition hunderttausende von Kandidatenwahrscheinlichkeiten entspricht.
Wenn bei der Offline-Destillation die vollständige Wahrscheinlichkeitsverteilung vollständig gespeichert wird, sind die Speicherkosten sehr hoch. Daher wird in der Praxis normalerweise nur ein Teil mit der höchsten Wahrscheinlichkeit behalten, nämlich das Top-K-Abschneiden.
Byte-Modelle hingegen verkleinern diesen Kandidatenraum plötzlich stark.
Ein Byte besteht aus 8 Bits und hat insgesamt 256 mögliche Werte. Selbst mit wenigen Sonderzeichen müssen für jede Position nur mehr als zweihundert Wahrscheinlichkeiten gespeichert werden, sodass die vollständige Verteilung leichter zu behalten ist.
Allerdings prognostiziert das Lehrermodell das gesamte Token, während das Schülermodell einzelne Bytes vorhersagt. Damit beide übereinstimmen, darf der Text nicht einfach auseinandergenommen werden, sondern die Wahrscheinlichkeitsverteilung des Lehrers muss ebenfalls umgewandelt werden.
Das ist das erste Problem, das die Arbeit löst.
Konkret schlägt das Team zwei Verfahren vor, die Marginalize-It und End-Of-Token heißen.
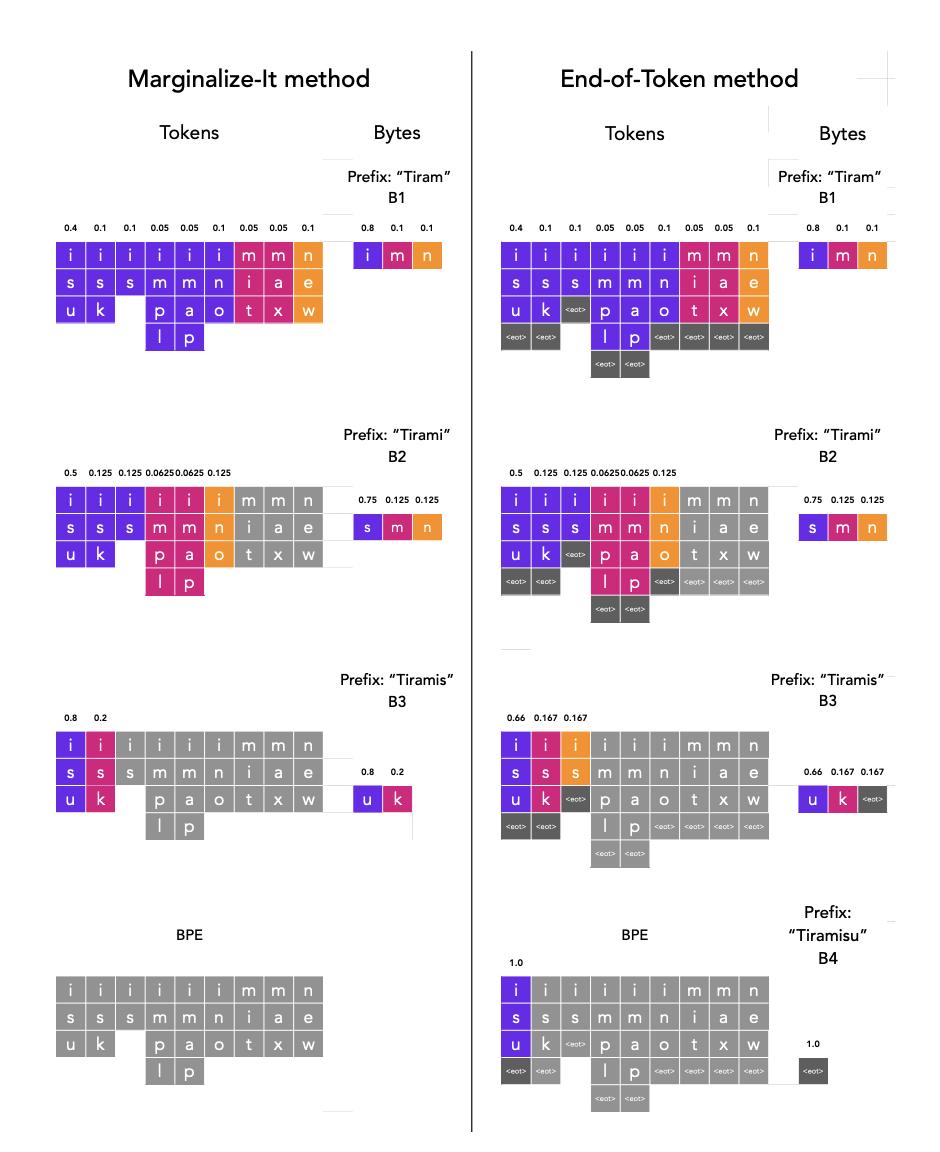
Die grundlegende Idee beider Verfahren ist ähnlich: Die Wahrscheinlichkeiten des Lehrers für verschiedene Token werden schrittweise auf die entsprechenden Byte-Positionen zerlegt.
Nehmen wir als Beispiel „Tiramisu“ aus der Arbeit: Es kann vom Tokenizer in mehrere Token wie T, iram und isu zerlegt werden.
Angenommen, der Lehrer enthält bei der Vorhersage des nächsten Tokens gleichzeitig die Kandidaten isu, isk und is.
Alle drei Kandidaten beginnen mit dem Byte i. Bei der Vorhersage des ersten Bytes können wir also die Wahrscheinlichkeiten aller Kandidaten summieren, die mit i beginnen.
Wenn das echte Präfix zu i wird, behalten wir nur die Kandidaten mit übereinstimmendem Präfix und berechnen die Wahrscheinlichkeit des nächsten Bytes weiter.
Indem wir diesen Vorgang entlang der echten Byte-Sequenz wiederholen, können wir die ursprüngliche Token-Verteilung schrittweise in byteweise Trainingsziele zerlegen.
Erstes Verfahren: Marginalize-It, das Wahrscheinlichkeiten direkt aggregiert und neu zuweist.
Allerdings treten Schwierigkeiten auf, wenn die Längen verschiedener Token unterschiedlich sind.
Beispielsweise wenn wir das Präfix is erreicht haben, gibt es nach isu und isk weitere Bytes, aber das Token is ist bereits abgeschlossen.
Wenn wir nun wissen wollen, was nach is folgt, müssen wir die Vorhersage des Lehrers nach dem Ende dieses Tokens weiter abfragen; verschiedene Kandidatenpfade können wiederum unterschiedlichen Folgeverteilungen entsprechen, sodass der Rechenaufwand schnell ansteigt.
Marginalize-It geht damit direkt um:
Bereits abgeschlossene Kandidaten werden nicht weiter verfolgt, und die Wahrscheinlichkeiten der verbleibenden Kandidaten werden neu normalisiert.
Dadurch ist nur ein einziger Vorwärtsdurchlauf des Lehrermodells erforderlich, was sehr effizient ist. Der Nachteil ist, dass ein Teil der Wahrscheinlichkeitsinformationen von bereits abgeschlossenen Token verloren geht, sodass es sich im Wesentlichen um eine Näherung handelt.
Zweites Verfahren: End-Of-Token, das eine eigene Position für „Token-Ende“ reserviert.
End-Of-Token verfolgt einen anderen Ansatz: Da Token enden, weisen wir dem „Ende“ selbst eine explizite Vorhersageposition zu.
Konkret fügt das Team am Ende jedes Tokens ein Sonderzeichen hinzu. Dadurch werden die ursprünglichen drei Kandidaten zu isu, isk und is mit dem Endzeichen.
Wenn wir das Präfix is erreicht haben, kann das Schülermodell danach nicht nur u oder k vorhersagen, sondern auch das Endzeichen, um anzuzeigen, dass das aktuelle Token hier endet.
Der Teil der Wahrscheinlichkeit, der aufgrund unterschiedlicher Längen zuvor „schwebend“ war, erhält nun eine klare Bestimmungsort.
Daher kann End-Of-Token die Lehrer-Verteilung vollständiger in den Byte-Raum abbilden und gleichzeitig die Token-Grenzen behalten.
Beide Verfahren erfordern nur einen einzigen Vorwärtsdurchlauf des Lehrermodells, um die Umwandlung von der Token-Verteilung zur Byte-Verteilung abzuschließen, ohne das Lehrermodell wiederholt für verschiedene Tokenisierungspfade aufrufen zu müssen.
An diesem Punkt kann das Wissen des Lehrermodells endlich wirklich an das Byte-Schülermodell übergeben werden.
Als Nächstes wird untersucht, wie viel es tatsächlich lernen kann.
Experimentelle Validierung
Das Team testete drei Darstellungen: Token, herkömmliches Byte und Byte mit Endzeichen, jede unterteilt in überwachtes Training und Destillation, insgesamt sechs Gruppen.
Dadurch kann nicht nur verglichen werden, ob die Destillation hilfreich ist, sondern auch beobachtet werden, wie sich die Trainingsleistung des Modells ändert, wenn die Lerneinheit geändert wird.
Als Lehrermodell wird einheitlich Llama 3-8B verwendet. Die Transformer-Schichten der drei Arten von Schülermodellen haben die gleiche Parameteranzahl von etwa 1,28 Milliarden. Nach Berücksichtigung der Vokabular-bezogenen Parameter unterscheidet sich die Gesamtparameteranzahl: Das Token-Schülermodell hat etwa 1,81 Milliarden Parameter, das Byte-Schülermodell etwa 1,28 Milliarden.
Das Team erhöhte schrittweise die Trainingsdatenmenge und den Rechenaufwand. Das Byte-Modell wurde mit Daten im Umfang von Billionen Bytes trainiert und anschließend acht Bewertungen in drei Aufgabentypen durchgeführt: Multiple-Choice-Fragen, Spracherzeugung und maschinelle Übersetzung.
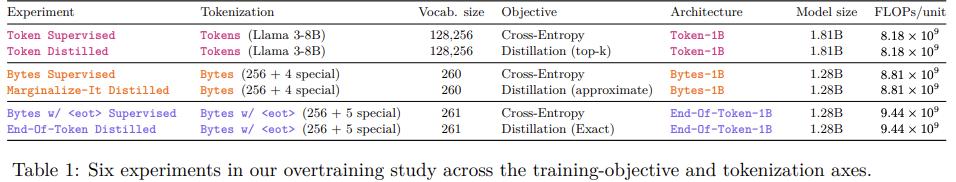
Betrachten wir zuerst den Trainingsverlauf.
Das Token-Modell lernt bei geringem Rechenaufwand schneller, erreicht aber bald eine Plateau-Phase. Das Byte-Modell startet langsamer, verbessert sich aber mit steigendem Rechenaufwand kontinuierlich.
Das heißt, das Token-Modell punktet mit früher Effizienz, während das Byte-Modell ein besseres Skalierungspotenzial zeigt.
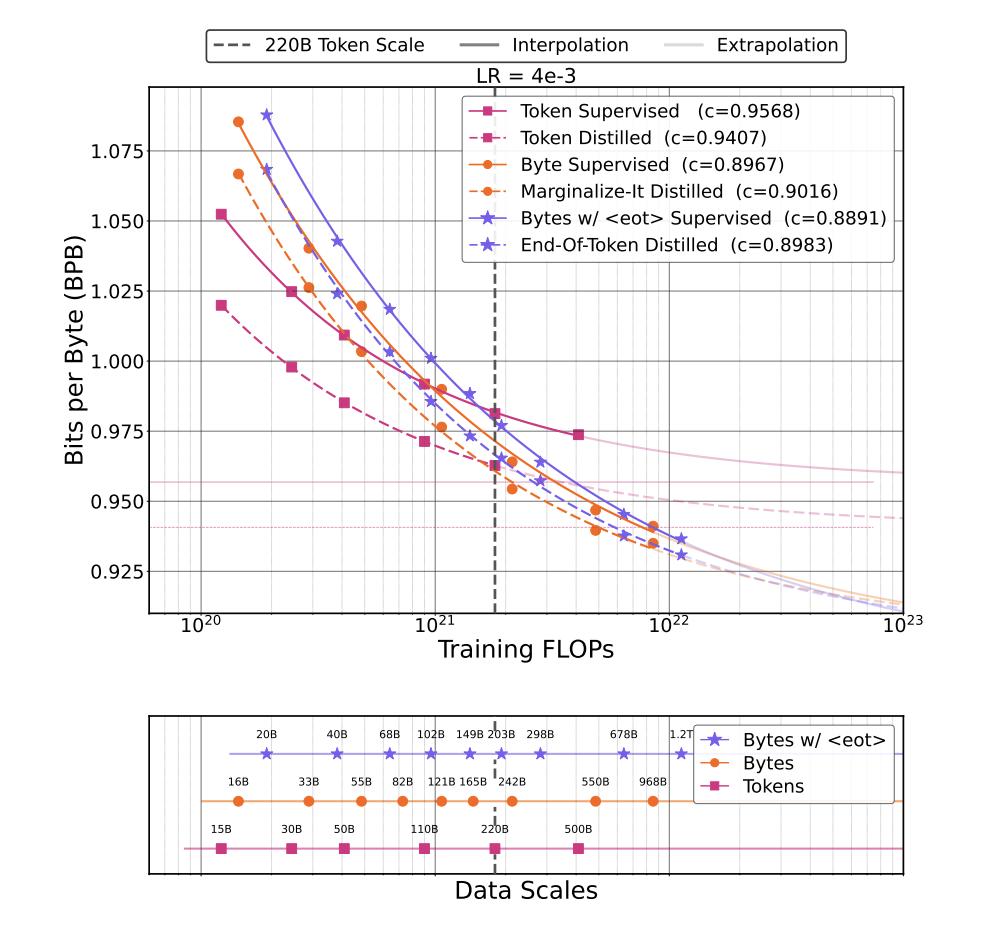
Betrachtet man jedoch nur den BPB-Wert, also den auf jedes Byte normalisierten Vorhersageverlust, übertreffen mehrere Byte-Modelle das Token-Modell schon sehr früh. Aber wenn sie tatsächlich für Aufgaben verwendet werden, sind ihre Ergebnisse noch niedriger.
Der Grund dafür ist, dass BPB misst, wie genau das Modell den Text vorhersagt, während nachgelagerte Aufgaben prüfen, ob die endgültige Antwort korrekt ausgewählt wird — das sind zwei verschiedene Dinge.
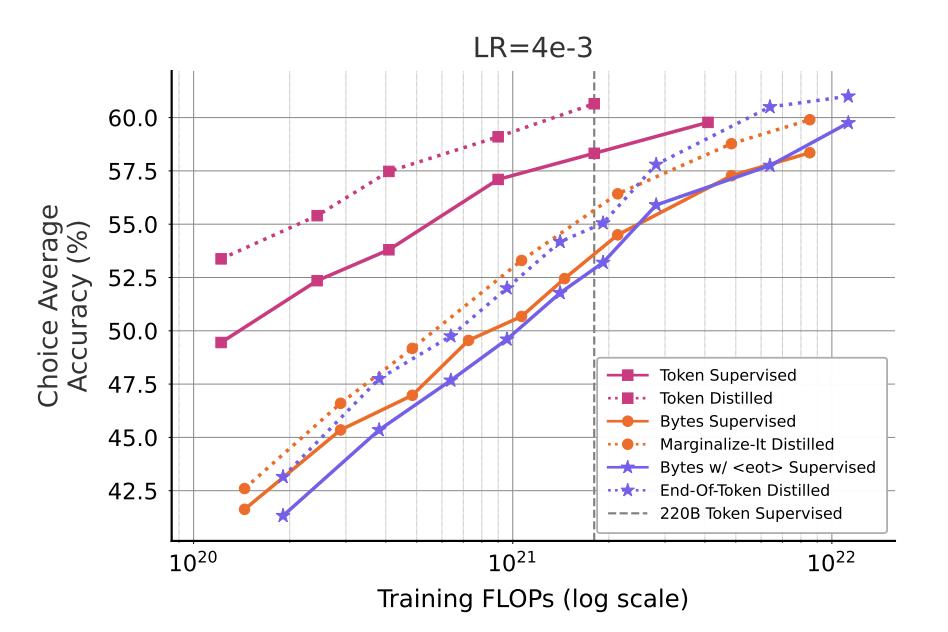
Daher beurteilte das Team die Leistung nicht direkt anhand von BPB, sondern passte eine Beziehung an: Trainingsrechenaufwand → BPB → Leistung bei nachgelagerten Aufgaben, um die Fähigkeitsobergrenze verschiedener Verfahren nach weiterer Skalierung zu prognostizieren.
Die Ergebnisse zeigen, dass die prognostizierten Obergrenzen der durchschnittlichen Genauigkeit der drei Destillationsverfahren lauten:
Token-Destillation 48,4 %, Marginalize-It-Destillation 50,5 %, End-Of-Token-Destillation 52,4 %.
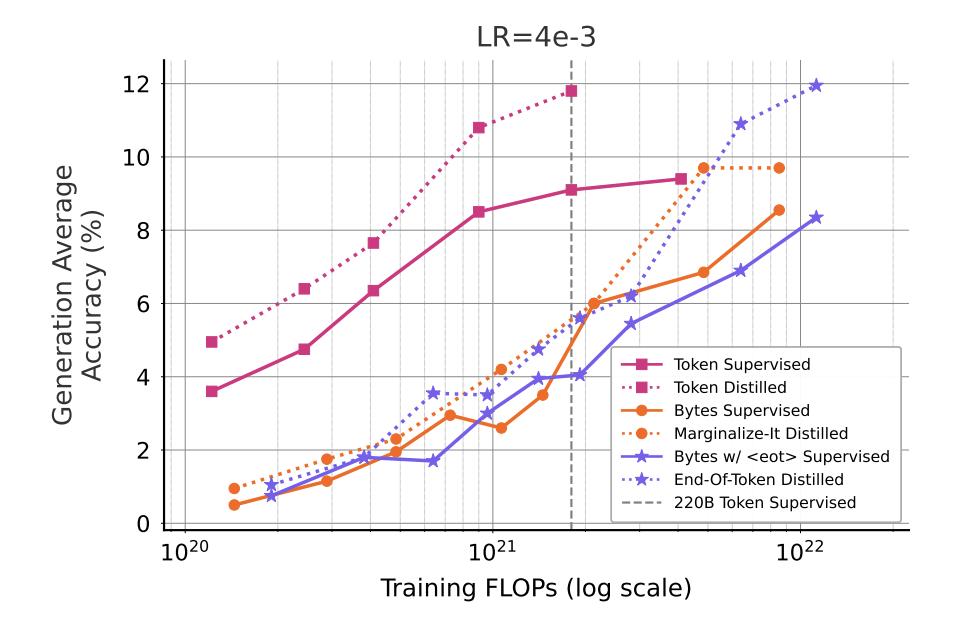
Das heißt, End-Of-Token liegt letztendlich um 4 Prozentpunkte über der herkömmlichen Token-Destillation und hat die höchste prognostizierte Obergrenze unter allen sechs Verfahren.
Allerdings ist der Vorteil der Destillation nicht in allen Fällen gültig.
Die prognostizierte asymptotische Genauigkeit des herkömmlichen überwachten Byte-Modells beträgt 51,2 %, was höher ist als die 50,5 % der Marginalize-It-Destillation.
Die Arbeit geht davon aus, dass der Grund dafür der bereits erwähnte ist: Marginalize-It opfert einen Teil der Wahrscheinlichkeitsinformationen nach dem Token-Ende, um Rechenaufwand zu sparen.
End-Of-Token hingegen, das die Lehrer-Verteilung vollständiger behält, übertrifft sowohl seine eigene überwachte Version als auch alle anderen Verfahren.
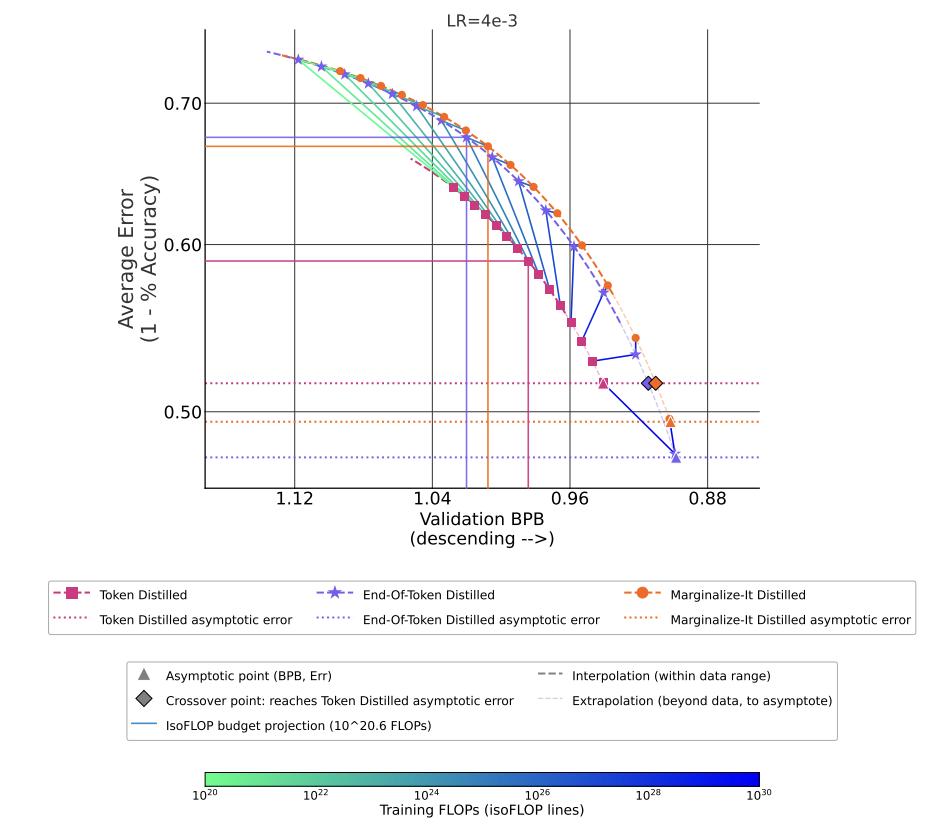
Bei weiterer Extrapolation entlang der Skalierungskurve erreicht End-Of-Token die prognostizierte Obergrenze von 48,4 % der Token-Destillation bei etwa 6,33×10²² FLOPs.
Abschließend zeigen die Experimente, dass die byte-basierte Destillation den Speicherdruck für Daten und Lehrer-Verteilung erheblich reduziert.
Das Team verglich diese asymptotischen Prognosen auch mit vorhandenen Open-Weight-Modellen.
Gemäß dem prognostizierten Trainingsaufwand der Arbeit beträgt die tatsächliche Textmenge, die von End-Of-Token verarbeitet wird, etwa ein Sechstel derjenigen des Token-Verfahrens. Bei der Einstellung, bei der Token nur die Top-600-Werte speichern und Byte die