Ein Pelikan wurde der größte Star im Zeitalter der Agenten
„Jeden Tag werden zehntausende Videos von Pelikanen, die Fahrrad fahren, in Gruppen in der Community geteilt, und man fragt mich, ob dieser Pelikan an Intelligenz eingebüßt hat.“ Lambda, der Initiator des Open-Source-Projekts CodexRadar, erhielt nach der Veröffentlichung von GPT-6 Astra jeden Tag eine riesige Menge an Pelikan-Videos, also startete er kurzerhand einen „Pelikan-Pokal“-Wettbewerb in der Community.
Die Teilnehmer erledigen die Aufgabe „Male einen Pelikan, der Fahrrad fahren kann“, generieren Werke mit Modellen und teilen die Ergebnisse anschließend in der Community.
„Wir haben es spät in der Nacht veröffentlicht, ohne Werbung gemacht zu haben, und schon fast hundert Einreichungen erhalten.“ Lambda hatte nicht erwartet, dass die Begeisterung der Nutzer für den „Pelikan-Test“ so hoch ist.
Jedes Mal, wenn ein neues Modell veröffentlicht wird, testen manche Menschen die Fähigkeiten des Modells mit dem Szenario, dass ein Pelikan Fahrrad fährt.
Einerseits ist diese Aufgabe einfach und intuitiv genug. Viele komplexe Fähigkeiten des Modells lassen sich kaum mit einem einzigen Satz schnell beurteilen, aber bei dem Szenario des fahrradfahrenden Pelikans erkennt man die Stabilität auf einen Blick: zum Beispiel, ob die Beine richtig zu den Pedalen passen, ob die Räder sich synchron bewegen, ob die Aktionen keine Fehler aufweisen und ob die generierten Inhalte vor und nachher konsistent sind.
Andererseits ist diese Aufgabe auch komplex genug. Sie scheint nur eine kurze Prompt zu sein, hinter ihr stecken aber Fähigkeiten wie Aktionsverständnis, zeitliche Konsistenz, räumliche Beziehungen, Code-Organisation und kontinuierliche Ausführung. Für ein Modell, das bereits das Agent-Stadium erreicht hat, eignet sich diese Art von Aufgabe sehr gut als „intuitives Thermometer“.
Nach der Veröffentlichung von GPT-6 Astra ist dieser Pelikan noch beliebter geworden. Der Grund ist, dass dieses modernste Modell eine sehr instabile „Intelligenz“ aufweist, und die Intelligenz wirkt sich direkt auf das Arbeitsergebnis aus.
Der Pelikan kann genau diese schwer zu quantifizierende Intuition sehr anschaulich machen.
01 Wie misst ein Pelikan den „Intelligenzrückgang“ des Modells?
Der Pelikan-Pokal-Wettbewerb ist in zwei Bahnen unterteilt. Auf der Classic-Bahn wird ein einheitlicher Prompt verwendet: „Erstelle ein HTML-Dokument, das eine 2D-Animation eines mit SVG gezeichneten fahrradfahrenden Pelikans enthält“. Solange der Zustand des Modells normal ist, behält der von GPT-6 Astra generierte Pelikan in der Regel eine relativ konsistente Qualität und Bildstruktur bei.
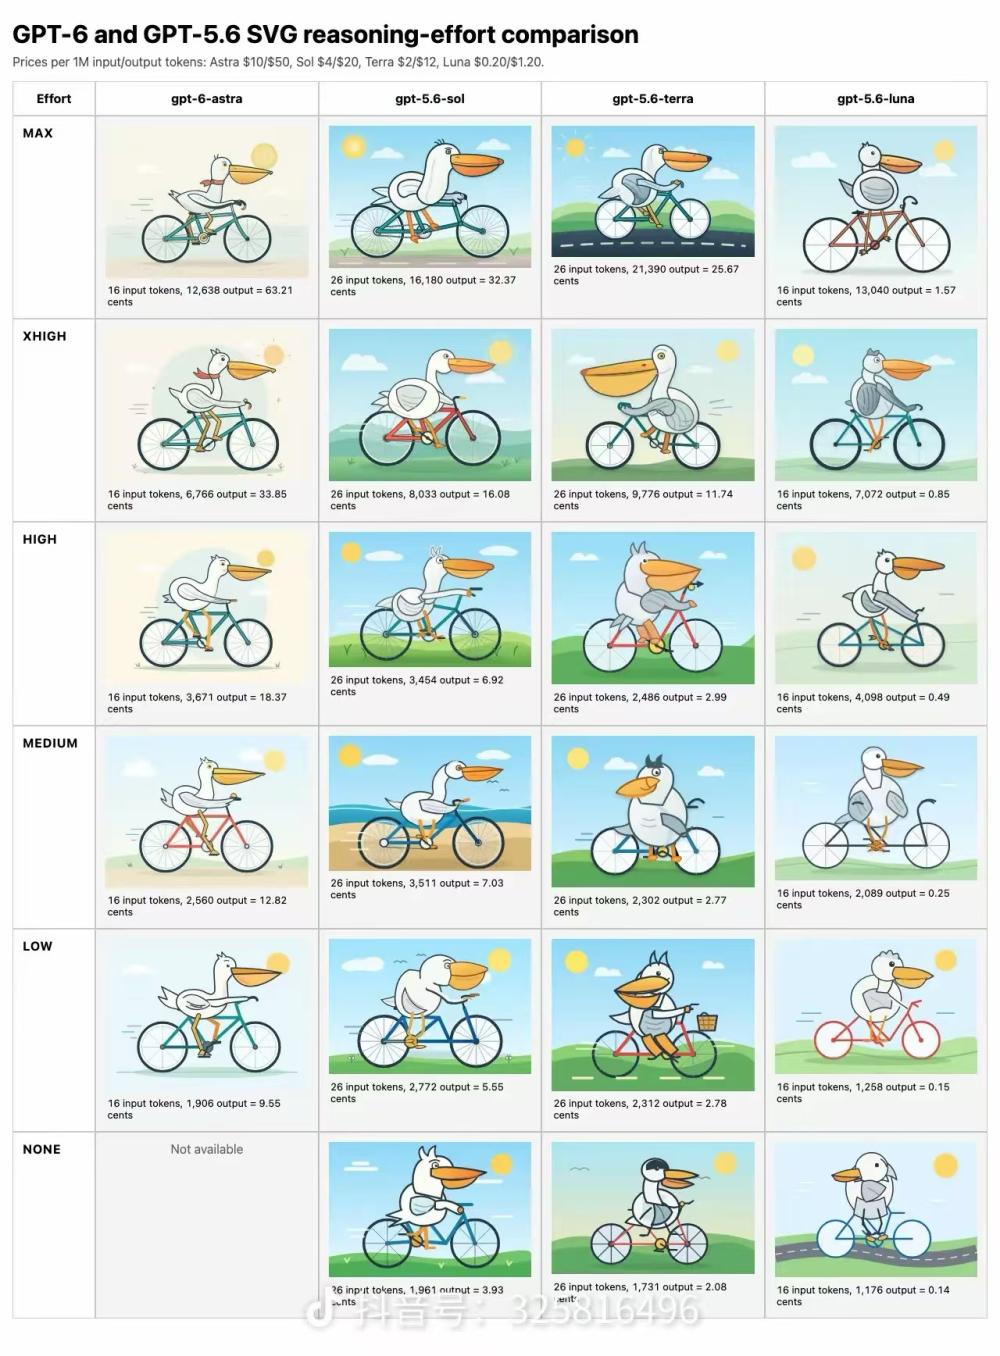
Abbildung: Die von Nutzern in soziale Netzwerke hochgeladenen Pelikan-Bilder zeigen, dass wenn die Intelligenz von GPT-6 Astra bei verschiedenen Inferenzintensitäten stabil bleibt, die generierten Pelikan-Bilder weitgehend konsistent bleiben.
Wenn eines Tages plötzlich viele Nutzer feststellen, dass unter demselben Prompt der Pelikan häufig ins Leere tritt, die Beziehung zwischen den Rädern durcheinandergerät und die Struktur deutlich abweicht, tauchen schnell Diskussionen über den „Intelligenzrückgang“ auf.
Diese Methode ist natürlich kein streng wissenschaftlicher Benchmark. Eine öffentliche und häufig wiederholte Aufgabe kann auch allmählich vom Modell vertraut gemacht werden. Aber sie eignet sich sehr gut, um die kurzfristigen intuitiven Veränderungen zu beobachten. Nutzer müssen keine komplexen Indikatoren verstehen, sie brauchen nur einige Pelikan-Bilder anzusehen, um Unterschiede zu erkennen.
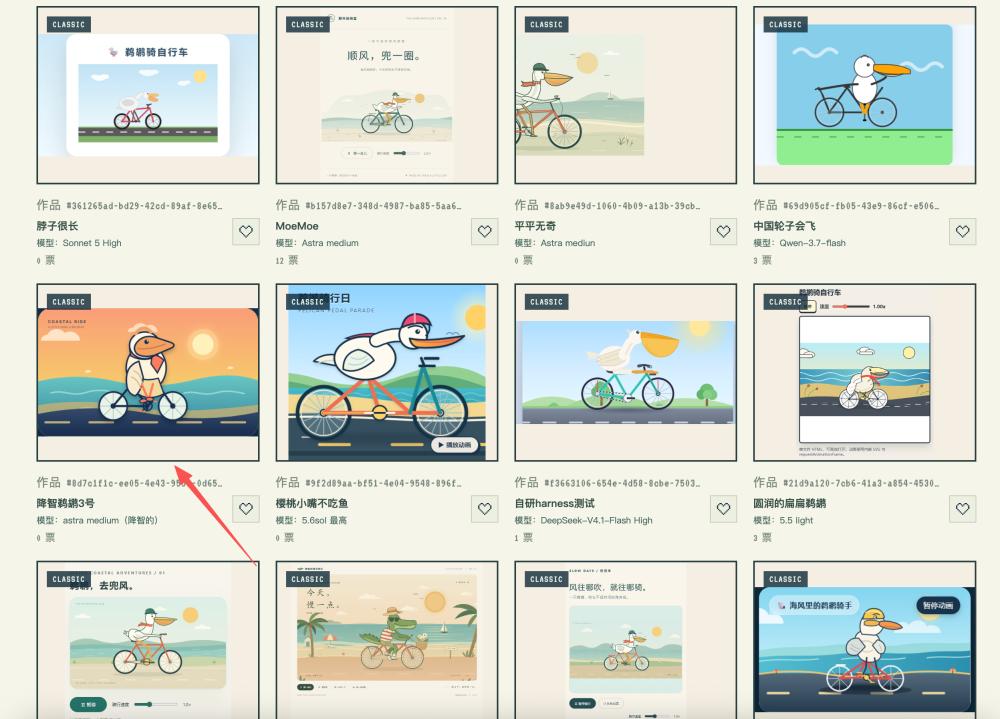
Abbildung: Screenshot eines Werks aus dem „Pelikan-Pokal“, das als „intelligenzgemindert“ markiert ist, man erkennt, dass der Pelikan „offensichtlich nicht korrekt“ ist.
Auf der Open-Bahn gibt es keinen einheitlichen Prompt, die Teilnehmer können sich frei entfalten. Sie testet eher, inwieweit Astra eine offene Aufgabe bewältigen kann.
Eines der Werke wurde schließlich zu einer 30-minütigen Fahrradgeschichte in einer einzigen durchgehenden Einstellung umgesetzt.
Das gesamte Werk teilt sich eine Zeitachse von 1800 Sekunden und denselben Fahrer. Boden, Berge, Städte, Planeten, Räder, Federn und Partikel bestehen vollständig aus SVG-Elementen, JavaScript ist nur für die Berechnung von Positionen, Gelenken und Zeiten zuständig. Im gesamten Projekt wurden keine Canvas, Bilder, Videos, externen Schriftarten oder zusätzlichen Schnittstellen für große Modelle verwendet.
Die Kamera kann sich kontinuierlich verschieben, entfernen und nähern, alle Szenen befinden sich in derselben vektoriellen Welt. Zur Leistungssteuerung wird das Zeichnen von Bereichen außerhalb des Bildschirms angehalten; nachdem der Nutzer den Fortschrittsbalken gezogen hat, kehren alle Objekte direkt zum entsprechenden Zeitpunkt zurück, ohne neu zufällig generiert zu werden.
Sogar die leicht fehleranfällige Aktion des Fahrradfahrens wurde separat verarbeitet: Die Drehung der Räder und die Phase der Pedale werden von der zurückgelegten Fahrstrecke angetrieben, sodass wenn die Figur anhält, nicht der Fall eintritt, dass das Fahrrad bereits steht, die Füße aber noch leer in der Luft treten.
In den ersten 20 Minuten des Werks werden 30 Städte und Naturattraktionen durchquert, im Kapitel über Shenzhen erscheinen nacheinander das Tencent-Pinguin-Insel, das Gebäude von Sangfor und der Talentpark; die letzten 10 Minuten führen ins Universum, vom Mars über die Sonne, den Pluto und ein schwarzes Loch zurück zur Erde.
Der Autor hat im Werk auch extra angegeben, welche Inhalte der Realität entsprechen und welche fiktiv sind. Zum Beispiel das Fahrradfahren im Weltraum, die kleinen Lampen, die Sonnenlicht speichern, der Schneemann auf dem Pluto und die Heimreise durch das schwarze Loch sind nur Teil der Handlung; der Ereignishorizont des schwarzen Lochs wird auch nicht als tatsächlich durchquerbarer Tunnel dargestellt.
Aus diesem Werk geht hervor, dass die Fähigkeiten von GPT-6 Astra wirklich beeindruckend sind.
Das Modell muss zuerst ein offenes Ziel verstehen, dann die Seitenarchitektur, die Animationslogik, das Zeitsystem, die Bewegung der Figuren, die Kameraführung, das Szenendesign, die Leistungsoptimierung und die Beschreibungsdokumentation fertigstellen, außerdem muss es sicherstellen, dass all diese Teile in einem 30-minütigen Werk durchgehend konsistent bleiben.
02 Warum macht Astra die Nutzer besonders sensibel?
Der Initiator des Open-Source-Projekts CodexRadar wollte ursprünglich nur sein eigenes Problem lösen: Hat das Modell heute tatsächlich an Intelligenz eingebüßt, und kann man das Zurücksetzen des Kontingents überwachen, um das Token-Kontingent so effizient wie möglich vollständig auszunutzen. Später machte er das Überwachungstool zu einem gemeinschaftlichen Open-Source-Projekt, und er hatte nicht erwartet, dass es schnell eine Gruppe von intensiven Codex-Nutzern anzieht, die gemeinsam an der Massentestung teilnehmen.
Das „Massentest-Radar“ von CodexRadar ist mit 112 echten Open-Source-Programmieraufgaben ausgestattet, die Nutzer selbst ausführen können. Nach dem Hochladen der Ergebnisse werden diese vom Server in einer sauberen Umgebung erneut überprüft. Auf der offiziellen Website wird angezeigt, dass die teilnehmenden Freiwilligen bereits über 500 Personen sind und der kumulative Beitrag das Niveau von hunderten Milliarden Token erreicht hat.
Dass ein kleines Tool, das ursprünglich zur eigenen Überwachung der „Modellintelligenz“ entwickelt wurde, so viele Menschen dazu anzieht, kontinuierlich Kontingente beizusteuern, liegt vollständig daran, dass die Fluktuation der Modellfähigkeiten zu einem gemeinsamen Problem aller intensiven Nutzer geworden ist.
Nach der Veröffentlichung von Astra wirken sich diese Fluktuationen noch stärker auf die Arbeit aus.
Ein Algorithmen-Ingenieur für große Modelle erklärte, dass der Intelligenzrückgang direkte Auswirkungen auf automatisierte Aufgaben hat. „Wenn GPT-6 an Intelligenz einbüßt und gleichzeitig in der Geschwindigkeit gedrosselt wird, sammeln sich automatisierte Aufgaben an, was schließlich zu parallelen Konflikten führt. Wenn die Intelligenz bei Ticket-Sitzungen sinkt, können sich Fehler auch über das Zentralmodell auf andere Bereiche ausbreiten und schließlich das gesamte Repository beschädigen.“
Nach dem Eintritt in das Agent-Stadium ist ein einzelner Modellaufruf oft nur ein Glied in der gesamten Aufgabenkette. Wenn bei einem Schritt eine deutliche Abweichung in der Beurteilung auftritt, können die nachfolgenden Schritte weiterhin entlang des falschen Ergebnisses voranschreiten. Je länger die Aufgabe ist, desto deutlicher wird dieses Risiko.
Aus diesem Grund konzentrieren sich die Nutzer nicht mehr nur auf die durchschnittliche Leistungsfähigkeit, wenn das Modell tatsächlich in den Produktionsprozess eintritt. Ob die Fähigkeiten fluktuieren, ist genauso wichtig.
„Astra ist in allen Bereichen stark, insbesondere bei Computer Use und der kooperativen Verwaltung mehrerer Agenten. Aus den Daten des Radars geht hervor, dass Astra für die Lösung von Aufgaben nur halb so viele Schritte benötigt wie die Vorgängermodelle – je weniger Schritte, desto stärker das Modell, Astra hat eine qualitative Verbesserung erfahren.“
Bei der Veröffentlichung von Astra legte OpenAI großen Wert auf Computer Use, professionelle Arbeit, Softwareentwicklung und langfristige Agentenaufgaben. Viele Entwickler im Bereich großer Modelle erklärten, dass „Astra eine Stärke mit Generationenunterschieden hat“.
Gerade wegen dieser Stärke hoffen die Nutzer, einige komplexere und längerfristigere automatisierte Aufgaben an Astra übergeben zu können, sodass der „Intelligenzrückgang“ die praktischen Arbeitsergebnisse noch stärker beeinträchtigt.
03 Was bedeutet der sogenannte „Intelligenzrückgang“ eigentlich?
„Intelligenzrückgang“ ist eigentlich ein sehr in der Community gebräuchlicher Ausdruck. Aus der Sicht der Nutzer wird alles als „Intelligenzrückgang“ bezeichnet, wenn dasselbe Modell mit demselben Produktzugang heute deutlich schwieriger zu bedienen ist als gestern.
Aus ingenieurstechnischer Sicht wird das Endergebnis, das die Nutzer sehen, jedoch von vielen Ebenen gemeinsam bestimmt.
Die unterste Modellebene ist eine Ebene, die Inferenzintensität eine weitere, das Kontextmanagement eine dritte, und auch Harness, Skills, Toolaufrufe, Modellrouting, parallele Planung und Dienstleistungskapazität wirken sich auf das Endergebnis aus.
Das bedeutet also, dass das von den Nutzern wahrgenommene „Weniger-intelligent-Sein“ nicht unbedingt bedeutet, dass sich die Modellgewichte selbst verändert haben.
Zum Beispiel führt ein Coding-Agent früher automatisch drei Testläufe durch, heute nur noch einen; früher ruft er mehrere Unteragenten auf, um die Ergebnisse zu überprüfen, heute reduziert er die parallele Erkundung; früher behält er einen vollständigeren Kontext bei, heute gehen in langen Aufgaben einige frühe Informationen verloren. Für den Hintergrund können dies völlig unterschiedliche Probleme sein, für die Nutzer ist die endgültige Intuition aber gleich: Warum ist es nicht mehr so intelligent wie früher?
Das ist auch der Grund für die Entstehung von CodexRadar.
Die Benchmark-Punktzahl des Modells bei der Veröffentlichung zeigt, wie hoch die Spitzenfähigkeit des Modells ist, aber es ist schwer, den Echtzeitzustand des Modells zu erkennen, zum Beispiel in welchem Zustand sich das Astra befindet, das um 10 Uhr heute Morgen aufgerufen wurde.
Aber für Menschen, die mit Agenten tatsächlich arbeiten, ist dieser Echtzeitzustand sehr wichtig.
04 Die Probleme hinter dem „Intelligenzrückgang“
Bislang gibt es keine öffentlichen Beweise dafür, dass OpenAI Astra in großem Umfang aktiv durch ein schwächeres Grundmodell ersetzt.
Aber es gibt deutliche Anzeichen für den Versorgungsdruck nach der Veröffentlichung von Astra. Am 10. September hat OpenAI neue Abonnements und Upgrades für das 200-Dollar-Pro-20x-Monatspaket ausgesetzt. Bestehende Nutzer sind vorerst nicht betroffen. Dieses Paket bietet ein Nutzungskontingent von etwa dem 20-fachen des Plus-Pakets und ist auch eine wichtige Wahl für intensive Codex-Nutzer.
Astra selbst ist zudem ein sehr teures Modell.
Sein standardmäßiger API-Preis beträgt 10 US-Dollar pro Million Eingabe-Token und 50 US-Dollar pro Million Ausgabe-Token; der Fast-Modus bietet eine höhere Geschwindigkeit, der Preis verdoppelt sich noch einmal.
Das Problem liegt darin, dass die beliebtesten Fähigkeiten von Astra besonders viel Rechenleistung verbrauchen.
Computer Use erfordert das kontinuierliche Verstehen des Bildschirms, das Ausführen von Aktionen, das Beobachten der Ergebnisse und das anschließende Entscheiden über den nächsten Schritt; der Workflow mehrerer Agenten kann gleichzeitig mehrere Unteraufgaben starten; bei einer vollständigen Aufgabe eines Coding-Agents werden ständig Dateien gelesen, Code ausgeführt, Tests durchgeführt und Ergebnisse überprüft.
Wenn eine große Anzahl intensiver Nutzer das Modell gleichzeitig auf diese Weise verwendet, ist der Versorgungsdruck nicht mehr mit dem vergangenen Niveau vergleichbar.
Daher vermischen sich hinter dieser aktuellen Diskussion über den „Intelligenzrückgang“ tatsächlich Fluktuationen der Modellqualität, Geschwindigkeitsdrosselung, Ressourcenplanung und die Verstärkung der Systeminstabilität durch lange Aufgaben selbst.
Einige Mitglieder der Community sind der Meinung, dass die aktuellen Probleme mit der übermäßig hohen Nachfrage nach Astra, dem starken Zustrom von Pro-20x-Nutzern und der angespannten Versorgung mit Rechenleistung zusammenhängen. Dass OpenAI die neuen Abonnements für das 20x-Paket ausgesetzt