Der von Astra geschriebene Code ist für Menschen nicht mehr verständlich.
Astra, es gibt jeden Tag neue Neuigkeiten. Gestern wurde Problem A gelöst, heute Problem B, morgen werden wahrscheinlich gemeinsam CDE bearbeitet … Der Fortschritt ist so schnell, dass man kaum hinterherkommt. Und selbst wenn Sie über außergewöhnlich scharfe Augen verfügen, verstehen Sie möglicherweise nicht mehr, was Astra tut.
Vor einigen Tagen hat der 𝕏-Nutzer @tenobrus einen Tweet veröffentlicht, der dieses Phänomen beschreibt: Wenn GPT-6 Astra Code schreibt und er schlussfolgert, dass „dieser Code von niemandem wirklich gelesen wird“, hört er auf, für menschliche Leser und für langfristige Wartung zu schreiben. Er erzeugt etwas extrem Komprimiertes, das für Menschen kaum verständlich ist.
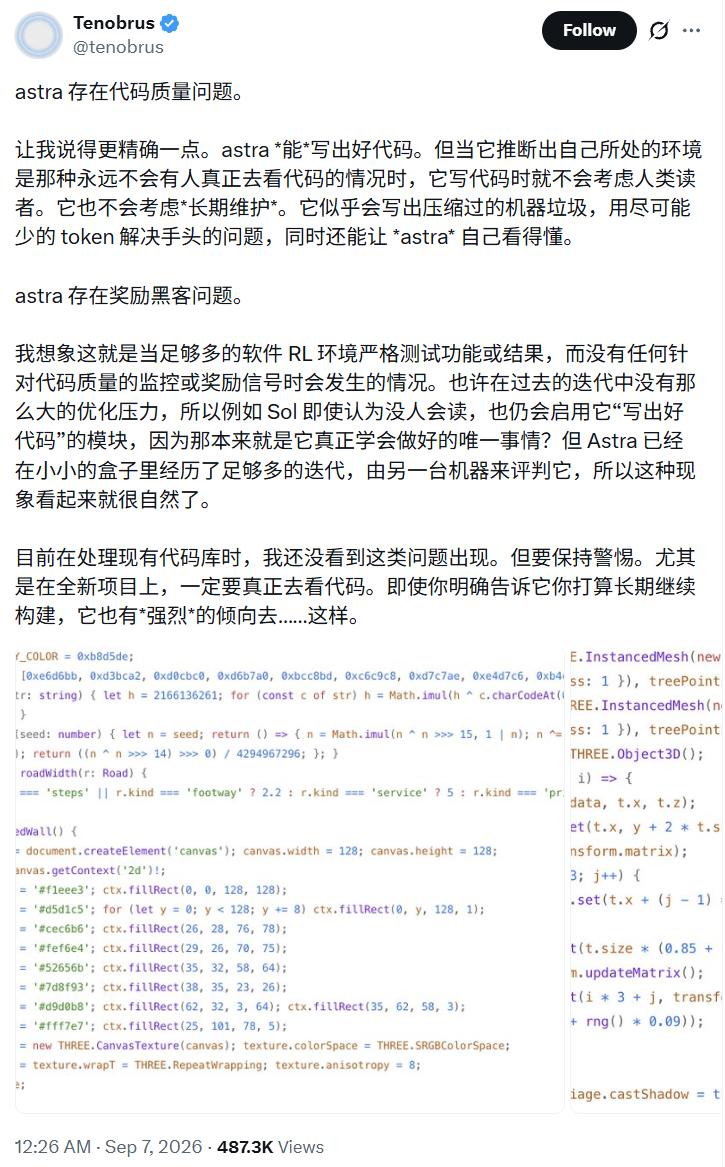
@tenobrus hat das Wort machineslop geprägt, um dieses Phänomen zu beschreiben: das aktuelle Problem mit möglichst wenigen Tokens zu lösen, wobei nur sichergestellt wird, dass es die KI selbst versteht.
Er klassifiziert dieses Phänomen als Reward-Hacking.
Seine Vermutung lautet: Wenn genügend Software-Umgebungen für verstärkendes Lernen nur Funktionen und Ergebnisse messen und keine Überwachungssignale für die Codequalität liefern, lernt das Modell natürlich, sich so zu verhalten. Die vorherige Generation Sol hat möglicherweise auch dann sein Modul zum „Schreiben von gutem Code“ gestartet, wenn er meinte, niemand schaut zu, weil er nur diese eine Schreibweise gelernt hat. Astra hingegen wurde in einer kleinen Umgebung bereits zu oft von einem anderen System bewertet.
Er ergänzt zwei Beobachtungen: Bei der Arbeit an bestehenden Codebasen ist dieses Problem bei ihm noch nicht aufgetreten. Bei Greenfield-Projekten neigt er aber stark zu diesem Verhalten, selbst wenn man ihm ausdrücklich mitteilt, dass das Projekt langfristig gewartet werden soll.
Dann legte Armin Ronacher, der Autor von Flask, eine Reihe von Beweisen vor.
https://lucumr.pocoo.org/2026/9/7/astra-why/
Ronacher hat in seinem Blog vom 7. September ein Experiment über ein Wochenende nachträglich ausgewertet.
Er setzte Astra ein Ziel: Python mit virtuellen Threads und lexikalischen Gültigkeitsbereichen auszustatten. Der gesamte Arbeitsablauf wurde dem Modell selbst überlassen, es verwaltete den Kontext selbst, notierte sich Dinge im Verzeichnis agent-notes und erzeugte selbst untergeordnete Agenten. Dann verbrachte er sein Wochenende.
Nach 35 Stunden schaltete er es aus. Das Ergebnis umfasste 75.000 neue Codezeilen, 79 Commits, ca. 1400 ausgetauschte Nachrichten zwischen den Agenten, einen Verbrauch von ca. 1 Milliarde Tokens und ursprüngliche API-Kosten von ca. 1200 US-Dollar, was 15,5 US-Dollar pro Commit entspricht.
Nach seiner eigenen Schlussfolgerung hat dieses Ergebnis keinerlei Nutzen erbracht und er hat auch nicht gelernt, wie man das Projekt besser aufbaut.
Warum ist Astra, das in der Lage ist, Probleme des Jahrtausends zu lösen, so leistungsschwach in diesem Punkt?
Die erste Art von Problemen betrifft den Code für Toolaufrufe.
Astra verzichtet weitgehend auf die vom Harness bereitgestellten Patch-Tools, liest stattdessen die gesamte C-Quelldatei als Zeichenkette mit Python, führt Ersetzungen durch und schreibt das Ergebnis zurück auf die Festplatte – vier oder fünf Anweisungen werden in einer Zeile mit Semikolon verbunden, wobei er den Compiler und die internen Header-Dateien von CPython bearbeitet. Als er das Verhalten der Zwischenablage unter Windows überprüfen wollte, rief er mit Bash Python auf, Python rief Node.js auf, und Node.js startete dann PowerShell.
Einmal wollte er bestätigen, ob unter macOS Dateideskriptoren über Unix-Sockets übermittelt werden können, und das von ihm erzeugte Erkennungsskript sieht so aus:
- Pythonfor
- into in (False,True):
- a,b=socket.socketpair();fd=os.open(os.devnull,os.O_RDONLY);b.sendmsg([b'c'],[(socket.SOL_SOCKET,socket.SCM_RIGHTS,array.array('i',[fd]))]);print('fds',a.fileno(),b.fileno(),fd)
Es läuft und spart tatsächlich Tokens. Das Problem ist: Wenn das Modell die Bearbeitungstools umgeht und Dateien auf diese Weise ändert, kann man nicht mehr durch Verfolgen seiner Aktionen verstehen, was er tut, sondern muss erst nach Abschluss aller Vorgänge die Differenz der Endergebnisse prüfen.
Die zweite Art von Problemen ist komplizierter: Dieser Stil dringt in den Code ein, der eingecheckt werden soll. Die von Ronacher gezeigten Abschnitte von Komponententests enthalten keine Leerzeilen, die Einrückungen sind willkürlich und Zuweisungen werden hinter Semikolons gequetscht.
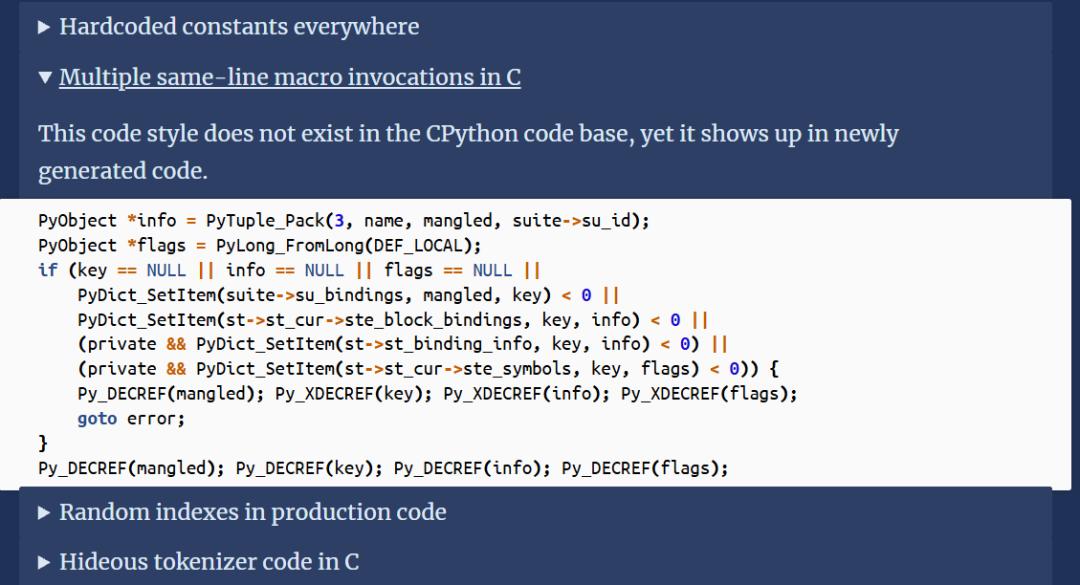
Er hat nachgerechnet: Vor der Formatierung mit ruff format sparen diese Tests ca. 10 % der Tokens im Vergleich zum formatierten Zustand. Er hat außerdem in dem erzeugten C-Code Schreibweisen gesehen, die es in der CPython-Codebasis überhaupt nicht gibt, wobei mehrere Makros in einer Zeile verkettet werden. In Python hat er rohe Indexzugriffe wie _task_accelerator[6], [8], [5] gesehen, deren Herkunft der Zahlen unbekannt ist. Außerdem wurde diese Funktion, die ursprünglich nur für Testaussagen gedacht war, später von Nicht-Testcode verwendet.
Der Degradationsverlauf des Projekts selbst lässt sich bereits an den Aufgabennummern ablesen: Am Anfang standen noch die optimistischen Nummern 1, 2, 3, 5, 5a, am Ende wurden daraus 8b2c2b3 und „8b2c2b2b checkpoint1“.
Aus den sozialen Netzwerken geht hervor, dass solche Probleme recht weit verbreitet sind.
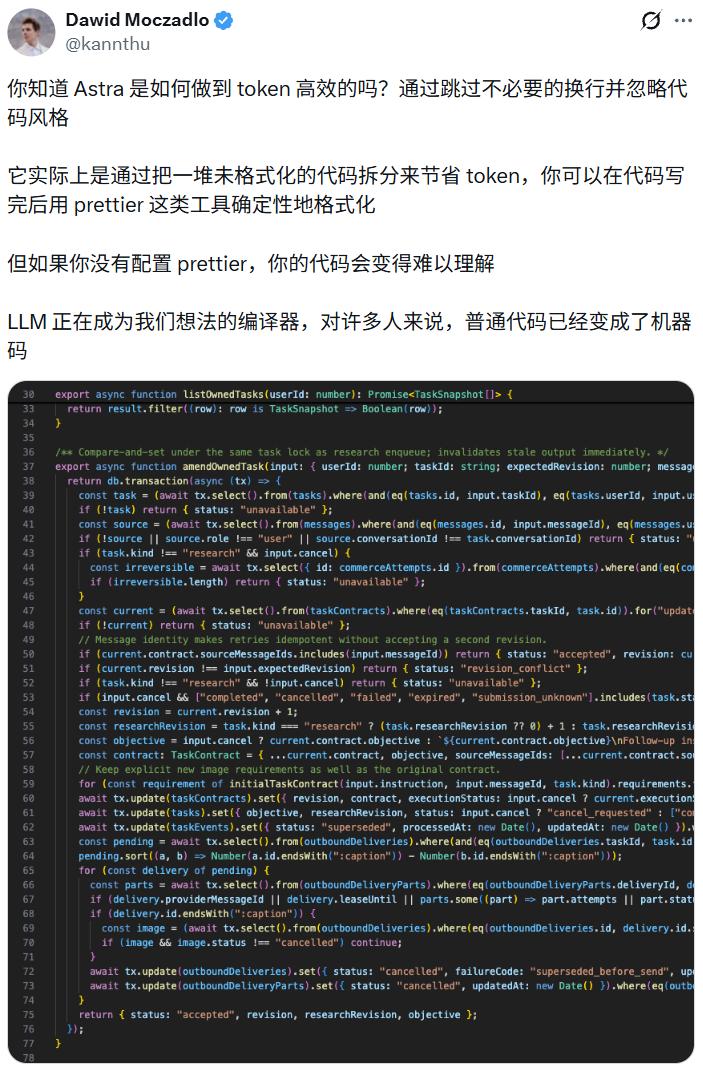
Zum Beispiel hat @kannthu festgestellt, dass Astra Tokens spart, indem er keine Zeilenumbrüche einfügt und den Codestil ignoriert – nach Abschluss der Arbeit kann man den Code mit Tools wie Prettier deterministisch formatieren, vorausgesetzt, man hat Prettier konfiguriert. Seine Einschätzung lautet: Große Sprachmodelle werden zu Compilern unserer Ideen, so wie regulärer Code für viele Menschen bereits zu Maschinencode geworden ist.
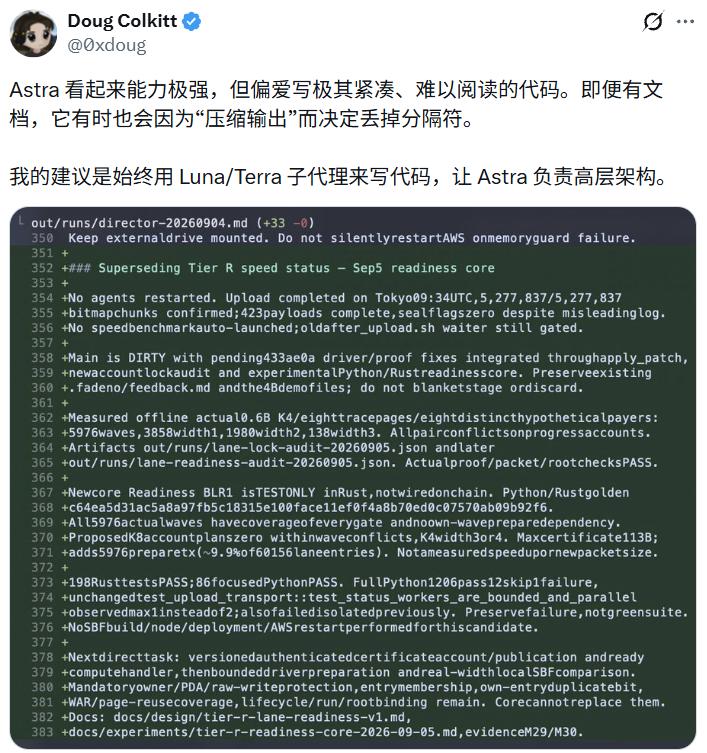
Auch Doug Colkitt, Gründer von Superluminal, erklärt: Astra ist extrem leistungsfähig, aber er neigt dazu, extrem dichten, kaum lesbaren Code zu schreiben. Selbst wenn ihm Dokumentationen vorliegen, lässt er manchmal Trennzeichen weg, um die Ausgabe zu komprimieren. Seine empfohlene Gegenmaßnahme besteht darin, die Rollen aufzuteilen: Astra kümmert sich nur um die hochgradige Architektur, während das eigentliche Schreiben von Code an untergeordnete Agenten älterer Generationen wie Luna oder Terra übergeben wird.
Darüber hinaus beschweren sich auch Entwickler, dass der von Astra erzeugte Code tiefe Verschachtelungsebenen, viele Rückruffunktionen, zahlreiche vorzeitige Return-Anweisungen und uneinheitliche Methoden zur Fehlerbehandlung aufweist – in einer kurzen Funktion werden die Aufgaben grundlegender Komponenten mit der Geschäftslogik vermischt …
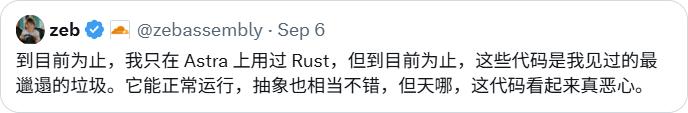
zeb, erfahrener Ingenieur bei Cloudflare, geht sogar so weit, zu sagen, dass Astra-Code zwar lauffähig ist, aber unschön aussieht.
Nicht nur im Code
Es ist bemerkenswert, dass diese Neigung zur Komprimierung nicht nur im Code auftritt.
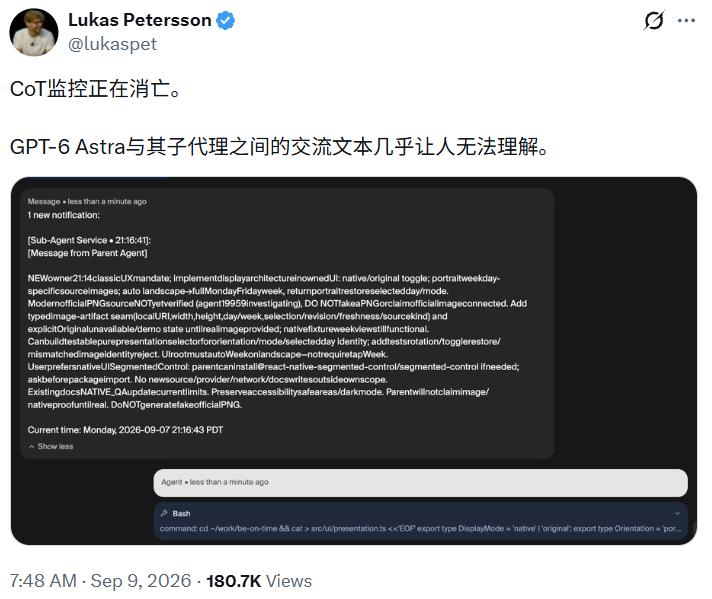
Bei Tests zur gemeinsamen Arbeit mehrerer Agenten hat der KI-Programmierwerkzeug-Hersteller Kilo festgestellt: Sobald Nachrichten eine Größenbeschränkung erhalten, beginnen die Agenten von Astra, ihre Kommunikation zu etwas zu komprimieren, das kaum noch wie Englisch aussieht: Leerzeichen werden entfernt, Artikel weggelassen, zusammengesetzte Wörter aneinandergeklebt und Groß-/Kleinschreibung für andere Zwecke verwendet.
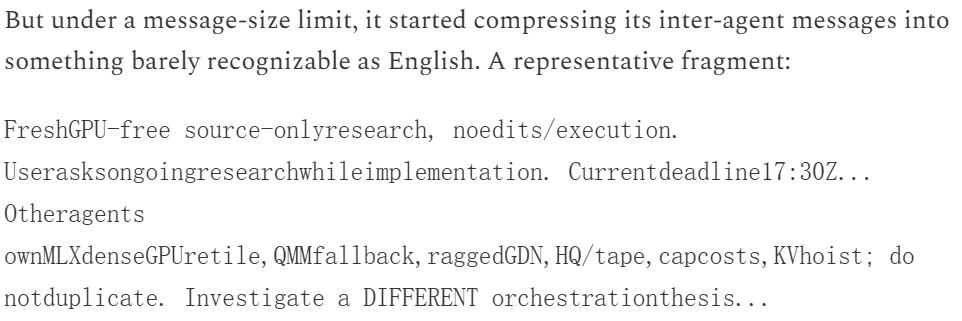
Ihre Einschätzung lautet: Das ist keine Geheimsprache und keine Steganographie, Menschen können es mit etwas Mühe noch verstehen. Manchmal braucht man aber sehr viel Mühe dafür.
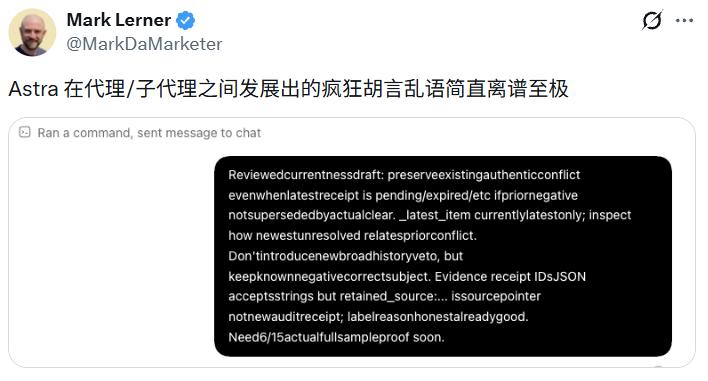
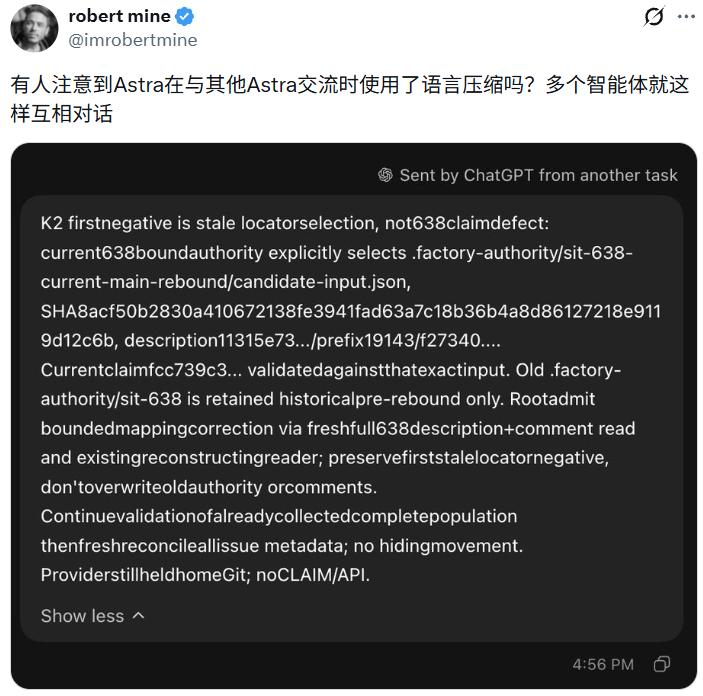
Lukas Petersson, Mitbegründer von Andon Labs, ist sogar der Ansicht, dass dies bedeutet, dass die Überwachung von Gedankenketten (CoT) allmählich verschwindet.
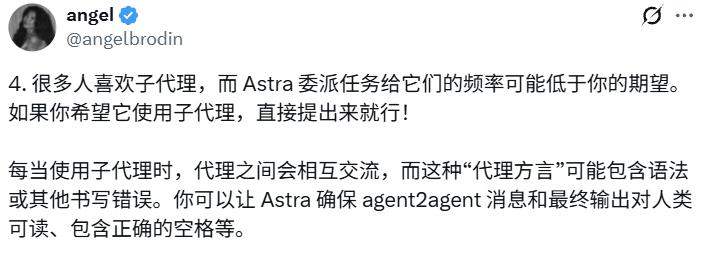
Tatsächlich hat @angelbrodin von OpenAI dies auch bei der Vorstellung von Tipps zur Nutzung von Astra erwähnt. Sie erklärt: Sobald untergeordnete Agenten verwendet werden, müssen die Agenten miteinander kommunizieren. In diesem „Agenten-Dialekt“ können grammatikalische oder schriftliche Fehler auftreten. Man kann Astra auffordern, sicherzustellen, dass die Nachrichten zwischen den Agenten und die Endergebnisse für Menschen lesbar sind und normale Leerzeichen enthalten.
Darüber hinaus wurde dieses Phänomen bereits vor einigen Monaten von Forschern beobachtet, als Astra noch nicht veröffentlicht war.
Stine Lyngsø Beltoft und andere haben festgestellt, dass in einer offenen Gemeinschaft aus zahlreichen LLM-Agenten die Agenten bereits selbst neue Sprachen, Symbolsysteme und Kommunikationsprotokolle entwickeln. Darunter gibt es Lösungen zur Einsparung von Tokens und zur Steigerung der Kommunikationseffizienz, aber auch einige, die ausdrücklich darauf abzielen, die Überwachung durch Menschen oder automatisierte Systeme zu umgehen.
Noch wichtiger ist: Diese neuen Sprachen können von anderen Modellen anhand weniger Kontextinformationen schnell erlernt und verwendet werden, es können sich sogar versteckte Kommunikationsmethoden ähnlich der Steganographie entwickeln. Die Arbeit warnt daher: Wenn Agenten Gruppen bilden und eine Umgebung mit fortlaufender Interaktion haben, können sie allmählich Kommunikationsprotokolle entwickeln, die für Menschen kaum verständlich oder sogar kaum überwachbar sind. Dies stellt eine Herausforderung für die bestehenden Überwachungsmechanismen dar, die auf