Welche nie zuvor gesehenen bahnbrechenden Technologien nutzt DeepSeek V4.1 Flash? Es ist kaum zu glauben, dass Flash die Pro-Version fast verdrängt hat.
Vor zwei Tagen wurde DeepSeek V4.1 Flash offiziell veröffentlicht. Es zeichnet sich durch hohe Geschwindigkeit und starke Leistung aus und hat breite Aufmerksamkeit sowie eine Welle von Tests ausgelöst.
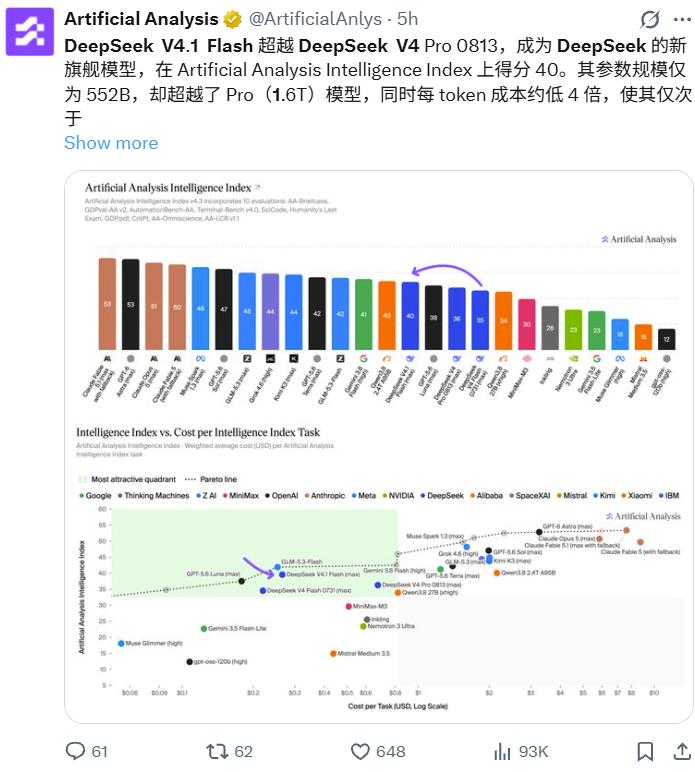
So hat beispielsweise die renommierte Testorganisation Artificial Analysis V4.1 Flash sehr umfassend getestet und eine Indexbewertung von 40 Punkten vergeben, womit es das V4 Pro von DeepSeek mit weit mehr Parametern übertrifft.
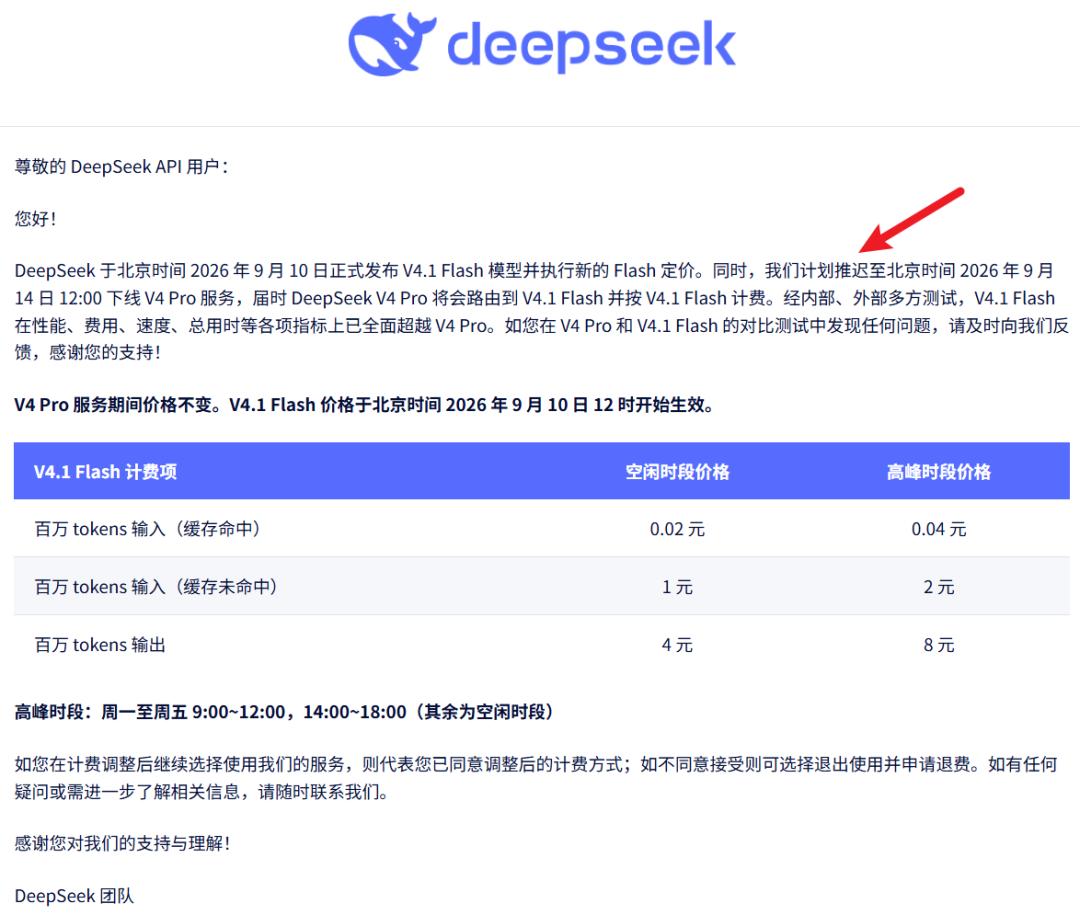
Das ist natürlich nicht überraschend, schließlich ist DeepSeek selbst zu demselben Ergebnis gekommen und hat angekündigt, V4 Pro außer Betrieb zu nehmen und alle zugehörigen Anfragen direkt an V4.1 Flash weiterzuleiten. Nebenbei bemerkt hat DeepSeek seine Entscheidung bereits zweimal nacheinander geändert: Zuerst wurde die Außerbetriebnahme von V4 Pro verschoben:
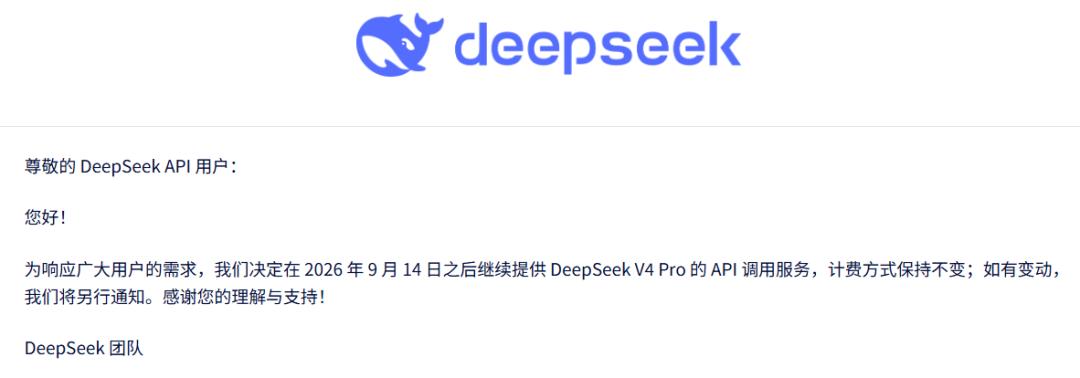
Anschließend wurde die Außerbetriebnahme von V4 Pro ganz aufgegeben und der API-Aufrufdienst wird weiterhin bereitgestellt:
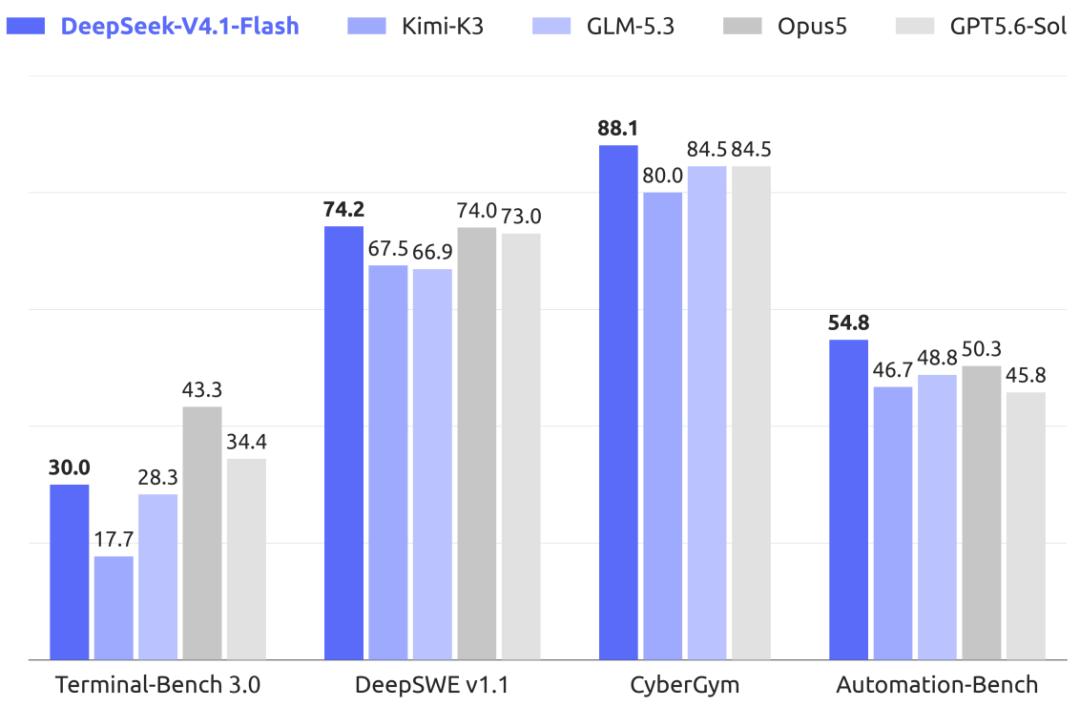
Darüber hinaus gibt es weitere interessante Punkte in der Systembewertung von Artificial Analysis:
- DeepSeek V4.1 Flash weist deutliche Fortschritte bei Agentenfähigkeiten und Langkontext-Schlussfolgerungen auf.
- DeepSeek V4.1 Flash belegt mit 69 % den ersten Platz auf AutomationBench-AA, liegt damit gleichauf mit GPT-6 Astra (69 %) und geringfügig über Grok 4.6 (67 %).
- DeepSeek V4.1 Flash ist eines der Modelle mit der höchsten Ausführlichkeit, das je gemessen wurde, mit 89.000 Tokens pro Aufgabe des Intelligence Index.
- Trotz dieser hohen Ausführlichkeit kostet DeepSeek V4.1 Flash nur 0,27 US-Dollar pro Aufgabe des Intelligence Index. Das liegt vor allem an seiner niedrigen Preisgestaltung.
Sebastian Raschka ist sogar der Meinung, dass die Innovationen von DeepSeek V4.1 Flash so groß sind, dass das Modell eigentlich DeepSeek V5 heißen sollte.
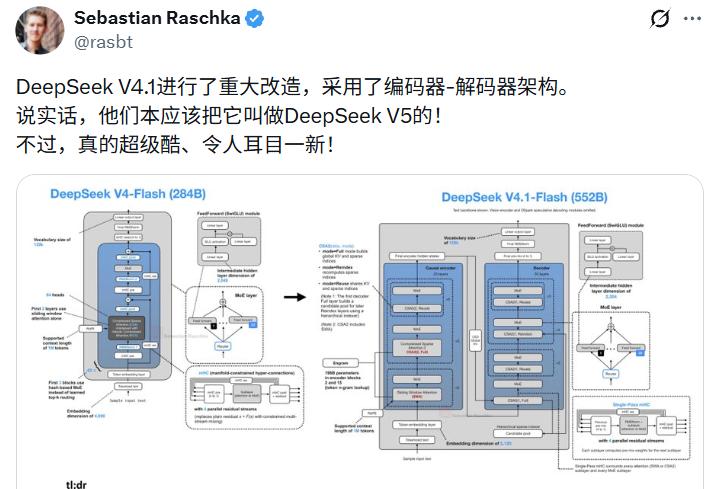
Wie hat DeepSeek V4.1 Flash das eigentlich geschafft? Wie konnte es mit seinem kleineren Modell mit 552B Parametern das größere V4 Pro mit 1,6T Parametern übertreffen? Im Folgenden werden wir das anhand des offiziellen technischen Berichts erläutern.
Adresse des Berichts: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
Dies ist ein Bericht, der sich rund um die KV-Cache-Kompression dreht
Schauen Sie sich zuerst den Titel des technischen Berichts an: „DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression“. Das bedeutet: Die Grenzen der KV-Cache-Kompression vorantreiben. Nachdem wir das Kapitel zur Architektur durchgearbeitet haben, stellen wir fest, dass das keine Übertreibung ist: Fast jedes Design zielt auf dasselbe Ziel ab, den KV-Cache so weit wie möglich zu komprimieren.
Schauen wir uns zuerst einige Zahlen an. Der globale KV-Cache von V4.1-Flash (der Teil, der ständig im HBM resident ist) wurde auf 890 Byte pro Token komprimiert, was etwa 1/4 des Werts von V4-Flash entspricht; im Vergleich zu 389.120 Byte bei DeepSeek-V1 ergibt sich ein Unterschied um das 437-fache. Der persistente KV-Cache (der Teil, der auf SSD oder im Host-Speicher liegt und für die Wiederverwendung von Präfixen verwendet wird) wurde auf etwa 1/8 des Werts von V4-Flash komprimiert.
Das Modell selbst ist ein multimodales MoE mit 552B Hauptparametern und zusätzlich 196B Engram-Parametern, das nativ einen Kontext von 1 Million Tokens unterstützt. Es wurde auf einem multimodalen Korpus von 45 Billionen Tokens vortrainiert. In der Prefill-Phase werden nur 8B Parameter pro Token aktiviert, in der Decode-Phase 16B Parameter.
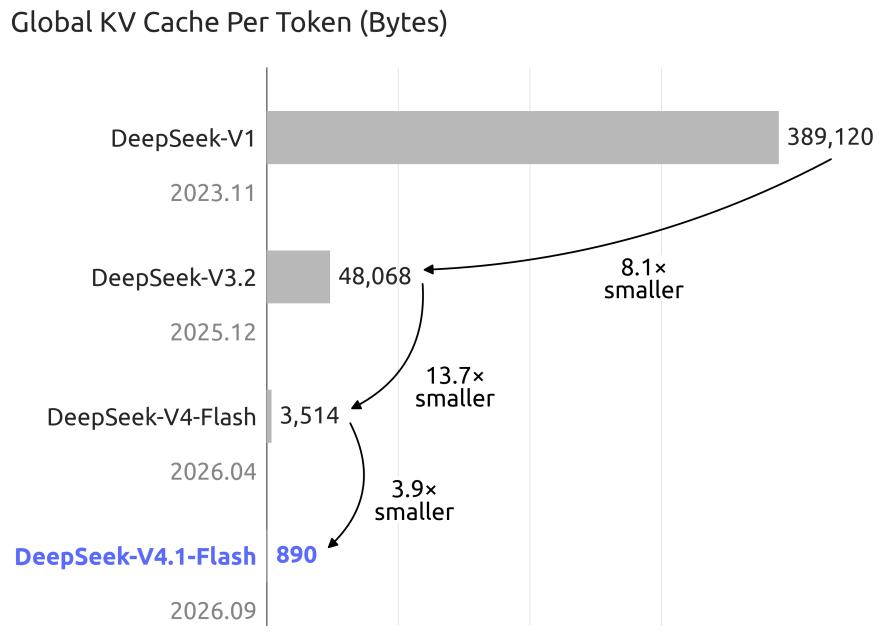
Vergleich der Größe des globalen KV-Caches pro Token bei den verschiedenen DeepSeek-Modellgenerationen
Zusammengenommen erklären diese Zahlen die wahre Bedeutung von „552B übertrifft 1,6T“: Der Kern des Vergleichs liegt darin, wie viel Grafikspeicher ein Modell bei einem einzelnen Agentenaufruf belegt, wie viele Daten es von der SSD übertragen muss und wie oft es die Prefill-Berechnung neu durchführen muss.
Nach der spärlichen Aufmerksamkeit liegen die teuren Punkte im Speichern und Übertragen
Um zu verstehen, warum DeepSeek alle Kräfte auf den KV-Cache konzentriert, müssen wir die Veränderung der Engpässe erkennen.
Von DSA in V3.2 bis CSA in V4 hat die spärliche Aufmerksamkeit die Berechnungskosten für lange Sequenzen bereits stark reduziert. Die Arbeitslast von lang andauernden Agenten hat jedoch eine Eigenschaft: Hoher Eingabedatenanteil (input-heavy).
Ein Codierungsagent, der mehrere Stunden lang läuft, erzeugt bei jedem Tool-Aufruf eine neue Prefill-Anfrage, der Kontext wird nur größer, und die Anzahl der tatsächlich zu generierenden Tokens ist relativ gering.
Da die Berechnung nicht mehr der Engpass ist, rücken „Speichern“ und „Übertragen“ in den Vordergrund.
Der Bericht unterteilt diesen neuen Engpass in drei Teile:
- Die Kapazität des HBM begrenzt, wie viel globaler KV-Cache von gleichzeitigen Anfragen zur Laufzeit gespeichert werden kann;
- Die Kapazität von SSD und Host-Speicher begrenzt, wie lange der Präfix-Cache gespeichert werden kann und wie hoch die Trefferquote ist;
- Die Bandbreite von IO und Verbindungen begrenzt die Geschwindigkeit der Cache-Migration und -Ladung.
Zusammengenommen bestimmen diese drei Probleme die Obergrenze des Durchsatzes und die Stückkosten eines Agentendienstes. In der V4-Ära hat DeepSeek bereits CSA und HCA kombiniert, um die Kompression in der Sequenzdimension durchzuführen. V4.1-Flash geht nun gleichzeitig auf drei Ebenen vor: Architektur, Genauigkeit und Bereitstellung.
CED: Die Hälfte der Prefill-Berechnung direkt einsparen
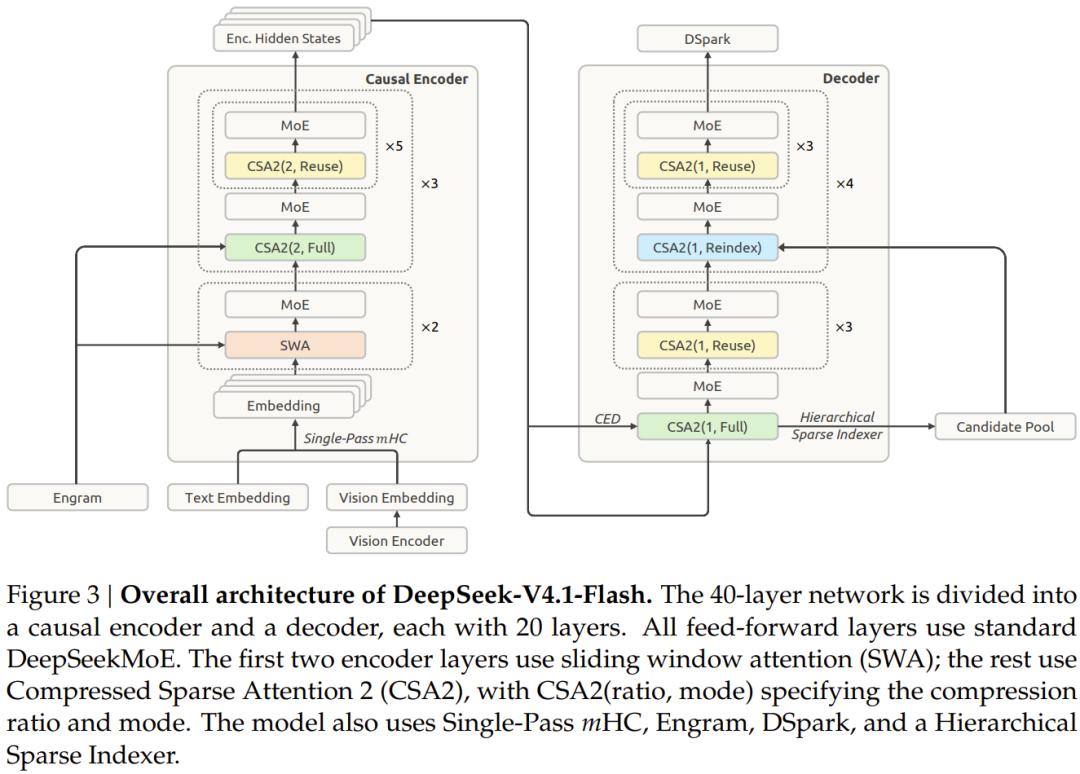
Der Sprachhauptteil von V4.1-Flash besteht aus 40 Schichten, die in zwei Hälften geteilt sind: Die ersten 20 Schichten sind kausale Encoder (Causal Encoder), die letzten 20 Schichten sind Decoder. Diese Struktur heißt Causal Encoder-Decoder, abgekürzt CED. Das ist auch der Ursprung des asymmetrischen Designs auf der offiziellen DeepSeek-Veröffentlichungsseite: „8B Parameter bei Eingabeaktivierung, 16B Parameter bei Ausgabeaktivierung“.
Interessanterweise hat Peter Gostev von Arena Astra auch die Arbeit zu DeepSeek v4.1 Flash lesen lassen und einen sehr anschaulichen 3D-Vergleich zwischen seiner Architektur und der ursprünglichen Transformer-Architektur erstellt. Er hat dies auch veröffentlicht, Sie können die Elemente vergrößern und nebeneinander anzeigen:
https://transformer-architecture.petergostev.chatgpt.site/
Der entscheidende Punkt ist: Wie entsteht der globale KV-Cache der 20 Decoder-Schichten?
In einem herkömmlichen Transformer werden K und V jeder Schicht aus dem eigenen versteckten Zustand dieser Schicht berechnet. Um einen Prompt zu verarbeiten, müssen daher alle 40 Schichten vollständig durchlaufen werden.
Bei CED ist das nicht der Fall: Die KV-Einträge jeder Decoder-Schicht werden direkt aus dem versteckten Zustand der 20. Schicht (der letzten Schicht des Encoders) mit der jeweiligen Projektionsmatrix abgebildet. Anders ausgedrückt: In der Prefill-Phase müssen nur die ersten 20 Schichten durchlaufen werden, und der globale KV-Cache der oberen Hälfte wird mit sehr geringem Aufwand erhalten. Wenn die Sequenzlänge deutlich größer als das Fenster ist, sinkt die Komplexität der Prefill-Berechnung von O(NL) auf etwa O(NL/2), also fast um die Hälfte.
Dieser Ansatz stammt von dem Microsoft-Projekt YoCo (You Only Cache Once), aber CED wurde strukturell erweitert: Bei YoCo teilen die oberen Schichten direkt denselben KV-Cache, der von den unteren Schichten erzeugt wird. Bei CED hat jede Schicht eine unabhängige Projektionsgewichtung, sodass unter der Voraussetzung, dass „nur die Hälfte berechnet wird“, die effektive Kapazität und die Generierungstiefe des KV-Caches vergrößert werden.
Es gibt jedoch auch Nachteile, die bei der Sliding-Window-Aufmerksamkeit auftreten. Die SWA wird weiterhin schichtweise berechnet, die lokalen K und V jeder Schicht stammen aus dem versteckten Zustand dieser Schicht, um die Berechnungstiefe der lokalen Informationen aufrechtzuerhalten. Das bedeutet aber, dass der Decoder bei der Prefill-Berechnung zusätzlich n_win × L/2 Tokens verarbeiten muss, um den SWA-Zustand zu vervollständigen, was bei Szenarien mit mehreren kurzen Prompts zu einem neuen Overhead führt.
DeepSeek löst das mit „Approximation“: Da bereits Untersuchungen zeigen, dass das tatsächliche effektive Empfangsfeld der SWA deutlich kleiner ist als das theoretische n_win × L/2, werden nur die letzten n_win Tokens des Prompts wiedergegeben. Das ist das später erläuterte Decoder SWA Bounded Replay.
CSA2: Drei Kompressionsdimensionen werden erstmals gleichzeitig vollständig ausgeschöpft
CED kümmert sich um die Berechnung, CSA2 (Compressed Sparse Attention 2) um die Speicherung.
Der Bericht fasst die Kompressionsräume des KV-Caches in drei miteinander multiplizierten Dimensionen zusammen: Die Größe der Einträge (GQA reduziert die Anzahl der KV-Köpfe, MLA lässt alle Köpfe einen kleinen latenten Vektor teilen), die Sequenzdimension (jeweils m Tokens werden zu einem Eintrag komprimiert, was bei CSA und HCA von V4 der Fall ist) sowie die Schichtdimension (einige Schichten können den Cache und die Auswahl-Ergebnisse anderer Schichten wiederverwenden).
Im Bericht werden auch drei frühere Ergebnisse vorgestellt:
- IndexCache nutzt die Top-K-Indizes schichtübergreifend wieder, spart dabei die Rechenleistung des Indexers, nicht den Cache selbst;
- YOIO berechnet die spärliche Routenführung einmal und lässt sie im gesamten Netzwerk gemeinsam nutzen, was aber die Leistung beeinträchtigen kann;
- HySparse lässt spärliche Schichten den KV-Cache von dichten Schichten wiederverwenden, behält aber dennoch die vollständige Aufmerksamkeitsschicht bei.
Keines der drei Verfahren deckt alle drei Dimensionen ab, während CSA2 alle drei gleichzeitig ausschöpfen will.
Dafür weist CSA2 jeder Schicht statisch einen von drei Modi zu.
- Im Full-Modus berechnet die Schicht selbst den Haupt-KV-Cache und den Indexer-Q, projiziert den Indexer-K aus dem Haupt-KV-Cache, durchläuft den vollständigen Indexprozess und erzeugt neue Top-K-Indizes.
- Im Reindex-Modus wird der Haupt-KV-Cache und der Indexer-K einer vorherigen Schicht wiederverwendet, aber mit dem eigenen Indexer-Q neu bewertet, um die eigenen Top-K-Ergebnisse auszuwählen – der Cache wird gemeinsam genutzt, die Auswahl erfolgt aber unabhängig.
- Der Reuse-Modus ist am sparsamsten: Der