Warum setzen sowohl NVIDIA als auch JD.com gleichzeitig ihre Wetten für die zweite Phase der KI-Entwicklung auf Physical AI?
Gleich zu Beginn des Septembers wurden die Flughäfen in vielen Teilen des Landes plötzlich von einer auffälligen Werbetafel überflutet – „Bringe die KI in die physische Welt“, kurz formuliert und mit einer direkten Bedeutung, unterzeichnet von JD Cloud.
Gleichzeitig mit der Veröffentlichung dieser Werbetafel hat die am 9. September abgehaltene JDD (JD Discovery/Developer Conference) ihr Thema eindeutig auf „Physische KI“ ausgerichtet.
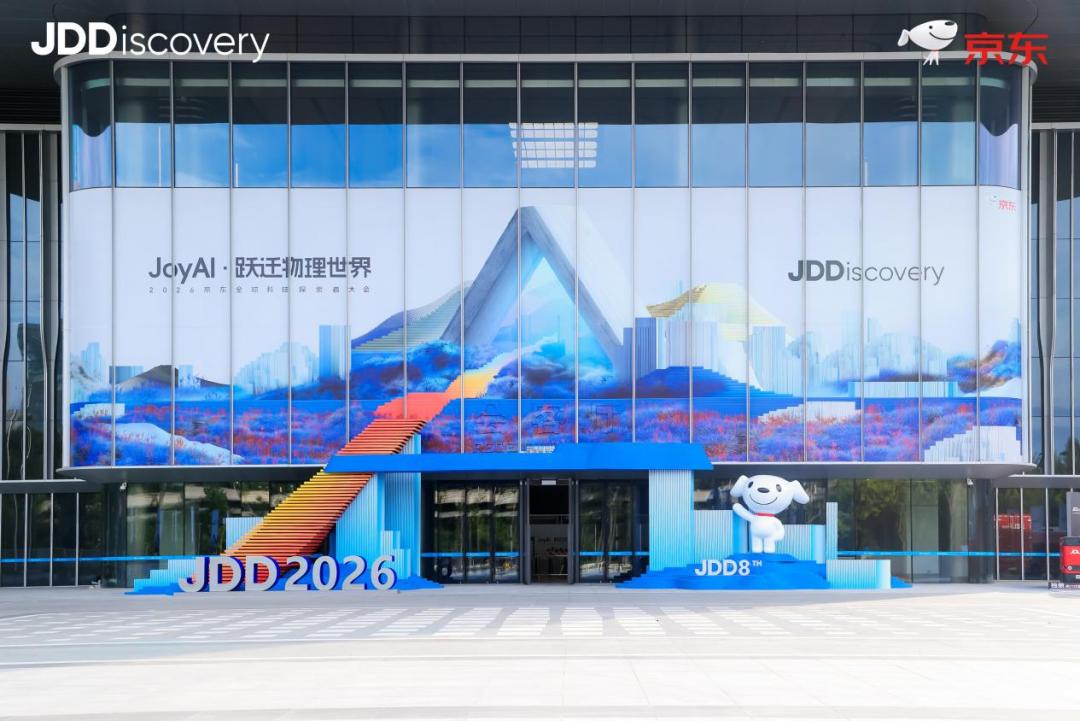
„Physische KI“ ist zweifellos das wichtigste Thema im chinesischen Kontext der vergangenen sechs Monate, und die physische Welt gilt als die nächste Station der KI.
Nach zwei Jahren technischer Feier hat die Branche wild die Inferenzgeschwindigkeit, lange Kontexte und sogar die Ähnlichkeit von Chatbots mit echten Menschen gesteigert. Aber jetzt steht ein sehr reales, sogar etwas grausames Problem auf dem Tisch: Wie lassen sich diese Token, die eine astronomische Menge an Rechenleistung verbrauchen, und die massiven Datenströme, die auf der C-Ende angesammelt wurden, in echten kommerziellen Wert umwandeln?
Aus der Perspektive eines Industriebeobachters spiegelt diese Umstellung zwei Kernfragen wider: Warum muss KI die digitale Welt verlassen? Und warum erobern Unternehmen wie JD diese Hochburg?
01
Wenn die KI beginnt, das Chatfenster zu verlassen
In den letzten Jahren der KI-Entwicklung ging es im Wesentlichen darum, Punkte in der virtuellen digitalen Welt zu sammeln. Aber der sinkende Grenznutzen der technischen Iteration und die hohen Betriebskosten zwingen die gesamte Branche, sich der Realität zu stellen: Wie viele Arbeiten können diese Fähigkeiten letztendlich erledigen und wie viel praktischen Wert können sie schaffen?
Agent ist das offensichtlichste Signal.
Die früheren Copiloten waren hauptsächlich am Arbeitsprozess der Menschen beteiligt, halfen Programmierern beim Schreiben von Code, Verkäufern beim Sortieren von Materialien und Finanzmitarbeitern bei der Analyse von Daten; Agenten beginnen nun, weitere vollständige Aufgaben zu übernehmen, Unternehmensdaten zu lesen, verschiedene Tools aufzurufen und die Ergebnisse wieder in die Geschäftssysteme zu schreiben. Eine von OpenAI im Juni dieses Jahres veröffentlichte Studie fasst diese Veränderung so zusammen, dass sich die grundlegende Einheit der Wissensarbeit von einzelnen Interaktionen zu „delegierbaren langfristigen Aufgaben“ wandelt.
Die Art und Weise, wie Unternehmen KI messen, ändert sich entsprechend. Wenn Token messen, wie viel Intelligenz das Modell erzeugt, und Task messen, wie viele Arbeiten die KI übernehmen kann, dann müssen Unternehmen letztendlich noch einen Rückgang der Kosten, eine Steigerung der Effizienz und einen geschlossenen Geschäftsablauf sehen, also das Ergebnis.
Wenn die allgemeinen Fähigkeiten der zugrunde liegenden großen Modelle allmählich ausgeglichen werden, hat „wer die größten Parameter hat“ keinen absoluten Schutz mehr. Das Schlachtfeld des KI-Wettbewerbs wird zwangsläufig zu „wer tief in die Industrieprozesse eingebunden ist und konkrete Probleme löst“ verlagert.
Das ist auch der Hintergrund, warum JD auf der diesjährigen JDD die „physische KI“ in den Mittelpunkt stellt.
JDs Urteil lautet: Der KI-Wettbewerb wandelt sich von einem „Parameter-Wettbewerb“ zu einem „Produktivitätswettbewerb“. Auf der JDD hat JD Cloud, Daten, Modelle, Endgeräte, Szenarien und Lieferketten in ein einziges System integriert, um die KI weiter in echte Szenarien wie Einzelhandel, Logistik, Industrie, Gesundheit und Haushalt zu bringen.
Im Gegensatz zur Branche, die „physische KI“ weitläufig als allgemeine Bezeichnung für Roboter verwendet, ist die von JD diskutierte Logik offensichtlich viel umfassender.
Roboter sind eine typische Form, bei der KI direkt auf die reale Welt einwirkt, aber umfassendere Veränderungen haben sich bereits in verschiedenen Industrien still und leise vollzogen: Einzelhandels-KI muss letztendlich Transaktionen und Erfüllung beeinflussen, Logistik-KI beginnt an Lagerhaltung und Lieferung teilzunehmen, industrielle KI tritt in Produktionsprozesse ein, und Roboter wandeln die Urteile des Modells weiter in physische Aktionen um. Die KI beginnt, von der Erzeugung von Informationen weiter an Produktions- und Dienstleistungsprozessen in der realen Welt teilzunehmen.
Diese Einschätzung wird auch zu einem grundlegenden Konsens der globalen KI-Industrie. In diesem Jahr hat NVIDIA das Layout der physischen KI ständig verstärkt, von dem Cosmos-Weltmodell, dem Isaac-Simulationsframework bis zum GR00t-Robotermodell, und arbeitet mit Giganten wie ABB, FANUC und Figure zusammen, um die Technologie in Szenarien der Elektronikmontage und industriellen Automatisierung zu bringen.
Physische KI erstreckt sich von einem technischen Zweig im Roboterbereich zu dem einzigen Hauptpfad, auf dem KI in die realen Produktionssysteme eindringt und den Produktivitätswert realisiert.
02
Warum ist es für KI schwieriger, in die physische Welt einzudringen?
Die rasante Entwicklung großer Modelle in den letzten Jahren basiert zu einem großen Teil auf den massiven digitalen Inhalten, die das Internet bereits angesammelt hat. Webseiten, Bücher, Bilder, Videos und Code können ständig für das Training verwendet werden; nachdem das Modell trainiert wurde, kann es über APIs schnell in verschiedenen Produkten und bei Benutzern bereitgestellt werden.
Aber bei der physischen KI stößt das Scaling Law auf das berühmte „Moravec-Paradoxon“ – Für KI ist abstraktes logisches Denken einfacher geworden, aber in der komplexen realen physischen Welt ein Objekt zu greifen oder ein kleines Hindernis zu erkennen, ist äußerst schwierig.
Wenn eine KI ein Lager betritt, muss sie wissen, wo sich die Waren befinden, wie sich der Bestand ändert und wie verschiedene Geräte zusammenarbeiten; wenn sie eine Fabrik betritt, muss sie Materialien, Maschinen und Produktionsprozesse verstehen; wenn sie in einen Haushalt eintritt, muss sie sich an verschiedene Räume und Hardware anpassen; wenn sie in einen Roboter eintritt, bezieht sie sich weiter auf Aktionen, Kraft, Umgebungsrückmeldungen und Unterschiede zwischen verschiedenen Körpern.
Das ist auch der Grund, warum die Entwicklung der physischen KI den Scaling-Pfad großer Modelle der letzten Jahre nicht einfach kopieren kann. NVIDIA hat das Kernproblem der Roboterentwicklung einst als „data gap“ zusammengefasst: Das Internet stellt umfangreiche Vortrainingsdaten für große Sprachmodelle bereit, aber die Menge der Roboterdaten in der realen Welt ist begrenzt, die Erfassung ist teuer, und viele Extremszenarien lassen sich nur schwer durch echte Erfassung abdecken.
Konkret auf die industrielle Umsetzung bezogen lassen sich die Probleme, die die physische KI lösen muss, weiter in drei Ebenen zusammenfassen: Gibt es genügend Daten zum Lernen, genügend Szenarien zur Überprüfung und kann nach erfolgreicher Überprüfung eine Skalierung erreicht werden?
Das entspricht genau der Logik, die JD auf der JDD vorgeschlagen hat: Daten lassen die KI evolvieren, Szenarien lassen die KI überprüfen, und Lieferketten lassen die KI skalieren.
Zuerst geht es um Daten.
Daten in der digitalen Welt zeichnen hauptsächlich das Wissen auf, das Menschen bereits ausgedrückt haben. Physische KI muss weiter verstehen, wie sich Menschen und Objekte bewegen, wie Aktionen die Umgebung verändern und wie Aufgaben im realen Raum erledigt werden. Die Produktionskosten für solche Daten sind auch höher. Ein Webseitentext kann direkt vom Modell gelesen werden, aber eine Roboteraufgabe kann verschiedene Modalitäten wie Kameras, Sensoren, Aktionsspuren und Kraftrückmeldungen beinhalten und erfordert Erfassung, Kennzeichnung, Training und Überprüfung in der realen Umgebung.
JD hat sich entschieden, die Dateninfrastruktur weiter in die reale Welt auszudehnen. Derzeit deckt sein System für körperliche Daten die gesamte Kette von „Erfassung, Speicherung, Kennzeichnung, Training, Bewertung, Simulation und Prüfung“ ab und plant, innerhalb von zwei Jahren insgesamt 10 Millionen Stunden an Videodaten aus realen Szenarien anzusammeln. Die Datenquellen haben sich auch von Roboter-Körperdaten auf Kraft-Touch-Daten, Simulationsdaten und Videomaterial aus der ersten Perspektive menschlicher Bediener erweitert.
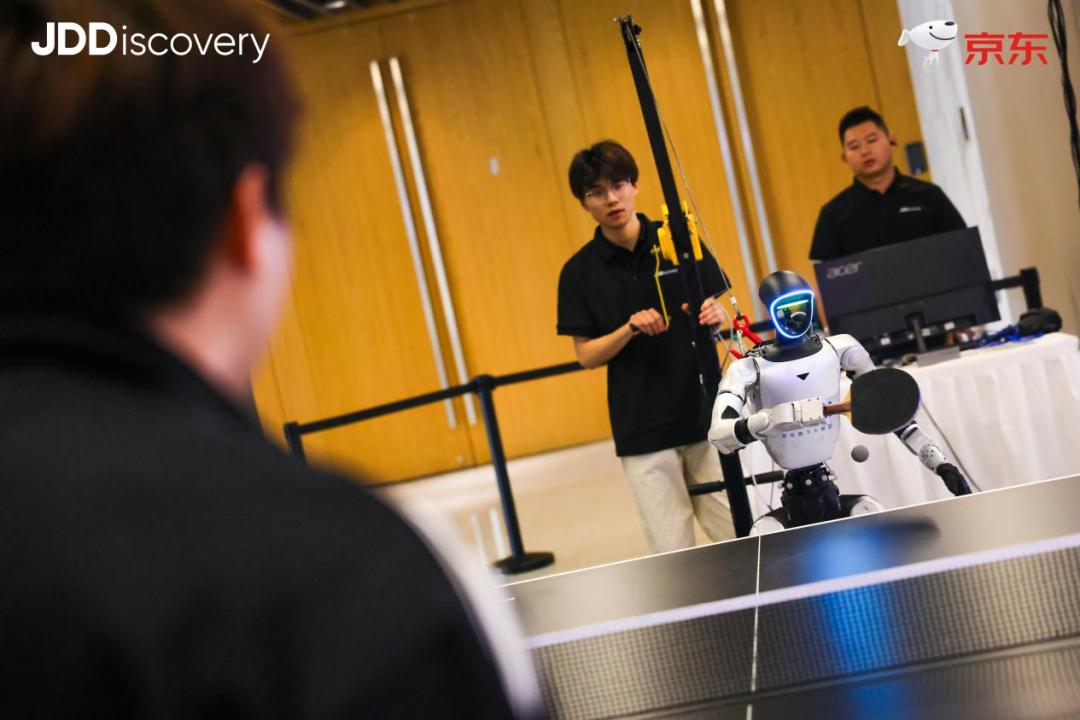
Neben Daten ist die zweite Barriere das Szenario.
Physische KI steht letztendlich vor einer sich ständig verändernden realen Umgebung mit einer extrem niedrigen Fehlertoleranz. Eine Fähigkeit, die in Benchmarks oder Labors funktioniert, bedeutet nicht, dass sie auch in Lagern, Fabriken und Haushalten wirksam bleibt.
Das führt auch zu einem grundlegenden Unterschied zwischen physischer KI und allgemeinen digitalen Modellen: Bei digitaler KI wird das Modell normalerweise zuerst trainiert und dann in Szenarien wie Suche und Büroarbeit bereitgestellt; bei physischer KI vertieft sich die Beziehung zwischen Szenario und Modell, und das Szenario selbst ist Teil der weiteren Iteration der KI-Fähigkeiten.
Echte Geschäftsvorgänge erzeugen Daten, die Daten fließen in das Modelltraining ein, das Modell kehrt zurück, um Aufgaben im Geschäft auszuführen, und die Ausführungsergebnisse bilden weiterhin neue Rückmeldungen – so entsteht ein sich ständig drehender Schwungrad zwischen Daten, Modell und Szenario.
Aus dieser Sicht haben die von JD im Einzelhandel, in der Logistik, Industrie, Gesundheit und im Haushalt angesammelten Geschäftsvorgänge einen einzigartigen Wert im KI-Zeitalter. Am Beispiel von Industrieszenarien hat JD mitgeteilt, dass sein großes industrielles Modell JoyIndustrial bereits über 1 Milliarde Mal aufgerufen wurde, und seine Anwendungen reichen von der Verständnis industriellen Wissens weiter bis zur Planung von Agentenaufgaben, dem Aufruf von Tools und der Ausführung in Unternehmensgeschäftssystemen, wobei die Ausführungsergebnisse wieder in das System zurückfließen.
Szenarien sind nicht nur der Ort, an dem KI-Fähigkeiten letztendlich angewendet werden, sondern auch der physische geschlossene Kreislauf, in dem KI echte Rückmeldungen erhält und seine eigene Evolution vollendet.
Die dritte Barriere ist die Skalierung.
Zwischen der Erledigung einer Aufgabe im Labor und dem langfristigen stabilen Betrieb einer großen Anzahl von Geräten in verschiedenen Umgebungen liegt noch eine große Distanz im Ingenieurwesen und in der Industriekette. Nachdem KI in die reale Welt eingetreten ist, ist die Modellbereitstellung nur ein Glied davon – Hardwareproduktion, Komponenten, Vertriebskanäle, Logistik, Installation, Wartung und Kundendienst beeinflussen alle, ob sich letztendlich ein geschlossener Geschäftsablauf bilden kann.
Daher ist in den sechs Wörtern von JD „Cloud, Daten, Modell, Endgerät, Szenario, Kette“ das letzte „Kette“ besonders bemerkenswert.
Das Modell bestimmt, ob eine Fähigkeit realisiert werden kann, das Szenario prüft, ob sie in der realen Umgebung funktioniert, und die Lieferkette bestimmt, ob diese Fähigkeit in eine ausreichend große reale Welt gelangen kann.
Das bildet auch einen vollständigeren Satz von industriellen Barrieren für physische KI: Daten bestimmen, wie KI die Realität versteht, Szenarien bestimmen, wie KI sich an die Realität anpasst, und Lieferketten bestimmen, wie KI skaliert in die Realität eintritt.
Wenn sich die für den Wettbewerb erforderlichen Ressourcen ändern, kann sich die ursprüngliche Rangfolge der KI-Vorteile zwischen großen Technologieunternehmen entsprechend ändern.
03
Physische KI kann die KI-Vorteile großer Technologieunternehmen neu definieren
Da physische KI Wettbewerbsvariablen in die reale Welt einbringt, erhalten die physischen Infrastrukturen, die JD in den letzten mehr als 20 Jahren angesammelt hat, einen neuen Erklärungsraum.
Im Vergleich zu vielen Internetplattformen, die hauptsächlich online betrieben werden, hat JDs Geschäft schon früh den tatsächlichen Zirkulationsprozess von Waren und Dienstleistungen durchdrungen. Von Beschaffung, Bestand, Lagerhaltung bis zu Lieferung und Kundendienst, weiter zu industrieller Beschaffung, Gesundheitsdiensten, Haushaltsgeräten und intelligenter Hardware erfordern eine große Anzahl von Geschäftsvorgängen die gleichzeitige Verbindung von Online-Systemen und Offline-Erfüllung.
Diese Fähigkeiten dienten früher hauptsächlich der Effizienz von E-Commerce und Lieferketten. Nach dem Eintritt in die Phase der physischen KI können sie auch die Grundlage werden, auf der KI Daten erhält, trainiert und überprüft, und letztendlich eine skalierte Bereitstellung erreicht.
Der Kern des „Super-KI-Lieferketten“-Konzepts, das JD auf der JDD vorgeschlagen hat, besteht darin, dieses physische Netzwerk tief mit KI zu verbinden. Von der zugrunde liegenden Cloud, Daten und Modellen über die mittleren Ebenen von Agenten, Entwicklungsplattformen und Simulationswerkzeugen bis hin zur Verbindung von Endgeräten wie Robotern, Haushaltsgeräten, medizinischen Geräten und fahrerlosen Fahrzeugen gelangt es letztendlich in tatsächliche Geschäftsvorgänge wie Einzelhandel, Logistik, Industrie, Gesundheit und Haushalt.
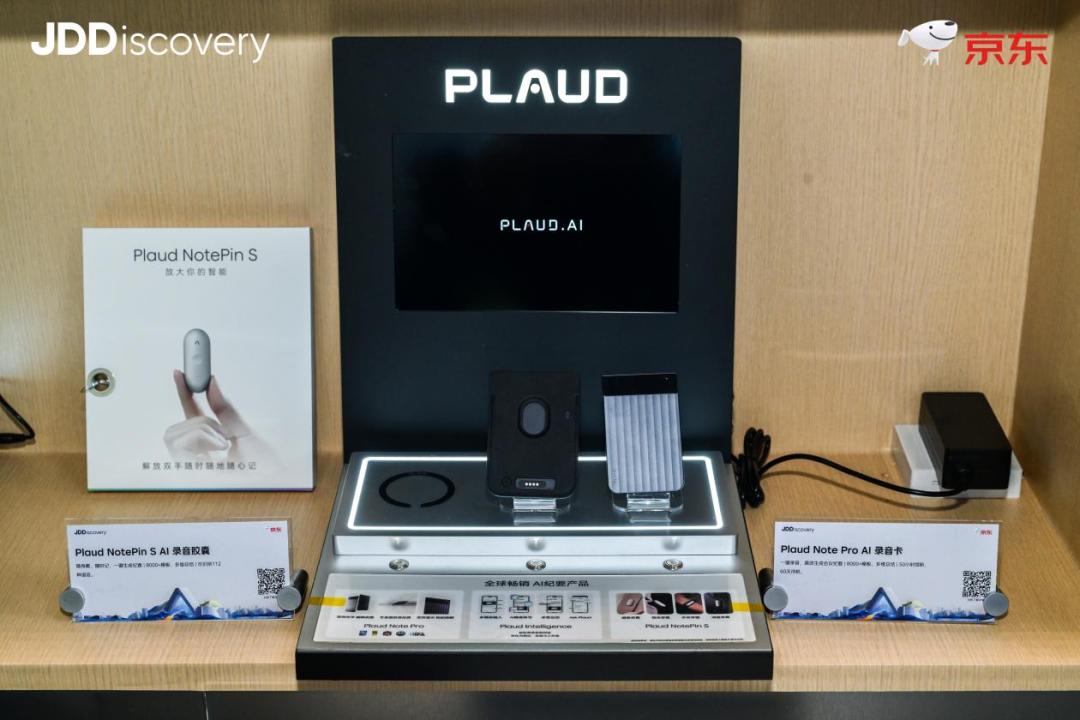
Die Roboterindustrie kann diese Umsetzungsweise der „Super-KI-Lieferkette“ direkter widerspiegeln.
Die Position, die sich JD derzeit selbst setzt, beschränkt sich nicht auf die Entwicklung eines bestimmten Roboterprodukts. Gemäß dem auf dieser JDD offengelegten Plan möchte JD gleichzeitig Glieder wie die Erfassung körperlicher Daten, industrielle Basen für Roboter, Versorgung mit Kernkomponenten, Einzelhandelskanäle und Wartungsdienste abdecken.
In den nächsten fünf Jahren plant JD, mehr als 80 RoboBase-Standorte zu errichten; auf der Seite der Lieferkette soll die BOM-Kosten von Roboter-Körpern um mehr als 50 % gesenkt werden durch skalierte Einkäufe, C2M-Anpassung und Koordination der Lieferkette; auf der Seite von Vertrieb und Dienstleistungen wird vorgeschlagen, innerhalb der nächsten drei Jahre 100 Roboter-Marken dabei zu unterstützen, einen Umsatz von über 1 Milliarde