Aufbau globaler Rechenleistungsknoten: GoodVision AI errichtet ein flächendeckendes, dynamisch zuweisendes AI Compute Grid
Jensen Huang veröffentlichte einen Beitrag über KI-Fabriken, der innerhalb von weniger als 12 Stunden mehr als eine Million Aufrufe erzielte.
Der Beitrag erörterte keine leistungsfähigeren Modelle, sondern sprach über Grundstücke, Stromversorgung, Rechenzentren und vollständige Rechensysteme. Seiner Einschätzung nach ist nicht der Algorithmus, sondern die Infrastruktur zu der Hauptbeschränkung für das Wachstum der KI geworden. Denn diese Dinge, die für normale Nutzer weit entfernt erscheinen, bestimmen eine immer realer werdende Frage: Warum steigen die KI-Ausgaben von Unternehmen oft schneller als ihr Geschäftswachstum, obwohl die Aufrufe von Modellen immer günstiger werden?
Die Antwort liegt in einer scheinbar gewöhnlichen Aufgabe:
Ein Softwareunternehmen ließ einen Agenten bei der Beseitigung von Online-Störungen unterstützen. Er muss Warn- und Betriebsprotokolle lesen, fehlerhaften Code lokalisieren, interne Dokumente durchsuchen, Abhängigkeiten zwischen vorgelagerten und nachgelagerten Komponenten analysieren, Reparaturlösungen generieren, dann Tools aufrufen, um Tests auszuführen und die Ergebnisse zu prüfen. Der Ingenieur gibt möglicherweise nur eine einzige Anweisung, aber der Agent muss im Hintergrund Dutzende von Schritten nacheinander ausführen, um sie zu erfüllen. Jeder Schritt kann ein Modell aufrufen, und jeder Aufruf verbraucht Rechenleistung.
Diese Aufrufe sind zudem nicht alle gleichartig. Für das Sortieren von Protokollen ist kein leistungsstärkstes Modell erforderlich, während die Bestimmung der Störungsursache komplexe Schlussfolgerungen erfordern kann; ein Teil des Codes kann an Cloud-Modelle übergeben werden, während Protokolle mit Kundendaten unbedingt im Unternehmensinternen verbleiben müssen; normale Analysen können einige Sekunden länger warten, aber Warnungen von Produktionssystemen vertragen keine langen Netzwerkumläufe. Wenn alle Aufgaben an dasselbe Modell und dasselbe Rechenzentrum übermittelt werden, erhalten Unternehmen nicht unbedingt bessere Ergebnisse, aber sie werden zwangsläufig höhere Kosten und größere Latenzen tragen.
Das ist die wahre Bedeutung des Eintritts der KI in die Infrastrukturphase. Der Wettbewerb findet nicht mehr nur zwischen Modellen statt, sondern auch bei jeder Zuweisung hinter den Modellen: Welche Aufgabe welches Modell verwenden soll, an welchem Knotenpunkt sie ausgeführt wird und mit welchen Kosten sowie welcher Geschwindigkeit sie abgeschlossen wird. Wenn solche Entscheidungen täglich millionenfach getroffen werden, bestimmen nicht nur die Menge der erworbenen Rechenleistung die KI-Kosten eines Unternehmens, sondern auch, ob diese Rechenleistung an der richtigen Stelle eingesetzt wird.
Das ist auch der Bereich, in dem GoodVision AI derzeit tätig wird. Es übernimmt mit modularen KI-Fabriken lokale und regionale Inferenzanforderungen, wobei eine einzelne Fabrik bis zu 1,5 MW Inferenzrechenleistung auf nur 200 Quadratmetern Fläche bereitstellen kann. Die entsprechenden Projektplanungen decken bereits Japan, Südkorea und die Vereinigten Staaten ab. Noch wichtiger als die Menge der aufgebauten Rechenleistung ist, dass GoodVision AI versucht, auf diesen Infrastrukturen eine weitere Frage zu beantworten:
Wenn eine Aufgabe in immer mehr Aufrufe unterteilt wird, wer entscheidet, wohin jede einzelne Anfrage geleitet werden soll?
Die Kosten für das Training fallen oft einmalig an, die Kosten für die Inferenz sind dauerhaft
In den vergangenen Jahren lag die Aufmerksamkeit der Branche fast vollständig auf dem Training – Parameterumfang, Trainingscluster, Ranglistenergebnisse. Das ist sinnvoll, denn dies ist die Phase, die die Obergrenze der Fähigkeiten eines Modells bestimmt.
Aber Training und Inferenz sind zwei völlig unterschiedliche Arten, Geld auszugeben.
Das Training ist wie der Bau eines Kraftwerks: Die Investitionen sind enorm, der Zeitraum ist konzentriert, und nach Abschluss ist es fertiggestellt. Ein Modell wird meist nur einmal trainiert. Die Inferenz hingegen ist wie die Stromübertragung und der Stromverbrauch: Jeder Aufruf, jeder Schritt, den ein Agent ausführt, und der Betrieb jedes Endgeräts verbrauchen in Echtzeit Rechenleistung. Ein Modell wird einmal trainiert, aber die Inferenz findet Milliarden- oder Billionenmal statt.
Diesen Unterschied hat GoodVision AI schon sehr früh erkannt. Der Gründer und CEO David Wang gründete das Unternehmen 2019, um die Lücke in der Infrastruktur zu schließen, die entsteht, wenn KI-Fähigkeiten von der „Demo-Fähigkeit“ zur „skalierbaren Bereitstellung“ übergehen. Nach seinen Aussagen verlagert sich die KI-Infrastruktur allmählich von der Frage „Wo befindet sich die Rechenleistung?“ hin zur Frage „Wie wird jeder Token effizient erzeugt, geroutet und bereitgestellt?“. Während die Branche ihre Aufmerksamkeit auf die Obergrenze der Modellfähigkeiten richtet, konzentriert sich GoodVision AI darauf, wer die Betriebskosten unterhalb dieser Obergrenze verwaltet.
Heute wird diese Einschätzung zu einem Branchenkonsens.
Die von Jensen Huang auf der GTC 2026 vorgelegten Zahlen zeigen, dass der Berechnungsbedarf für KI-Inferenz in den vergangenen zwei Jahren um etwa das Hunderttausendfache gestiegen ist. Dementsprechend überstiegen die weltweiten Kapitalausgaben für KI-Infrastruktur im Jahr 2025 400 Milliarden US-Dollar, und die Prognose für 2026 übersteigt sogar 600 Milliarden US-Dollar – die KI-Infrastruktur ist nicht mit dem Abklingen des Trainingswettbewerbs zu Ende gegangen, sondern ist durch den Ausbruch der Inferenzanforderungen in einen längeren Bauzyklus eingetreten.
Agenten machen die Inferenzkosten zudem komplexer.
Agenten verändern nicht nur den Verbrauch von Token, sondern auch die Art des Verbrauchs. Früher stellte der Nutzer eine Frage, das Modell antwortete einmal; heute muss ein Agent zum Abschluss einer Aufgabe Daten lesen, Tools aufrufen, Ergebnisse prüfen und aufgrund des Feedbacks weitere Maßnahmen ergreifen. Eine Aufgabe wird dadurch in Dutzende oder sogar Hunderte von Modellaufrufen unterteilt.
Token entwickeln sich von „Gesprächsverbrauch“ zu „Systemverbrauch“. Wenn Aufrufe in die Hauptprozesse von Unternehmen einbezogen werden, sind die Kosten keine gelegentlich anfallenden API-Gebühren mehr, sondern werden zu einem Betriebsaufwand, der mit dem Geschäftswachstum stetig ansteigt.
Die wahre Bedeutung davon für Unternehmen lautet: Die Kostenstruktur der KI hat sich von einem einmaligen Einkauf zu einer Rechnung verwandelt, die ständig weiterwächst. Und solange die Rechnung dauerhaft anfällt, ist die Effizienz kein Ingenieursproblem mehr, das man später optimieren kann – es ist vom ersten Tag an ein betriebswirtschaftliches Problem.
Daraufhin beginnt ein scheinbar widersprüchliches Phänomen aufzutreten: Dasselbe Unternehmen kann gleichzeitig mit einem Überangebot an Rechenleistung und einem Mangel an Rechenleistung konfrontiert sein. Hochleistungsrechenleistung wird in Warteschlangen umkämpft, während eine große Anzahl einfacher Aufgaben, die ursprünglich von leichten Modellen lokal in wenigen Dutzend Millisekunden erledigt werden könnten, die teuersten Ressourcen belegen und eine ganze Welt umrunden, bevor das Ergebnis zurückgeliefert wird.
Das eigentliche Problem, das gelöst werden muss, ist die Zuweisung der Rechenleistung: Welche Anfragen sollten Flaggschiff-Modelle verwenden, welche Anfragen können an leichte Modelle übergeben werden und welche Anfragen müssen im lokalen Bereich verbleiben.
Jeder Aufruf ist eine Auswahlentscheidung
Genau das ist die Ebene, die GoodVision AI lösen möchte. David Wang ist seit vielen Jahren in der Cloud-Branche tätig und verfügt über Berufserfahrung bei IBM, AWS, Alibaba Cloud und Tencent Cloud. Er war Partner bei IBM, Mitglied des höheren Managements von AWS, beteiligte sich am Aufbau des frühen Teams von Alibaba Cloud und war später Leiter von Tencent Cloud in Nordamerika.
Diese Erfahrungen lassen ihn sich stärker auf die praktische Anwendung von KI in Unternehmen konzentrieren. Die von Unternehmen eingesetzten Technologien ändern sich ständig – von Cloud-Servern und GPUs bis hin zu Modell-APIs und Agenten –, aber die Anforderung bleibt stets gleich: Nützliche KI-Fähigkeiten zu niedrigeren Kosten und auf stabilere Weise zu erwerben.
GoodVision AI etablierte sich zuerst mit Cloud-Diensten, die das erste Einstiegsportal darstellen, das Unternehmen mit globalen Rechenressourcen verbindet. Angesichts von AWS, Microsoft Azure, Google Cloud sowie den eigenen privaten Clouds und lokalen Rechenzentren der Kunden hilft es ihnen bei der Cloud-Migration, Architekturplanung, Multicloud-Verwaltung, Betrieb und kontinuierlichen Optimierung. Die Kombinationsweise hängt von dem Geschäftsvolumen, den Kosten, der Datensicherheit und den globalen Bereitstellungsanforderungen ab, ohne an einen einzelnen Cloud-Anbieter gebunden zu sein.
Der Wert dieses Geschäftsbereichs zeigt sich zuerst darin, „Unternehmen bei der Umstellung auf die Cloud zu unterstützen“, und lässt GoodVision AI gleichzeitig an die realen Arbeitslasten heranrücken – um zu verstehen, wie die Rechenleistung der Kunden verwendet wird, wofür die Token ausgegeben werden, wo die Latenzen auftreten und wo die Compliance-Grenzen liegen. Das sind Informationen, die externe Anbieter kaum aus Präsentationen erhalten können. Wenn Unternehmen beginnen, große Modelle und Agenten einzuführen, erweitern sich diese Fähigkeiten natürlich auf Modellaufrufe, Cloud-übergreifende Orchestrierung und private Inferenz.
Diese Entscheidungen werden von der Smart Routing Engine getroffen.
Nachdem eine KI-Anfrage in die Plattform gelangt, erkennt das System zuerst die Absicht der Anfrage und weist dann in Echtzeit zwischen verschiedenen Modellen und Rechenressourcen zu, unter Berücksichtigung der Aufgabenkomplexität, der Token-Kosten, der Antwortgeschwindigkeit, der Datensensitivität, der regionalen Compliance und der Verfügbarkeit von Knotenpunkten.
In konkreten Szenarien können komplexe Schlussfolgerungen und Aufgaben mit allgemeinem Wissen an Flaggschiff-Modelle von Cloud-Diensten wie ChatGPT, Claude und Gemini geroutet werden; leichte Aufgaben wie Übersetzung, Zusammenfassung, Kundendienstantworten und wiederholende Verarbeitung werden an kostengünstige kleine Modelle übergeben; Anfragen mit sensiblen Daten oder sehr hohen Anforderungen an geringe Latenz werden an private Modelle des Unternehmens oder Edge-Knotenpunkte übermittelt, um die Datenübertragung zwischen externen Clouds zu reduzieren.
Die Smart Routing Engine unterstützt zudem Aufrufe zwischen Agenten (Agent to Agent, A2A). Wenn ein Agent eine Aufgabe bearbeitet, muss er häufig einen anderen Agenten bitten, Inhalte abzurufen, zu analysieren, zu prüfen oder zu generieren. Das System weist für diesen Aufruf ein geeignetes Modell und einen geeigneten Ausführungsknotenpunkt zu, basierend auf dem Aufgabenziel, der Fähigkeitsabstimmung, den Kosten, der Latenz und den Datenberechtigungen. Auf diese Weise können mehrere Agenten stabiler zusammenarbeiten, um eine Aufgabe zu erledigen.
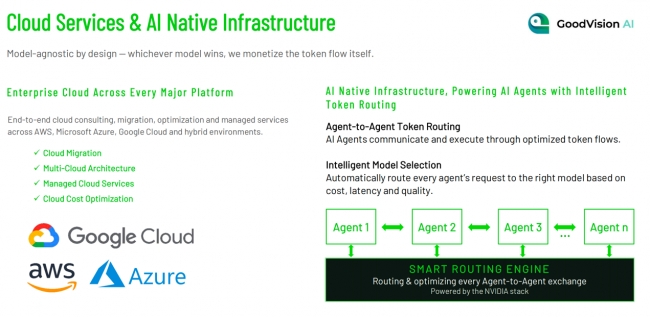
Das Multi-Modell-Routing beantwortet die Frage „Welches Modell soll aufgerufen werden“, und GoodVision AI geht noch eine Ebene tiefer: Wo soll dieses Modell ausgeführt werden? Dasselbe Modell, das in einer öffentlichen Cloud, im Unternehmensrechenzentrum oder an einem Edge-Knotenpunkt bereitgestellt wird, hat völlig unterschiedliche Kosten, Latenzen und Datengrenzen. Die Smart Routing Engine orchestriert daher nicht nur die Modelle, sondern auch den Standort der Rechenleistung, an dem sich die Modelle befinden – sie bietet sowohl einen einheitlichen API-Einstiegspunkt als auch die Ressourcenorchestrierung für das KI-System des Unternehmens: Einfache Aufgaben verwenden leichte Ressourcen, komplexe Aufgaben behalten die erforderlichen Modellfähigkeiten bei; und wenn bei Cloud-Plattformen, Modelldiensten oder Rechenknotenpunkten Schwankungen auftreten, können Anfragen automatisch auf andere verfügbare Umgebungen umgeschaltet werden.
Diese Logik wurde bereits durch das tatsächliche Geschäft bestätigt.
GoodVision AI hat einmal eine Bild- und Videoerstellungsplattform bedient, bei der die monatlichen KI-Ausgaben des Kunden bereits über 500.000 US-Dollar lagen und der Token-Verbrauch weiter mit einer Geschwindigkeit von etwa 50 % pro Monat wuchs. Nach der Migration der entsprechenden Modelle zu GoodVision AI Factory für die private Bereitstellung sanken die Gesamtkosten des Kunden um etwa 60 % und die Netzwerklatenz um etwa 50 %.
Die Art und Weise, wie es „Geld spart“, ergibt sich aus der gleichzeitigen Neuanordnung von Modellen, Rechenleistung und Bereitstellungsstandorten, anstatt einfach nur ein billigeres Modell auszutauschen.
Rechenleistung beginnt, an Orte mit hoher Nutzerdichte zu verlagern
Nachdem eine Anfrage ausgewählt wurde, muss sie an einem physischen Standort landen. Das führt zu dem gewichtigeren Teil des Geschäfts von GoodVision AI.
David Wang hat eine Einschätzung: Die aktuelle KI-Infrastruktur befindet sich noch in einer Phase, die der „Zeit vor dem Aufkommen von CDNs“ ähnelt. Zentralisierte große Clouds eignen sich nach wie vor am besten für Training und komplexe Inferenz, aber wenn Agenten beginnen, Aufgaben wie Übersetzung, Kundendienst, Code, Bild und Video mit hoher Frequenz zu bearbeiten, sollten immer mehr Anfragen von Knotenpunkten erledigt werden, die nah an den Nutzern, den Daten und dem Geschäftsstandort liegen.
Dahinter stehen klare geschäftliche Gründe. KI-Brillen, Roboter, autonomes Fahren und intelligente Fabriken sind extrem latenzempfindlich, und in vielen Szenarien ist es überhaupt nicht zulässig, Anfragen Tausende von Kilometern weit zu senden und dann auf das Ergebnis zu warten; Daten aus Bereichen wie Finanzen, Medizin und öffentliche Verwaltung dürfen oft nicht einmal das Land verlassen.
Die KI-Factory von GoodVision AI ist ein modulares Inferenzzentrum für lokale und regionale Anforderungen. Laut Unternehmensangaben hält sie den PUE-Wert durch Tauchkühlung unter 1,2, kann bis zu 1,5 MW Inferenzrechenleistung auf 200 Quadratmetern Fläche bereitstellen und ist an die Smart Routing Engine angeschlossen, um ein lokaler Knotenpunkt im globalen Orchestrierungsnetzwerk zu werden. Derzeit laufen entsprechende Projekte in Japan, Südkorea und den USA. Die Knotenpunkte in Japan sollen in den nächsten drei Jahren schrittweise erweitert werden, mit einer Gesamtkapazität von 100 MW. Der Expansionspfad des Unternehmens besteht darin, zuerst Flaggschiff-Knotenpunkte mit lokalen Partnern zu bauen und dann Edge-Knotenpunkte in die Umgebung zu bereitzustellen, um dieses Bereitstellungsmodell für Infrastruktur in mehr Regionen zu kopieren.
Es gibt eine Frage, die es wert ist, erläutert zu werden: Der Bau von Rechenzentren ist bekanntermaßen eine aufwändige und langwierige Aufgabe. Wie kann ein Unternehmen, das 2019 gegründet wurde, gleichzeitig Projekte in drei Ländern vorantreiben?
Die Antwort liegt im vergangenen Z