Vom Test mit schwarzem Klebeband zu geräteübergreifenden intelligenten Agenten haben zwei Veteranen im Bereich Sprachtechnologie zehn Jahre gewartet.
Vor vielen Jahren wurde der Zentralbildschirm eines XPeng-Autos dicht mit schwarzem Klebeband abgeklebt.
Bei diesem Medientest konnte der Tester die Oberfläche nicht sehen und den Bildschirm nicht berühren, sondern konnte die Bedienung im Fahrzeug nur durch Sprache durchführen, und der Test verlief schließlich erfolgreich. Zhao Hengyi, der damals für das Sprachgeschäft von XPeng verantwortlich war, erinnerte sich später: „Unserer Auffassung nach ist der Bildschirm nur eine Unterstützung. Der Schlüssel liegt darin, dem Nutzer durch effektive Kommunikation dabei zu helfen, Dinge wirklich zu erledigen.“
Zu dieser Zeit arbeitete die fahrzeuginterne Sprachtechnologie noch daran, Probleme wie Aktivierung, Erkennung und feste Befehle zu lösen. Der Schwarzklebeband-Test trug einen gewissen Eigensinn der Produktmanager in sich und brachte tatsächlich eine langfristigere Frage in den Vordergrund: Wenn der Bildschirm in den Hintergrund tritt, wie versteht die Maschine den Menschen und wie nimmt sie die nächste Anforderung des Menschen auf?
Viele Jahre später hat das Large Language Model diese Frage wieder an die Oberfläche gebracht. Maschinen beginnen, Semantik zu verstehen, Unterbrechungen zu akzeptieren und Tools aufzurufen, und die KI erstreckt sich entlang des Chatfensters in die reale Welt. Im Jahr 2025 übernahm OpenAI das io-Team, das von Jony Ive und anderen gegründet wurde; anschließend übernahmen Amazon und Meta das Unternehmen für umgebungsbezogene KI-Geräte Bee und das Unternehmen für tragbare Geräte Limitless.
Das Ziel hinter dem Kampf dieser Giganten um Hardware ist mehr als klar – Wie baut KI eine vollständige Szenenverbindung zum Nutzer auf und erhält fortlaufend Kontext außerhalb des Chatfensters?
„Die Verbindung zwischen KI und Mensch sollte alle Szenarien abdecken“, sagte Zhao Hengyi gegenüber 36Kr. Wenn der Mensch aus dem Auto ins Büro und dann nach Hause kommt, ändern sich die Geräte um ihn herum ständig, aber dasselbe intelligente Wesen sollte ihn immer noch erkennen, die vorherigen Erinnerungen fortsetzen und die Fähigkeiten des vorliegenden Geräts nutzen.
Die unsichtbare und unberührbare Stimme übernimmt in diesem Prozess die Kernrolle der vernetzten Interaktion. Sie kann den Menschen bei der Bewegung begleiten, hat eine hohe Eingabegeschwindigkeit und trägt zudem Zögerlichkeit, Gewissheit, Pausen und Emotionen in sich. Zhao Hengyi beschreibt, dass Sprache „so natürlich wie Luft und Wasser“ ist, weshalb sie lange Zeit unterschätzt wurde.
Hojo, das Ende 2024 gegründet wurde, schneidet genau durch diese unscheinbare Lücke ein und positioniert sich als KI-Stack für intelligente Hardware.
Gründer und CEO Zhao Hengyi hat nacheinander bei LeEco, AISpeech, XPeng, NIO und SenseTime an Sprachplattformen, Robotern, intelligenten Fahrerkabinen und AgentOS gearbeitet. Mitbegründer und Chefwissenschaftler Su Dan arbeitete von Baidu über Didi bis zu Tencent AI Lab und erlebte den gesamten Zyklus der Spracherkennung, die sich von der Nahbereichsaufnahme über Mobiltelefone zur Fernbereichsaufnahme, zu Multimodalität und großen Sprachmodellen entwickelte.
Zhao Hengyi und Su Dan kennen sich seit fast zehn Jahren in der Sprachbranche. Ersterer bewegte sich in Richtung Produkt, Hardware und Lieferkette, Letzterer vertiefte sich in Modell, Akustik und Technik. Bis zum Einzug des Large-Language-Model-Zeitalters trafen sich ihre beruflichen Wege schließlich am Kreuzungspunkt von Hojo.
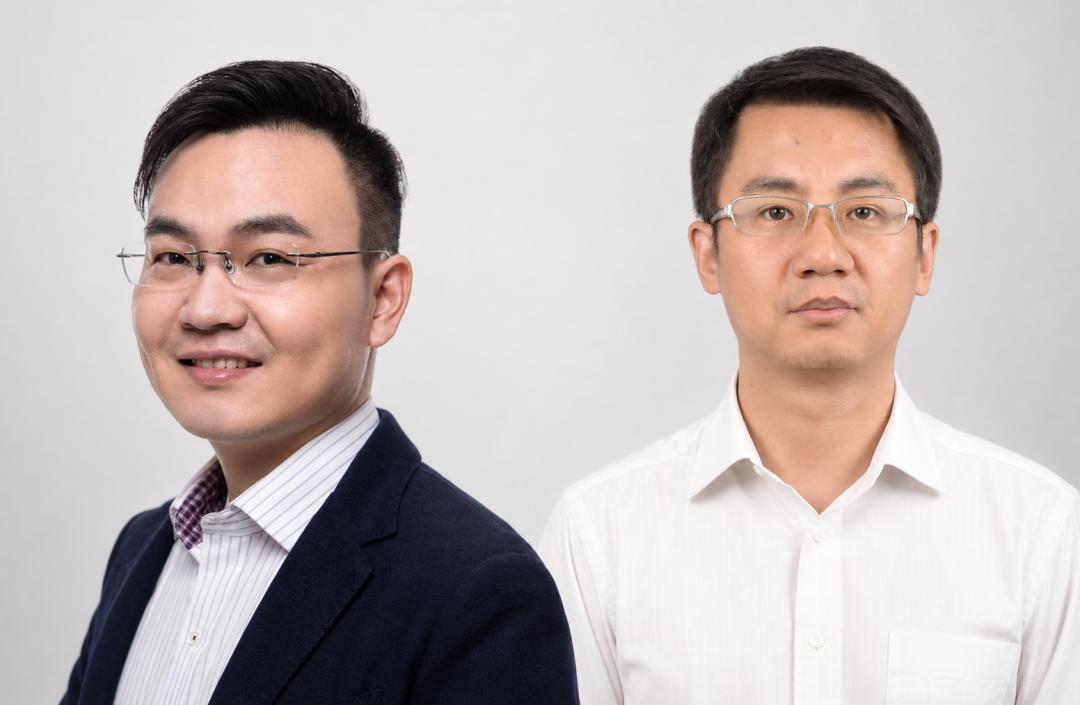
Links: Zhao Hengyi, Rechts: Su Dan
Sie wollen gemeinsam eine Frage beantworten: Wie kann KI, nachdem sie das Chatfenster verlassen hat, in echte Hardware eindringen und dort einen Menschen fortlaufend verstehen?
01 Zwei Sprachveteranen treffen sich endlich im Large-Language-Model-Zeitalter
Zhao Hengyi arbeitet seit fast zehn Jahren im Bereich Sprache.
In den letzten zehn Jahren haben sich die technologischen Wellen mehrfach gewandelt – von intelligenten Lautsprechern im Zeitalter des mobilen Internets und des IoT über die Intelligentes-Auto-Entwicklung bis hin zu den heutigen Large Language Models. Es ist erstaunlich, dass sein beruflicher Weg nie von der Sprache abgewichen ist.
Bei AISpeech war er für die DUI-Plattform verantwortlich und eröffnete 2018 das Konferenzgeschäft; bei XPeng brachte er Sprache in Autos und Roboter; bei NIO lernte er anhand von NOMI, dass Nutzer eine emotionale Bindung an ein Interaktionsobjekt mit Stimme, Ausdruck und Persönlichkeit aufbauen.
Zhao Hengyi ist der Ansicht, dass der Wert der Sprache nie nur in der Eingabegeschwindigkeit liegt. Zögerlichkeit, Pausen, Gewissheit und Emotionen sind alle in der Stimme verborgen, und diese Informationen lassen sich kaum durch einen bearbeiteten Text vollständig bewahren.
Diese Überzeugung von der Sprache stammt von einem Satz aus seiner Studienzeit – „Ohne Stimme kann selbst das beste Stück nicht wirken.“ Er liebt Musik und Hi-Fi, weshalb er den visuellen Bereich aufgab und im Labor Sprache und Audio erforschte. In gewisser Weise legte dies auch seine spätere Produktauffassung fest: Wenn KI in die reale Welt eintritt, ist Sprache nach wie vor die natürlichste und informationsreichste Kommunikationsweise zwischen Mensch und Maschine.
Der berufliche Werdegang von Su Dan gleicht eher einem Abbild der Sprachtechnologie.
Er ist ein typischer Technikexperte aus großen Technologieunternehmen. Während seiner Doktorarbeit an der Peking University erforschte er Spracherkennung. Als er zu Baidu kam, brachten Smartphones gerade die Sprachsuche und Eingabemethoden zu echten Nutzern; später bei Didi und Tencent erstreckte sich seine Arbeit von der Spracherkennung auf multimodale Sprachinteraktion und große Sprachmodelle, wobei er sich auf Probleme wie die Integration mehrerer Sprachen, die Optimierung vertikaler Bereiche sowie Streaming- und Vollduplex-Erlebnisse konzentrierte.
Die Spracherkennung ist einer der ersten Bereiche, in denen Deep Learning eine großtechnische industrielle Anwendung erreicht hat. Heute vereinen Large Language Models die ursprünglich verteilten Fähigkeiten wie Erkennung, Synthese und Dialog wieder. Diese Runde von Veränderungen wirkt sich auf die Technikexperten in großen Unternehmen weit stärker aus als erwartet.
Tatsächlich verändern Large Language Models die Art und Weise, wie diese Technikexperten Organisationen betrachten.
Die früher getrennten technologischen Richtungen laufen schnell zusammen: Modell, Daten, Rechenleistung und Geschäft müssen neu koordiniert werden, aber die Ressourcen großer Unternehmen lassen sich kaum synchron mit dem technologischen Weg bewegen. Su Dan wünscht sich, „in einer flexibleren Organisation Ressourcen zuzuweisen und Arbeiten voranzutreiben“ und dass die Technik früher mit echten Anwendungen in Berührung kommt. Zhao Hengyi, der ebenfalls bei mehreren Automobilherstellern tätig war, litt unter organisatorischen Prozessproblemen: Bei der Förderung bereichsübergreifender Projekte in großen Unternehmen verbrachte er viel Zeit mit Erklärungen, Koordination und der Beantragung von Ressourcen, und einige Entscheidungen wurden erst nach Monaten umgesetzt.
Ihre beruflichen Wege haben sich schon früher gekreuzt, aber sie haben nie wirklich zusammengearbeitet. Nach dem Aufstieg der Large Language Models wurden Modell, Daten, Produkt und Hardware in dasselbe System gedrängt, und die beiden einigten sich klar auf die gemeinsame Unternehmensgründung: Sprachmodell, Produkterlebnis und Hardware-Engineering in dasselbe Unternehmen zu bringen und einen vollständigen KI-Stack für intelligente Hardware aufzubauen.
Ende 2024 wurde Hojo registriert und gegründet. Die Aufteilung der Aufgaben nach der Gründung folgt den Stärken der beiden: Zhao Hengyi steht näher an Nutzern, Produkten, Kunden und Lieferkette, während Su Dan dafür verantwortlich ist, die Anforderungen in Akustik-, Modell- und Ingenieursketten zu zerlegen. Su Dan bewertet das Produktintuition von Zhao Hengyi so: „Er denkt zuerst klar über Nutzer und Produkt nach und leitet dann ab, welcher Teil der Technik ergänzt werden muss.“
Das ist auch das erste Mal, dass die beiden den Namen Hojo vollständig nach außen erklären: Er stammt aus den Anfangsbuchstaben der englischen Namen der beiden Gründer. Das Team hat HOJO zudem die Bedeutung von Holistic Omni Joint Operator gegeben, was jeweils Ganzbereich, Multimodalität, Geräteübergreifendheit und Interaktionssystem repräsentiert. Ein Name verbindet die Aufgabenteilung der beiden und die Ziele des Unternehmens.
Wie die Aufgabenteilung der beiden in diesem Interview beantwortet Zhao Hengyi mehr Fragen zu Nutzern, Produkten, Kunden und Lieferkette; wenn das Thema in die akustische Vorverarbeitung, die Modellgrenzen oder die Hardwarelebensdauer eintritt, übernimmt Su Dan die Antwort. Die beiden legen selten Emotionen dar und zerlegen Probleme normalerweise direkt in technische Bedingungen und kommerzielle Einschränkungen.
Zu Beginn der Gründung beschlossen die beiden, gleichzeitig in ASR, kleines TTS und natives Vollduplex-Sprachmodell zu investieren. Su Dan führt diese drei Richtlinien auf „die von der Produktseite erzwungenen Anforderungen“ zurück: Geräte benötigen ein stabiles, latenzarmes und kostengesteuertes Modellschema. Darunter wurde das große native Vollduplex-Sphemotionsdialogmodell ursprünglich von ihm vorgeschlagen und vorangetrieben. Er ist der Ansicht, dass die nächste Generation von Sprachinteraktion nicht auf dem Zyklus „Du sprichst zu Ende – ich erkenne – ich antworte“ verbleiben darf, sondern Nutzer jederzeit unterbrechen lassen soll, sodass das Modell gleichzeitig zuhören, nachdenken und sprechen kann.
Die drei Modelllinien stehen auch nicht isoliert voneinander. Sie teilen sich die Datenbereinigungs- und Erweiterungspipeline, das Trainingsframework und das Bewertungssystem. ASR-Annotationen und TTS-Synthesedaten speisen zudem das Vollduplex-Training zurück. Su Dan sagt, dass die „Sprachpipeline“ als eigenständige Industrie verschwindet, aber die Sprachfähigkeit als zugrundeliegendes Organ des intelligenten Wesens nur wichtiger wird, insbesondere in den beiden Hauptrichtungen Mensch-Maschine-Dialog und Inhaltserstellung.
Mit anderen Worten: Allgemeine Modelle können grundlegende Fähigkeiten aufnehmen, aber Probleme wie Streaming-Umgestaltung, Anpassung an vertikale Bereiche, Leichtgewichtigung großer Modelle und Beschleunigung der Inferenz müssen in echten Geräten gelöst werden. Erinnerungen, Aufgabenausführung, Apps und Abonnements entstehen nicht automatisch durch die Anbindung einer API.
Für ein Startup-Unternehmen ist das gleichzeitige Setzen auf drei Modelllinien eine große Investition. Aber Su Dan urteilte damals, dass je stärker das allgemeine Modell ist, desto enger der Raum für den separaten Verkauf von ASR- oder TTS-Fähigkeiten; was Hojo wirklich beherrschen muss, sind die Teile, die stark mit Hardware und Produkterlebnis gekoppelt sind, sowie der lange Weg des Modells nach dem Eindringen in Geräte.
Im Juni 2026 machte Hojo Hojo-ASR-V1 quelloffen und belegte im gemessenen Ranking der Hugging Face Open ASR Leaderboard den zweiten Platz, direkt hinter Microsoft. Sein kleines Hojo-TTS-Light-40M hat nur 40 Millionen Parameter, und die erste Tonantwort des Vollduplex-Modells erreicht die Größenordnung von 100 Millisekunden. Diese Indikatoren decken nur einen Teil der technologischen Kette ab, aber Hojo will das Problem lösen, ob eine Stimme nach dem Eindringen in das Gerät stabil verstanden, in Aktionen umgewandelt und zu einer Erinnerung abgelagert werden kann, die für die nächste Interaktion aufrufbar ist.
02 Von einem Auto zu mehr Geräten
Zhao Hengyis Vorstellung von einem geräteübergreifenden intelligenten Wesen ist kein plötzlicher Einfall, sondern die fortlaufende Entwicklung aus mehreren Erfahrungen bei Automobilherstellern.
Bei XPeng dachte er zum ersten Mal ernsthaft darüber nach, wie Sprache in die physische Welt eindringen kann. Autos und Roboter erfordern beide, dass das System den Menschen außerhalb des Bildschirms versteht. Genau das wurde durch den damaligen Schwarzklebeband-Test überprüft: Ob Sprache Aufgaben unabhängig erledigen kann.
Bei NIO sah er anhand von NOMI, dass Nutzer eine emotionale Bindung an ein Interaktionsobjekt mit Stimme, Ausdruck und Persönlichkeit aufbauen. NIO arbeitete damals auch an Mobiltelefonen, und Zhao Hengyi wünschte sich, dass NOMI auf mehreren Endgeräten erscheint, sodass Nutzer überall weiter interagieren können.
Aber die Fähigkeitsgrenzen eines Automobilherstellers lassen sich kaum auf alle Lebensszenarien außerhalb des Fahrzeugs ausdehnen. „Wenn ich die Chance habe, ein Unternehmen zu gründen, sollte ich mich nicht nur auf das Fahrzeug beschränken“, erinnerte sich Zhao Hengyi. Genau zu dieser Zeit begann er sich vorzustellen, die Verbindung zwischen KI und Mensch von der Fahrerkabine auf breitere Lebensszenarien auszudehnen – diese Vorstellung wurde später der Ausgangspunkt für die Gründung von Hojo.
Später, als er an AgentOS arbeitete, trieb er diese Überlegung weiter in Richtung Geräteübergreifendheit: Derselbe Agent sollte wissen, was der Nutzer auf verschiedenen Endgeräten getan hat, und auch verstehen, ob das vor ihm stehende Gerät aufnehmen, ansagen oder Text anzeigen kann. Nach der Registrierung von Hojo im Jahr 2024 breitete das Team nicht sofort alle Szenarien aus, sondern kehrte zuerst zur vertrauten intelligenten Fahrerkabine zurück, um das erste Kernprojekt voranzutreiben.
Autos ähneln einem Hochdrucklabor für Sprachtechnologie. Im Fahrzeug gibt es gleichzeitig Gespräche mehrerer Personen, Windgeräusch, Reifengeräusch und schwaches Netzwerk, und das System muss zudem geringe Latenz und hohe Stabilität erfüllen. Eine solche Umgebung koppelt die Fähigkeiten der beiden aneinander – Su Dan befasst sich seit langem mit Fernbereichssprache und komplexer Akustik und ist mit Mikrofonarrays, Vorverstärkung und Robustheit in geräuschvollen Umgebungen vertraut; Zhao Hengyi kennt sich besser mit Produktdefinition, Kundenanforderungen und Serienproduktionslieferung aus.
Nach Angaben von Hojo hat das Unternehmen einem großen Automobilkunden bereits einige Funktionen geliefert, und einige Fähigkeiten sind bereits in Fahrzeugen implementiert. Statt schnell mehr Großkundenprojekte zu replizieren, ist Zhao Hengyi eher bereit, einen Schlüsselkunden zu einem Benchmark zu machen. Wenn Projekte zu schnell ausgeweitet werden, werden die Ingenieure auf verschiedene Anforderungen aufgeteilt, und die Entwicklungsressourcen werden zersplittert. Für ein Startup mit begrenzten Ressourcen ist es besser, ein Kernprojekt zu einem Benchmark zu machen, als nur die Anzahl der Verträge zu erhöhen, um die Fähigkeiten zu prüfen.
Zhao Hengyi hat schon früh Erfahrungen mit der Kombination von Software und Hardware im Bereich der Unterhaltungselektronik gesammelt, und das Automobilprojekt hat seine Fähigkeiten in komplexer Akustik, schwachem Netzwerk, geringer Latenz und Serienproduktion weiter gestärkt. Heute werden diese Fähigkeiten wieder auf Kopfhörer, Aufnahmegeräte und tragbare Hardware übertragen. Die akustischen Strukturen, Bluetooth-Verbindungen, Firmwares und Apps verschiedener Geräte sind unterschiedlich, aber Fernbereichsaufnahme, latenzarme Interaktion, Kollaboration von Ende und Cloud und Erfahrungen in der Serienproduktion können wiederverwendet werden.
Die Schwierigkeit, die Hojo überwinden muss, liegt darin, wie das von