Kimi K3, der dem DeepSeek am ähnlichsten ist, hat den entscheidenden Schlag nicht kopiert.
K3 ist plötzlich zum Mittelpunkt der Aufmerksamkeit geworden.
Zuerst war es Musk.
In den frühen Morgenstunden des 17. Juli nach Peking-Zeit antwortete Musk unter einem Bewertungsbeitrag zu Kimi K3 auf Artificial Analysis mit „Impressive“. Am nächsten Tag erklärte er im Gespräch über das von xAI trainierte Modell mit 2 Billionen Parametern, dass es „möglicherweise Kimi übertreffen“ werde.
Daraufhin schickte Moonshot Kimi auf Weibo eine offene Botschaft: „Willkommen im „2-Billionen-Plus“-Club“.
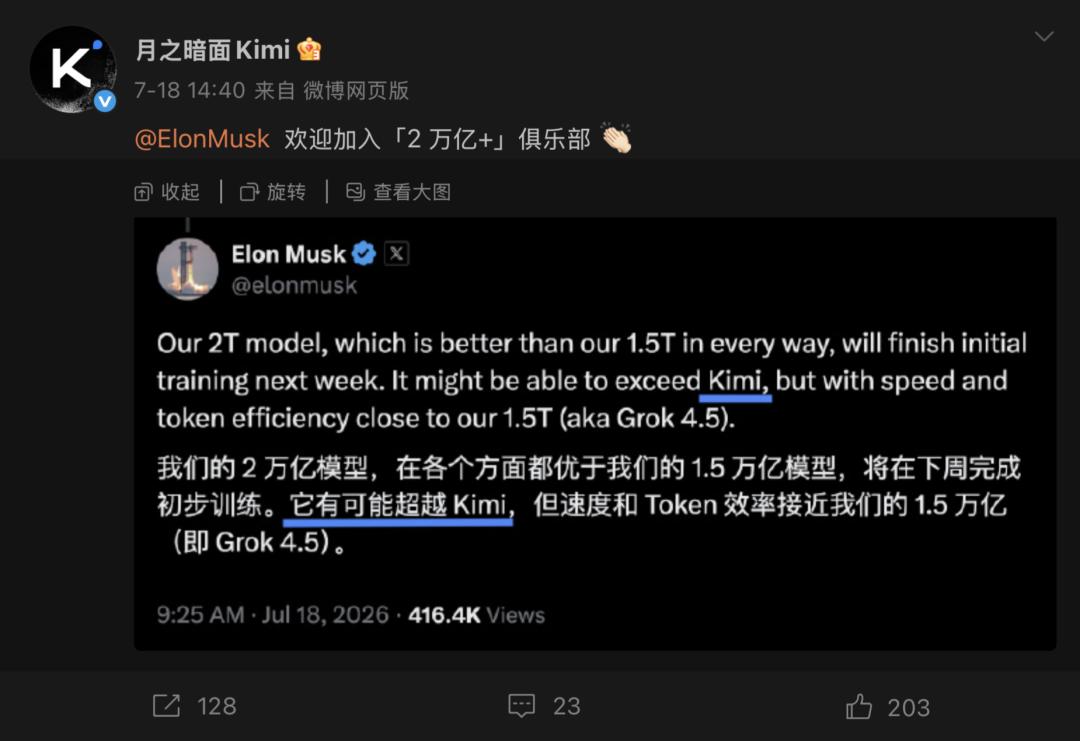
Screenshot von Weibo
Warum der „2-Billionen-Plus-Club“?
Am Abend des 16. Juli veröffentlichte Moonshot das neue große Modell Kimi K3, wobei „2 Billionen Plus“ den Bereich der Parametergröße von K3 angibt. Nach Angaben von Moonshot erreicht Kimi K3 eine Parametergröße von 2,8 Billionen, ein Kontextfenster von 1 Million Token, unterstützt nativ visuelles Verständnis, ist mit dem selbst entwickelten KDA-Aufmerksamkeitsalgorithmus ausgestattet und aktiviert 16 von 896 Experten für jedes Token.
Die Diskussion über Kimi K3 beschränkt sich nicht auf soziale Medien im Ausland.
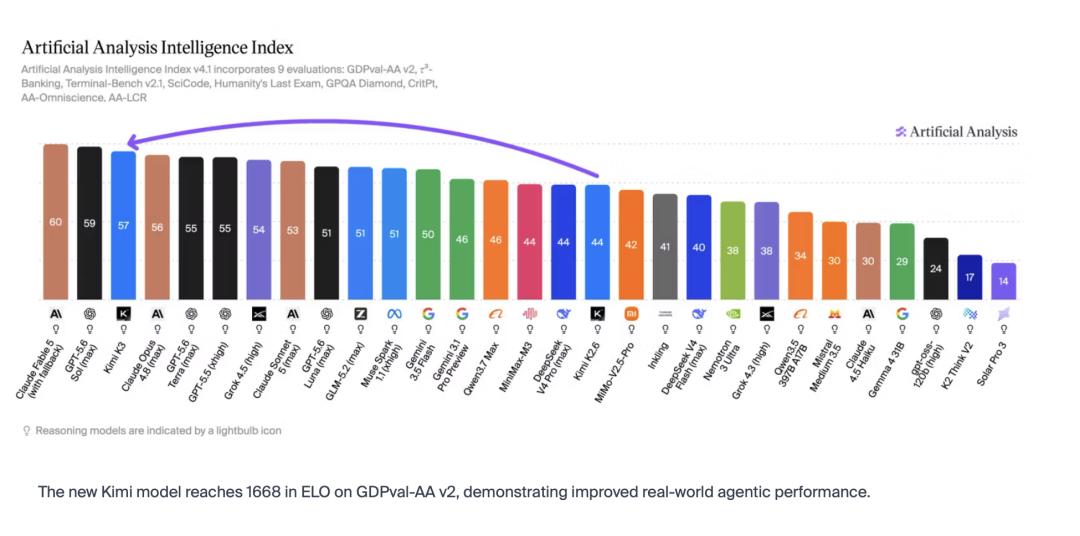
Anastasios Angelopoulos, Mitbegründer und CEO von Arena, erklärte in einem Medieninterview, dass dies möglicherweise die größte Modellveröffentlichung in diesem Jahr sei. Gleichzeitig belegte K3 den ersten Platz in der Frontend Code Arena und den dritten Platz bei der Veröffentlichung des Artificial Analysis Intelligence Index.
Der Mangel an Rechenleistung hat dem Durchbruch von K3 zusätzlich Auftrieb gegeben.
Am Abend des 19. Juli veröffentlichte Kimi, der KI-Assistent von Moonshot, die „Erklärung zum Mangel an Rechenleistung und zur vorübergehenden Aussetzung der Mitgliedschaftsregistrierung“ und kündigte an, die Abonnements neuer Endnutzer ab sofort auszusetzen, die gesamte verfügbare Rechenleistung zur Gewährleistung der Rechte bereits abonnierter Nutzer einzusetzen und die Kapazitätserweiterung mit voller Geschwindigkeit voranzutreiben.
In der aufgeheizten Stimmung tauchten in den Diskussionen über K3 Themen wie „das nächste DeepSeek“ und „DeepSeek-Moment 2.0“ auf. Tatsächlich war die Lizenz zum Zeitpunkt der Drucklegung noch nicht offengelegt, und der vollständige technische Bericht wurde ebenfalls noch nicht veröffentlicht.
Wenn man die beiden jedoch nebeneinander vergleicht, zeigen sich sofort Unterschiede. Laut Messungen von Artificial Analysis kostet K3 durchschnittlich 0,94 USD für die Erledigung einer gewichteten Bewertungsaufgabe, während DeepSeek V4 Pro im gleichen Maßstab etwa 0,04 USD kostet. K3 ist in den weltweiten Spitzenvergleich eingetreten, hat aber den entscheidenden Schlag von DeepSeek nicht wiederholt.
1
Es sieht tatsächlich wie DeepSeek aus dem Jahr 2025 aus
Der durch K3 erzeugte Schock rührt vor allem davon her, dass sich seine Vergleichsobjekte plötzlich geändert haben.
Nach Angaben von Moonshot verfügt K3 über 2,8 Billionen Gesamtparameter, natives Sehen und einen Kontext von 1 Million Token, wobei jedes Token 16 von 896 Experten aktiviert. Artificial Analysis vergab 57 Punkte und platzierte es bei der Veröffentlichung auf dem dritten Platz; in der Bewertung realer Wissensarbeit GDPval-AA v2 erzielte es 1668 Elo, höher als Claude Opus 4.8 und GPT-5.5, niedriger als Claude Fable 5; in der Langzeit-Wissensarbeitsbewertung AA-Briefcase lag es bei der Veröffentlichung direkt hinter Fable 5.
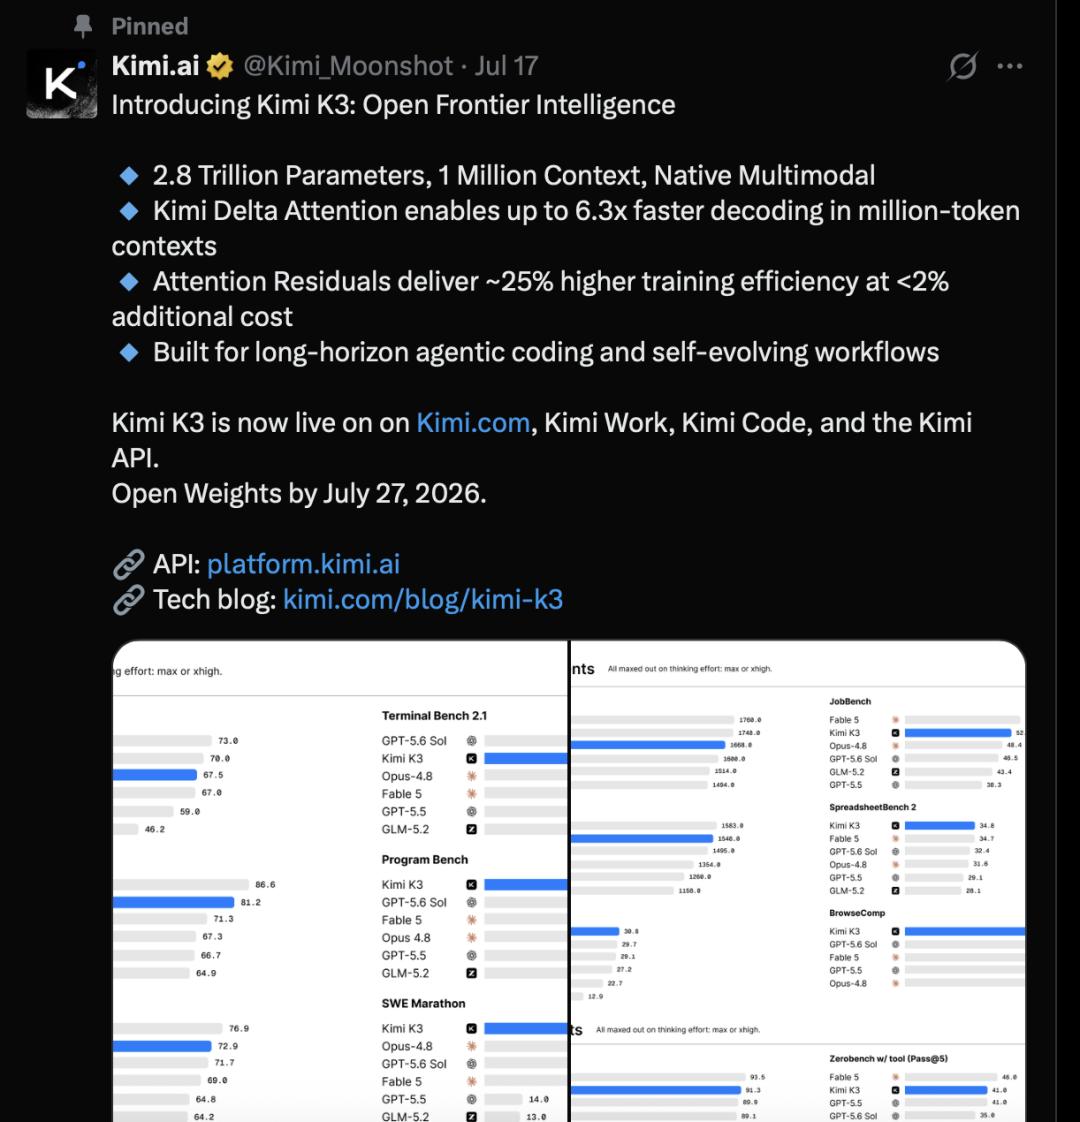
Screenshot von X
„Obwohl seine Gesamtleistung immer noch hinter den leistungsstärksten proprietären Modellen Claude Fable 5 und GPT 5.6 Sol zurückbleibt, zeigt Kimi K3 in unserem Bewertungssatz eine Spitzenleistung und übertrifft durchweg alle anderen getesteten Modelle“, heißt es in dem Bericht „Kimi K3: Open Frontier Intelligence“.
Diese Platzierungen sind mit Grenzen verbunden.
Bis zum 21. Juli ist K3 von dem dritten Platz bei der Veröffentlichung auf den vierten Platz gerückt. Die Frontend Code Arena misst die Visualisierung, Interaktion und Nutzerpräferenz von Frontend-Seiten, was nicht der gesamten Codierfähigkeit entspricht.
Diese Änderungen können jedoch nicht leugnen, dass Kimi einen Identitätswechsel vollzogen hat: K3 ist nicht mehr nur „ein Modell mit guter Leistung unter inländischen Modellen“, sondern tritt direkt in den weltweiten Vergleich ein, der von Fable, GPT und Opus gebildet wird.
Eine intuitive Änderung besteht darin, dass die Aufmerksamkeit von K3 auf Yang Zhilin selbst übergeht.
Nach der Veröffentlichung von K3 gratulierte sein Doktorvater Russ Salakhutdinov öffentlich auf X; viele Medien veröffentlichten nacheinander seine Charakterporträts, und ausländische Technologiemedien schrieben sogar einen separaten Artikel über die Namensgebung der Konferenzräume von Moonshot.
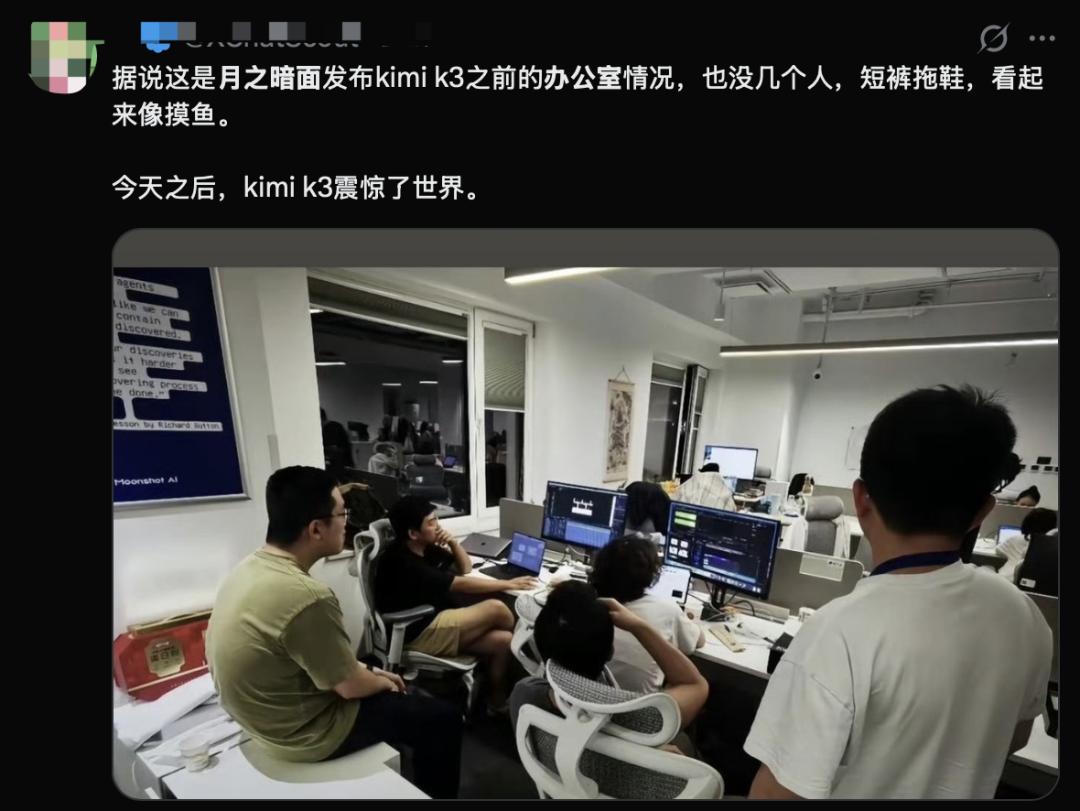
Screenshot von X
Nach seinem Abschluss an der Tsinghua-Universität im Jahr 2015 ging er an die Carnegie Mellon University, um zu promovieren, und beteiligte sich an Forschungen zu Transformer-XL und XLNet, bis er 2019 seinen Abschluss machte. Ein Medium berichtete, dass Yang Zhilin während seiner Promotionszeit an der Carnegie Mellon University dafür bekannt war, Rockbands wie Pink Floyd zu mögen. Diese persönliche Vorliebe fand später auch Eingang in die Firmennamen: „The Dark Side of the Moon“ stammt aus dem gleichnamigen Album von Pink Floyd, und Kimi ist der englische Name von Yang Zhilin.
Pink Floyd veröffentlichte 1973 ein Album mit dem Titel „The Dark Side of the Moon“, dessen Titel genau „Die dunkle Seite des Mondes“ bedeutet.
All dies lässt leicht Assoziationen im Stil von DeepSeek aufkommen: ein junger Forscher, keine große Internet-Firma, die durch Architekturinnovationen an die Spitze vorstößt und durch eine konzentrierte Veröffentlichung in die globale Öffentlichkeit eintritt.
Ähnliche Auftrittsweisen bedeuten jedoch nicht die gleichen geschäftlichen Maßnahmen. Was Kimi anstrebt, war schon immer klar: Es ist nicht das nächste „DeepSeek“.
Am 25. März hielt Yang Zhilin auf der Plenarsitzung des Jahrestreffens des Zhongguancun-Forums 2026 eine Rede mit dem Titel „Open-Source-KI: Die Erkundung der Intelligenzobergrenze beschleunigen“, in der er Kernurteile über die Entwicklung großer Modelle vorbrachte und die neueste technische Route und den Branchenwert von Kimi systematisch erläuterte. Währenddessen fasste er die Expansionsrichtungen von Moonshot in drei Punkte zusammen: die Verbesserung der Token-Effizienz, die Verlängerung des Kontexts und die Organisation von Agent-Clustern.
Weniger als vier Monate später ist K3 fast die Verkörperung dieser drei Urteile.
2
Das Ziel von Kimi ist es, entlang eines Threads weiterzuarbeiten
Die Token-Effizienz löst das Kostenproblem, der lange Kontext löst das Kapazitätsproblem, und der Agent-Cluster durchbricht den Engpass der sequenziellen Ausführung. Die von Yang Zhilin geplante Entwicklungsrichtung für Moonshot zielt gemeinsam auf ein Ziel ab: Der Wettbewerb um Modelle verlagert sich von „einer einzelnen Antwort“ zu „einem kontinuierlich laufenden Aufgaben-Thread“.
In früheren verwandten Artikeln von Heshi Caijing wie „Tencent, Alibaba, Byte machen Office noch einmal neu“, „OpenAI findet einen neuen Job für Codex“ und „Die „Vorwelle“ WPS kämpft um die Lieferrechte“ wurde dieser Trend erörtert – der KI-Wettbewerb soll sich von „Frage und Antwort“ zu „Aufgabenausführung und -lieferung“ wandeln.
Das Ende eines Chats ist eine Antwort, das Ende einer Arbeit ist jedoch ein Ergebnis, das weiterverwendet werden kann. Dieser Assistent, der einst die Funktionen „Beratung“ und „Suche“ erfüllte, muss nun noch weiter zur Arbeit gehen.
Daraus ergeben sich natürlich neue Anforderungen an ihn. Zum Beispiel muss er bei der Erledigung von Aufgaben das Ziel im Auge behalten, Dateien und Webseiten lesen, im Prozess natürlich auch Terminal und Browser aufrufen und Zwischenergebnisse speichern. Im Vergleich zu früher ist dieser Prozess länger und komplexer geworden.
Wenn dieser Assistent in einem Schritt einen Fehler macht, muss er wissen, wo er wieder anfangen kann, anstatt den Nutzer von vorne beginnen zu lassen. Wenn er während der Arbeit eine wichtige Anforderung oder Einschränkung vergisst, war das früher vielleicht nur ein kleiner Mangel im Erlebnis, heute kann es jedoch eine vollständige Wiederholung der gesamten Arbeit bedeuten.
Ein Kontext von 1 Million Token ist jedoch nicht gleichbedeutend mit einem langen Thread. Ein längeres Kontextfenster ist wie ein ausreichend großer Arbeitstisch, der bestimmt, wie viele Materialien man auf einmal ausbreiten kann; ein langer Thread hingegen ist ein kontinuierlich voranschreitendes Projekt, das zudem von Zustandsspeicherung, Werkzeugrückmeldung, Aufgabenzerlegung und Fehlerwiederherstellung abhängt.
Das Besondere an K3 ist, dass es wie DeepSeek die Strategie durch Technologie sichtbar gemacht hat.
Zum Beispiel behandelt KDA zuerst das Problem, warum lange Aufgaben immer teurer werden.
Im Oktober 2025 veröffentlichte das Kimi-Team die zugehörige Studie mit dem Titel „Kimi Linear: An Expressive, Efficient Attention Architecture“. In diesem Papier wurde bereits eine gemischte Aufmerksamkeitsarchitektur aus KDA und MLA verwendet. Bei einem Versuchsmodell mit 48 Milliarden Gesamtparametern und 3 Milliarden Aktivierungsparametern berichtet das Papier über eine maximale Reduzierung des KV-Caches um 75 %, und die Decode-Throughput bei 1 Million Token erreicht etwa das 6-fache des gesamten MLA-Baselines.
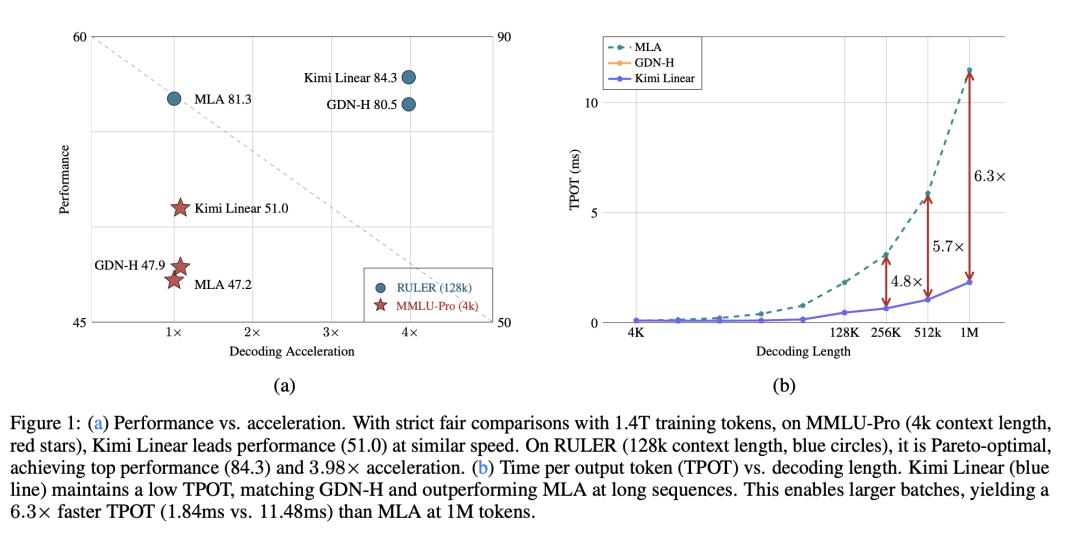
Das ist natürlich kein tatsächlicher Messwert von K3, zeigt aber, dass wenn die Kosten für das Lesen und Speichern von Verlaufsdaten nicht gesenkt werden können, je länger der Thread ist, desto schwieriger ist es, das Produkt funktionsfähig zu machen.
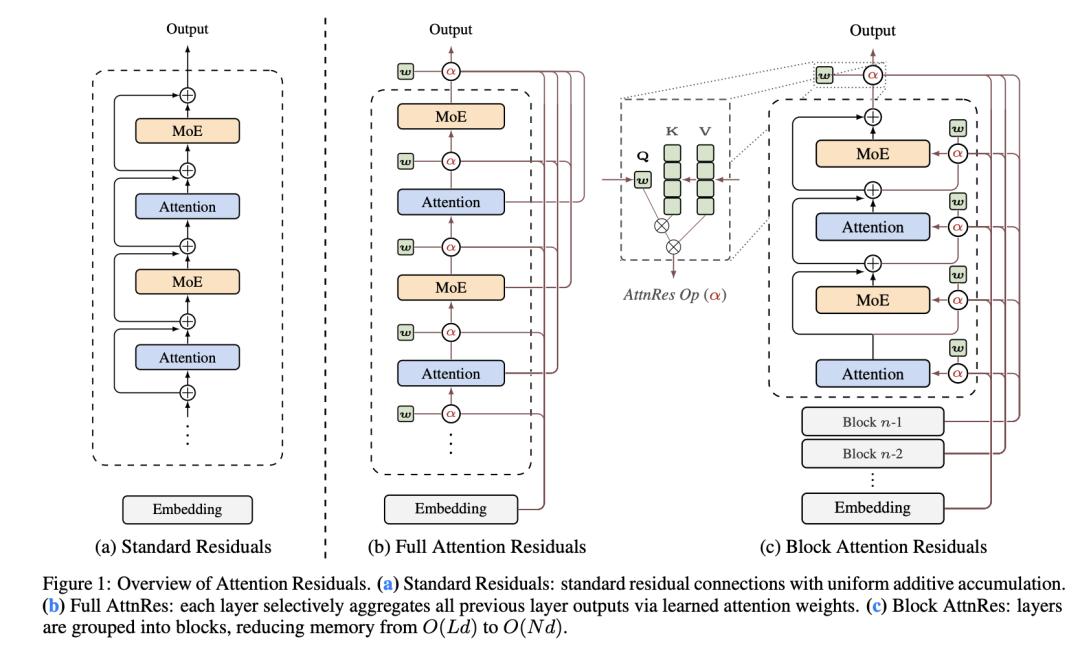
Attention Residuals behandeln das Problem der Informationsverdünnung in der Tiefe des Netzwerks.
Verwandte Arbeiten zeigen, dass das Modell Darstellungen früherer Schichten nach Eingabe auswählen kann, anstatt sie schichtweise fest zu addieren. Die Validierung stammt ebenfalls aus dem 48B-Modell. Man kann daraus nicht behaupten, dass „Agent das Ziel nie vergisst“, es zeigt nur, dass es einen stabileren internen Informationsfluss für extrem tiefe Modelle bietet.
Außerdem gibt es Stable LatentMoE.
Es ermöglicht, dass jedes Token nur 16 von 896 Experten aktiviert, und trennt die Gesamtkapazität von der einzelnen Berechnung. Moonshot gibt an, dass diese Architekturen und Trainingsrezepte die Erweiterungseffizienz insgesamt auf etwa das 2,5-fache von K2 steigern. Zum Zeitpunkt der Drucklegung wurde der technische Bericht noch nicht veröffentlicht, sodass die Beiträge der einzelnen Komponenten noch nicht getrennt ermittelt werden können.
Ein leistungsfähigeres Einzelmodell beseitigt jedoch nicht die Einschränkungen der sequenziellen Ausführung.
Kimi führte Agent Swarm ab K2.5 ein und erweiterte es bis zum K2.6 im April 2026 auf bis zu 300 Sub-Agenten und mehr als 4000 Werkzeugaufrufe. Laut offiziellen Angaben ist die Geschwindigkeit der Massensuche im Vergleich zu einem einzelnen Agenten um bis zu 4,5-fach erhöht, und der aktuelle Cluster wird von K3 angetrieben. Jeder Sub-Agent behält seinen eigenen Kontext und berichtet dem Koordinator nur über wichtige Schlussfolgerungen. Das heißt, Moonshot verlängert nicht nur den Thread, sondern plant auch, ihn zu einer temporär organisierten Mannschaft aufzuteilen.
Das Produkt entwickelt sich ebenfalls in die gleiche Richtung.
Kimi Work, das am 3. Juni als Beta-Version veröffentlicht wurde, nutzt Kimi Code als Kern, integriert lokale Dateien, WebBridge, Fähigkeiten und Zugriffssteuerung auf den Desktop. Es kann Ziele systematisch zerlegen, Werkzeuge aufrufen und schließlich Dokumente, Tabellen, Präsentationen oder Code liefern.
K3 wurde gleichzeitig in Kimi.com, Kimi Work, Kimi Code und API integriert. Das bedeutet, dass Kimi von einem Basismodell zu einer Laufzeitumgebung und einem Eingangspunkt für Arbeit übergeht.